AI-контент сам по себе не проблема. Проблема начинается там, где AI используют как станок для производства одинаковых страниц без мысли, проверки и пользы. Технически статья есть. Заголовки есть. Подзаголовки есть. Даже FAQ есть. Но читатель открывает материал и понимает, что перед ним аккуратно оформленная пустота. Такая цифровая манная каша: вроде еда, но радости мало.
Google не говорит «AI нельзя». Google говорит о другом: контент должен быть полезным, надёжным, созданным для людей, а не для манипуляции поисковой выдачей. В официальной позиции по AI-контенту Google прямо делает акцент на качестве и E-E-A-T, а не на том, написан ли текст человеком или с помощью автоматизации. Но если AI используется для массового создания неоригинальных страниц без ценности, это уже может попасть в зону спам-политик.
Поэтому вопрос «можно ли писать статьи с AI» слишком простой. Правильный вопрос: как именно вы их делаете, кто отвечает за итог, есть ли авторская добавленная ценность, проверены ли факты, понятно ли читателю, зачем читать именно этот материал, и не превращается ли сайт в склад сгенерированных текстов.
С 1 октября 2026 года Google формулирует редакционную проверку ещё конкретнее. В актуальной документации Search Central основной контент предлагают оценивать по четырём характеристикам: Effort, Originality, Talent or skill и Accuracy — объём реальной работы, оригинальность, качество исполнения и фактическая точность. Это не четыре новых ranking factors и не опубликованная формула алгоритма, а рамка оценки качества Main Content, используемая в том числе Search Quality Raters.
Почему вопрос важен
AI резко снизил стоимость производства текста. Раньше, чтобы сделать плохую статью, всё-таки нужно было потратить время. Теперь плохую статью можно сделать быстро, уверенно и в красивой структуре. Это одновременно удобно и опасно.
Для владельца сайта соблазн понятен: взять список ключей, попросить AI написать 100 статей, залить в WordPress, поставить перелинковку и ждать трафик. На бумаге выглядит как контентная фабрика. На практике часто получается мусорный комбинат, только с приятным интерфейсом.
Если молодой сайт после такой массовой публикации не получает видимости сразу, не стоит автоматически списывать это на google sandbox. Сначала полезнее проверить индексацию, качество самих страниц, внутреннюю структуру и соответствие материалов реальному поисковому спросу.
Проблема не в том, что AI написал текст. Проблема в отсутствии редактора, опыта и цели. Если статья не даёт оригинальной информации, не объясняет тему глубже, не показывает практику, не помогает принять решение и не закрывает реальную задачу пользователя, она слаба. Google в helpful content-рекомендациях отдельно предлагает оценивать, даёт ли материал оригинальную информацию, анализ и ценность beyond the obvious, то есть за пределами очевидного пересказа.
Для автора, дизайнера, стокера, музыканта или предпринимателя вопрос шире SEO. AI-контент может затрагивать права на исходники, похожесть результата, использование чужого стиля, изображение людей, имитацию голоса, коммерческую лицензию, маркировку на площадках и доверие аудитории. То есть «сгенерировал и выложил» уже не стратегия, а надежда, что правила никто не читает. Очень смело. Иногда дорого.
Какие правила действуют сейчас
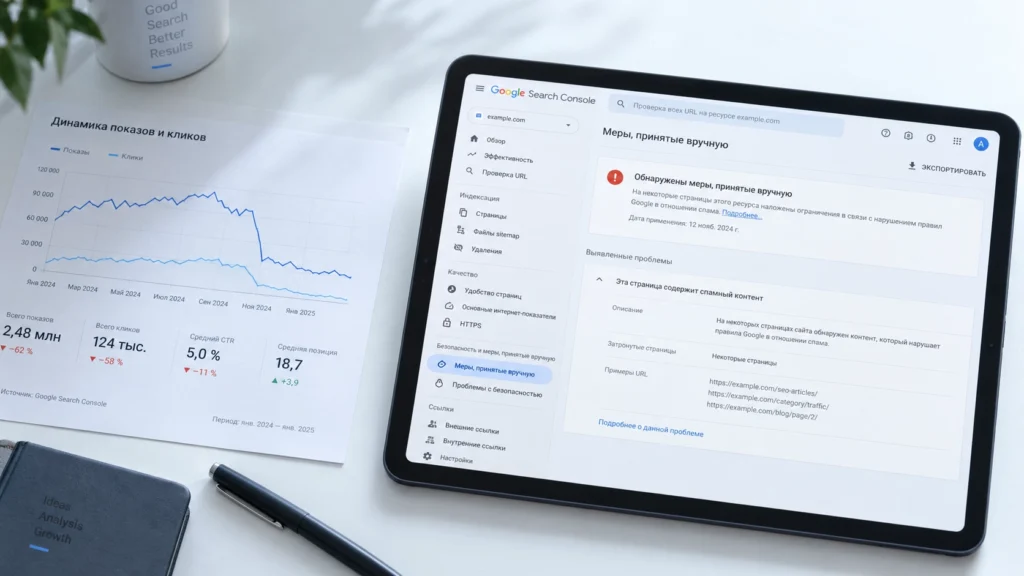
Главное правило Google: контент оценивается по качеству и пользе. AI не запрещён. Автоматизация не запрещена. Но автоматизация ради манипуляции поисковыми результатами нарушает спам-политики. В Google Search spam policies scaled content abuse описан как массовое создание страниц для поискового ранжирования без помощи пользователю, включая использование generative AI-инструментов без добавленной ценности.
Второе правило: нужен принцип people-first. Статья должна быть сделана для читателя. Это означает, что в материале должна быть ясная цель, полнота, оригинальность, проверяемость, полезная структура, нормальная подача и опыт. Если материал создан только потому, что в таблице есть ключевой запрос, это видно. Не всегда сразу алгоритму, но читателю точно.
Третье правило: важны Who, How и Why. Кто создал материал, как он был создан и зачем он был создан. Google прямо связывает эти вопросы с оценкой контента, в том числе при использовании AI. Это не значит, что в каждой статье нужно писать «текст создан с помощью нейросети». Но это значит, что авторство, процесс, проверка и цель должны быть понятны хотя бы на уровне редакционной системы.
Что теперь отдельно проверяют в Main Content

В обновлённой документации Google предлагает смотреть не только на общую «полезность» страницы, но и на качество её Main Content — той части, которая непосредственно помогает странице выполнить свою задачу. Это может быть не только текст: к основному контенту относятся изображения, видео, калькуляторы, инструменты, отзывы и комментарии, если они составляют суть страницы, а также заголовки и содержимое раскрывающихся блоков.
Для оценки Main Content полезно пройти четыре вопроса.
Effort — сколько реальной работы вложено в результат. Исследование, редактура, тестирование, собственный анализ, проверка данных или создание полезного инструмента показывают вложенную работу. Массовая генерация большого количества текста без ручного контроля и курирования — противоположный сценарий.
Originality — что материал добавляет нового. Страница должна давать собственную информацию, опыт, анализ, данные, методику или перспективу, а не просто переписывать то, что уже опубликовано другими.
Talent or skill — насколько хорошо выполнена задача страницы. Для статьи это могут быть ясность и компетентность, для видео — качество исполнения, для калькулятора — корректная работа. Не каждой теме нужен дипломированный эксперт, но уровень навыка должен соответствовать задаче.
Accuracy — насколько точна информация. Для информационных страниц факты должны быть корректны. Для YMYL-тем требования выше: информация должна быть особенно точной и соответствовать устойчивому экспертному консенсусу.
Важно: это не опубликованные веса алгоритма Google. Search Quality Raters используют такие критерии для оценки качества результатов и работы поисковых систем в целом. Асессоры не выставляют отдельным страницам позиции, а их оценки н
Четвёртое правило: ownership не равно безусловная безопасность. Например, OpenAI в условиях указывает, что пользователь сохраняет права на Input и владеет Output в пределах применимого законодательства, но также предупреждает, что output может быть неуникальным и другие пользователи могут получить похожий результат. Это важный нюанс для коммерческого контента, брендинга, стоков, музыки, визуалов и текстов под продажу.
Пятое правило: disclosure зависит от площадки. Для обычной SEO-статьи в Google Search нет универсального требования «обязательно поставить метку AI». Но на других площадках правила могут быть жёстче. Adobe Stock требует маркировать контент как Created using generative AI и соблюдать ограничения по правам, людям, брендам, известным персонам, IP и вводящим в заблуждение описаниям. YouTube требует раскрывать реалистичный altered или synthetic content, если изменения значимые и могут ввести зрителя в заблуждение.
| Ситуация | Что безопаснее делать |
|---|---|
| AI-статья для сайта | Проверять факты, добавлять опыт, автора, структуру и пользу |
| Массовая генерация статей | Не публиковать без редактора и добавленной ценности |
| Статья на экспертную тему | Добавлять реальные выводы, примеры, ограничения и источники |
| AI-изображение для стока | Маркировать как generative AI и соблюдать правила площадки |
| AI-видео с реалистичными изменениями | Проверять, нужна ли disclosure-метка |
| AI-музыка или голос | Не имитировать реальных артистов без прав |
| Коммерческий проект | Проверять условия инструмента, источники и права на вводные данные |
Где чаще всего ошибаются
Первая ошибка — думать, что Google «не любит AI». Это упрощение. Google не любит бесполезный, неоригинальный, массовый и манипулятивный контент. Если человек напишет такую же мусорную статью вручную, она не станет лучше от того, что страдала без нейросети.
Поэтому попытка объяснить просадку или слабое качество страницы одним историческим ярлыком вроде google panda мало помогает на практике. Гораздо полезнее разобрать конкретный материал: какую задачу он решает, что добавляет к уже существующей выдаче и почему пользователь должен ему доверять.
Вторая ошибка — публиковать сырой AI-текст без ручной проверки. Google теперь прямо пишет, что generative AI output может содержать неточности и hallucinations, поэтому такой контент необходимо вручную проверять на точность и надёжность до публикации. Это особенно важно для технических, юридических, финансовых, медицинских и других тем, где ошибка способна повлиять на решение пользователя. Уверенный стиль модели не является подтверждением факта.
Проверять нужно не только тело статьи. Та же редакционная проверка относится к автоматически созданным <title>, meta description, structured data и alt изображений. AI не должен придумывать в title преимущество, которого нет на странице, описывать в alt несуществующий объект или добавлять в structured data рейтинг, цену, дату либо другой факт, отсутствующий в видимом контенте. Для structured data дополнительно нужно проверять соответствие правилам конкретного search feature и валидность разметки.
Третья ошибка — делать статьи без автора. Не обязательно превращать каждый материал в автобиографию. Но читатель должен понимать, почему этому сайту можно доверять. Кто пишет? На каком опыте? Как проверяются материалы? Есть ли практика? Есть ли примеры? Если сайт выглядит как безымянный генератор SEO-текстов, доверия будет мало.
Отдельно не стоит имитировать экспертность. Google теперь прямо приводит придуманные профили авторов — AI-generated headshots, вымышленные имена и ложные credentials — как пример deceptive authorship. Если материал подписан экспертом, человек и его опыт должны быть реальными, а не созданными для того, чтобы страница выглядела убедительнее.
Четвёртая ошибка — не добавлять ничего своего. AI легко пересказывает очевидное. Но сильная статья должна давать опыт, сравнение, таблицу, чек-лист, примеры, личную позицию, практические ограничения, скриншоты, код, реальные случаи, методику, выводы. То есть то, что нельзя получить простым пересказом первых пяти результатов выдачи.
Пятая ошибка — делать вид, что ownership решает всё. Даже если сервис передаёт права на output, остаются вопросы: не использовали ли вы чужие изображения как референс, не попросили ли «в стиле живого художника», не сгенерировали ли похожего реального человека, не имитируете ли голос артиста, не используете ли защищённые бренды, не нарушаете ли правила площадки. Ownership от AI-сервиса не отменяет закон, лицензии и правила маркетплейсов.
Шестая ошибка — путать disclosure и SEO. Для Google Search сама по себе метка «создано с AI» не делает статью хорошей или плохой. А вот для стоков, видео, рекламы, музыки и площадок с правилами прозрачности маркировка может быть обязательной. То есть не надо лепить disclosure везде из паники, но надо понимать, где она реально нужна.
Google не вводит универсальное SEO-требование маркировать каждую статью, где использовался AI. Рекомендация другая: давать читателю информацию о способе создания там, где вопрос «как это было сделано?» разумно ожидаем — например, если автоматизация существенно участвовала в создании материала. Для отдельных площадок, типов контента и коммерческих систем при этом могут действовать собственные обязательные правила disclosure.
Седьмая ошибка — генерировать коммерческие материалы без редакционной политики. Если сайт работает с AI постоянно, ему нужны правила: что можно генерировать, что обязательно проверять, какие темы нельзя публиковать без эксперта, как указывать автора, как обновлять статьи, как работать с источниками, что запрещено в промптах. Эту тему логично раскрывать отдельно через материал редакционная политика AI сайта.
Что безопаснее делать на практике
Я бы строил AI-контент как редакционный процесс, а не как кнопку «написать статью». Сначала тема, интент, аудитория, структура и цель. Потом черновик. Потом проверка. Потом добавление опыта. Потом SEO. Потом публикация. Потом обновление.
Хорошая AI-статья должна пройти минимум пять фильтров.
Первый фильтр: смысл. Статья отвечает на реальный вопрос или просто закрывает ключ? Если тема нужна только потому, что запрос есть в таблице, материал может получиться слабым. Контент должен быть связан с задачей пользователя.
Второй фильтр: авторская ценность. Что в статье есть такого, чего не даст обычная генерация? Практический опыт, пример, таблица, методика, мнение, ошибка из реальной работы, локальный контекст, код, визуальный пример, сравнение, вывод? Если ничего нет, это кандидат на мусор.
Третий фильтр: фактчекинг. Все технические, правовые, платформенные и коммерческие утверждения нужно проверять по первоисточникам. Особенно если статья касается Google, Adobe Stock, YouTube, OpenAI, музыки, авторского права, рекламы или медицины. Здесь нельзя полагаться на «модель сказала уверенно».
Четвёртый фильтр: формат. AI часто делает текст гладким, но одинаковым. Его нужно редактировать: убрать воду, повторения, пустые формулировки, чрезмерные вводные, общие советы. Статья должна быть плотной и полезной, а не просто большой.
Пятый фильтр: соответствие площадке. Для сайта — SEO, E-E-A-T, внутренняя перелинковка, мета-данные, структура. Для стоков — права, маркировка, отсутствие IP, релизы. Для видео — disclosure altered/synthetic. Для музыки — права на голос, семплы, дистрибуцию и описание артиста.
То же относится к google discover: сам канал распространения не превращает слабый AI-материал в полезный. Сначала контент должен выдерживать обычную редакционную проверку по смыслу, оригинальности, фактам и качеству подачи.
Если писать AI-статьи для своего сайта, я бы делал так: AI собирает черновик и варианты структуры, человек добавляет опыт, проверяет источники, чистит стиль, вставляет внутренние ссылки и отвечает за итог. Подробнее такой подход можно показать через материал как писать AI статьи с автором.
Если AI-контент выпускается регулярно и должен приносить поисковый трафик, отдельных хороших текстов недостаточно: нужна связанная семантика, понятная структура разделов, внутренняя перелинковка, технический контроль и обновление уже опубликованных материалов. Именно поэтому комплексное продвижение сайта имеет смысл рассматривать как систему, где AI ускоряет отдельные операции, но не заменяет редакционную и SEO-работу над проектом в целом.
Чек-лист перед публикацией/монетизацией
Перед публикацией AI-контента я бы проходил такой чек-лист:
- Понятно ли, для кого статья и какую задачу она решает?
- Есть ли в материале оригинальная ценность, а не только пересказ очевидного?
- Добавлен ли авторский опыт, пример, таблица, чек-лист, вывод или методика?
- Проверены ли факты по первоисточникам?
- Есть ли в материале заметный Effort — исследование, редактура, тестирование или другая реальная работа сверх генерации?
- Есть ли Originality — собственные данные, опыт, вывод, методика или информация сверх пересказа?
- Соответствует ли Talent or skill сложности темы и назначению страницы?
- Проверена ли Accuracy всех изменяемых и фактических утверждений?
- Проверены ли отдельно AI-generated
<title>, description, structured data иalt?
- Нет ли утверждений, которые требуют юридической, медицинской или финансовой осторожности?
- Нет ли копирования чужой структуры, текста, изображения, стиля, бренда или персонажа?
- Не используется ли чужое имя, образ, голос или узнаваемый персонаж без прав?
- Не выглядит ли материал как массовая генерация ради поискового трафика?
- Есть ли понятный автор, редактор или хотя бы редакционная ответственность?
- Есть ли нормальные внутренние ссылки и логичная связь с сайтом?
- Не вводит ли заголовок или обложка пользователя в заблуждение?
- Нужна ли disclosure-метка на конкретной площадке?
- Можно ли использовать результат коммерчески по условиям инструмента?
- Не нарушает ли публикация правила стока, видеоплатформы, музыкального дистрибьютора или рекламной системы?
- Проверен ли материал после публикации: индексация, поведение, клики, заявки, жалобы, ошибки?
После публикации недостаточно просто добавить сайт в google и считать работу законченной. Проверьте, индексируется ли нужная страница, получает ли она показы и клики и не требует ли материал доработки после появления первых реальных данных.
FAQ
Частые вопросы про AI-контент и Google
Нет, Google не запрещает AI-контент как класс. Важны качество, польза, оригинальность, E-E-A-T и отсутствие манипулятивной массовой генерации ради ранжирования.
Для Google Search универсального требования нет. Но если для читателя важно понимать процесс создания материала, можно раскрывать это аккуратно. На отдельных площадках disclosure может быть обязательной, например для generative AI-контента на Adobe Stock или реалистичного altered/synthetic content на YouTube.
Плохой сигнал — массовые неоригинальные страницы без ценности, тексты ради поисковых позиций, пересказ чужих материалов, отсутствие пользы, слабая фактическая проверка и контент, который создаётся прежде всего для манипуляции ранжированием.
Можно, но нужно проверять условия инструмента, права на input и output, правила площадки, факты, источники и возможные ограничения. OpenAI указывает, что пользователь владеет Output в пределах применимого права, но также предупреждает, что output может быть неуникальным.
Потому что он часто общий, без опыта, без проверки, без примеров и без авторской позиции. Он может выглядеть аккуратно, но не давать читателю ничего нового. А Google рекомендует оценивать, есть ли в контенте оригинальная информация, анализ и дополнительная ценность.
Технически можно, но это рискованно, если материалы массовые, неоригинальные и не помогают пользователю. Массовая генерация страниц без добавленной ценности может попадать под scaled content abuse.
Редактура. Хороший промпт помогает получить сильный черновик, но финальная ценность появляется после проверки, сокращения, добавления опыта, источников, примеров и нормальной структуры.
Она отвечает на реальную задачу, содержит авторскую ценность, проверенные факты, понятную структуру, внутренние ссылки, хороший Title и H1, таблицу или чек-лист, а также не нарушает правила площадки и коммерческого использования.
Нет. Это критерии оценки качества Main Content из Search Quality Rater Guidelines и актуальных рекомендаций Search Central. Google прямо указывает, что Search Quality Raters не контролируют позиции страниц, а их оценки не используются напрямую в алгоритмах ранжирования.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.