15 сентября, 2026 года
 10 мин
 58 просмотров
Поисковая система помогает пользователю найти информацию среди огромного числа доступных в интернете документов.
Упрощённо у неё есть несколько задач:
- обнаружить URL;
- получить страницу;
- понять её содержимое;
- решить, может ли она участвовать в поиске;
- при запросе пользователя выбрать релевантные результаты;
- сформировать страницу ответа.
Веб-поиск при этом не является просмотром всего интернета в реальном времени.
Когда пользователь вводит запрос, Google, Яндекс или другой поисковик в основном работает уже с собственной обработанной базой данных — индексом.
Это принципиально для SEO.
Если страница существует на сайте, это ещё не означает, что:
- робот знает её URL;
- робот смог её получить;
- страница разрешена для индексирования;
- система выбрала именно этот URL как основной;
- документ попал в поисковый индекс;
- он релевантен конкретному запросу;
- он будет показан пользователю.
Google прямо предупреждает, что даже соблюдение Search Essentials не гарантирует обход, индексирование или показ конкретной страницы.
Как работают поисковые системы
Этап 1. Обнаружение страницы
Чтобы обработать страницу, поисковая система сначала должна узнать о её существовании.
Google может обнаружить URL, например:
- по ссылке с уже известной страницы;
- через Sitemap;
- при повторном обходе уже известного сайта.
Googlebot переходит между URL, анализируя ссылки, Sitemap и перенаправления.
Яндекс указывает среди источников известных URL:
- внутренние ссылки;
- внешние ссылки;
- Sitemap;
- собственные данные о сайте.
После обнаружения робот самостоятельно определяет, что и с какой частотой обходить.
Отсюда простое практическое правило: важные страницы не должны существовать только как URL, известный владельцу сайта. Они должны быть встроены в нормальную архитектуру и доступны поисковому роботу.
Этап 2. Обход
Поисковый робот запрашивает URL у сервера и получает содержимое.
Робот Google называется Googlebot. У Яндекса существует несколько роботов для разных задач.
На этом этапе могут возникнуть технические ограничения:
- сервер недоступен;
- URL возвращает ошибку;
- robots.txt запрещает обход;
- страница требует авторизации;
- важное содержимое невозможно получить или отрисовать.
Минимальные технические требования Google достаточно конкретны: Googlebot не должен быть заблокирован, страница должна работать и содержать материал, пригодный для индексирования. При этом выполнение этих условий само по себе всё ещё не гарантирует попадание в индекс.
Для JavaScript-страниц Google дополнительно выполняет рендеринг, поскольку часть содержимого может появляться только после выполнения скриптов.
Этап 3. Индексирование
После получения страницы поисковая система анализирует её.
Google указывает, что на стадии индексирования обрабатывает в том числе:
- текст;
- изображения;
- видео;
<title>;- alt-атрибуты;
- сведения о языке и локальности;
- сходство с другими страницами.
Google также определяет дубли и выбирает каноническую страницу из группы похожих документов.
Яндекс описывает похожий процесс. При обработке страницы он может учитывать:
- Title;
- Description;
- Schema.org;
- robots meta;
- canonical;
- текст;
- изображения;
- видео;
- наличие дублей.
Индексирование — не просто сохранение HTML-файла. Поисковая система пытается понять документ и его отношения с другими URL.
Этап 4. Отбор и формирование результатов
Когда пользователь задаёт запрос, система ищет подходящие документы в своём индексе.
Google пишет, что релевантность определяется программно с использованием множества факторов, среди которых могут учитываться запрос, язык, местоположение и устройство пользователя.
Яндекс описывает этот этап через оценку, в частности:
- соответствия содержимого запросу;
- понятности и полезности материала;
- удобства страницы для пользователя.
Таким образом, привычная схема:
Обход → индекс → позиции
слишком упрощена.
Точнее:
Обнаружение URL
↓
возможность обхода
↓
получение и обработка содержимого
↓
решение об индексировании
↓
выбор документа для конкретного запроса
↓
формирование результатов
↓
показ пользователю

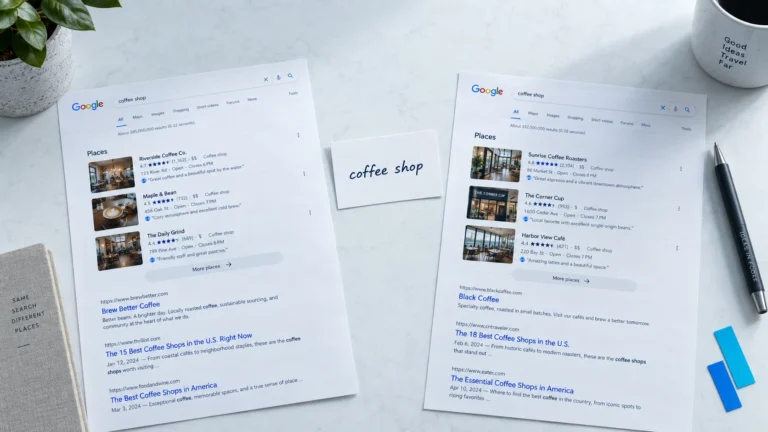
Почему Google и Яндекс могут показывать разные результаты
Поисковые системы не обязаны одинаково:
- находить страницы;
- обходить их;
- выбирать canonical;
- оценивать документы;
- формировать результаты;
- учитывать географию;
- обновлять индекс.
Поэтому ситуация:
страница есть в Google
↓
но отсутствует в Яндексе
сама по себе не означает техническую ошибку.
Нужно отдельно проверить состояние URL в каждой системе.
Яндекс прямо указывает, что даже оригинальная и технически доступная страница может не попасть в базу документов, способных участвовать в поиске — например, если алгоритмы считают маловероятным её появление в видимой области результатов.
Google аналогично подчёркивает, что индексирование не гарантируется
Поэтому стратегия «страница открывается в браузере — значит с SEO всё нормально» неверна.
Как поисковые системы связаны с SEO и бизнес-результатом
SEO работает на границе между сайтом и поисковой системой.
оптимизация сайта может помогать:
- обнаружению нужных URL;
- корректному обходу;
- управлению индексированием;
- пониманию структуры;
- соответствию страниц пользовательским запросам;
- улучшению представления результатов.
Но SEO не означает прямого управления алгоритмом поисковика.
Google прямо говорит, что не принимает оплату за более частый обход сайта или повышение позиции и не гарантирует показ страницы даже при выполнении технических требований.
Для бизнеса цепочка выглядит так:
страница создана
↓
поисковая система её обнаружила
↓
страница проиндексирована
↓
получила показы
↓
пользователь кликнул
↓
перешёл на сайт
↓
совершил целевое действие
Поэтому поисковый трафик — результат нескольких последовательных этапов, а не автоматическое следствие самого факта индексирования.
А поисковая выдача — уже конечный интерфейс, в котором конкурируют разные документы и типы результатов.
Как проверить работу поисковых систем на своём сайте
Для Google основным инструментом владельца сайта является Search Console.
С его помощью можно проверять:
- индексирование;
- конкретные URL;
- обход;
- Sitemap;
- поисковые запросы;
- показы;
- клики;
- CTR;
- среднюю позицию.
Google прямо рекомендует Search Console для мониторинга присутствия сайта и проверки возможности его индексирования.
Для Яндекса используется Яндекс Вебмастер.
Он позволяет отслеживать:
- страницы в поиске;
- обход;
- проблемы индексирования;
- Sitemap и robots.txt;
- запросы;
- показы;
- клики;
- позиции.
Официальное руководство Яндекса связывает эти инструменты непосредственно с этапами обхода, индексирования и формирования результатов.
Базовая диагностика URL
Если важная страница не получает поисковых показов, имеет смысл идти сверху вниз:
- URL существует?
- сервер возвращает корректный ответ?
- робот может получить страницу?
- нет запрета на индексирование?
- какой canonical видит система?
- URL есть в индексе?
- страница получает показы?
- по каким запросам?
- соответствует ли содержимое этим запросам?
И только после этого переходить к гипотезам о ранжировании.
Это позволяет не искать «алгоритмическую проблему», когда причина находится, например, в noindex или неправильном canonical.


DuckDuckGo SEO: нужно ли отдельно оптимизировать сайт
DuckDuckGo — действующая независимая поисковая система с собственной поисковой инфраструктурой, но источник её результатов устроен не так, как у Google или Яндекса.
DuckDuckGo официально пишет, что использует:
- собственный DuckDuckBot;
- собственные индексы;
- специализированные внешние источники;
- Bing для значительной части обычных веб-ссылок и изображений.
При этом DuckDuckGo прямо указывает, что не использует результаты Google.
Практический вывод для SEO: отдельный набор «секретных факторов DuckDuckGo» не требуется. Имеет смысл обеспечить нормальную доступность и качество сайта и учитывать Bing как важный источник органических ссылок DuckDuckGo.
Bing в актуальных рекомендациях для вебмастеров делает акцент на:
- доступности URL;
- индексировании;
- canonical;
- Sitemap;
- внутренних ссылках;
- качестве и ясности контента;
- IndexNow для уведомления об обновлениях.
При этом нельзя утверждать, что позиция в Bing автоматически будет полностью совпадать с DuckDuckGo: DuckDuckGo объединяет несколько источников и собственные механизмы.
Поиск Mail.ru SEO: нужно ли оптимизировать сайт отдельно
Здесь важно не использовать устаревшую информацию.
Исторически у Mail.ru существовал собственный веб-поиск, однако как отдельная самостоятельная поисковая система он перестал работать в прежнем виде в 2022 году. В актуальной официальной документации Mail на 2026 год я не нахожу действующего собственного веб-индекса, Webmaster-инструмента или рекомендаций для оптимизации сайтов именно под независимый поиск Mail.
Публичная точка go.mail.ru также больше не открывает самостоятельную страницу веб-поиска и перенаправляется в инфраструктуру Mail/VK. Наблюдение о переходе портала Mail на поиск Яндекса после закрытия собственного проекта подтверждается публичными материалами пользователей Mail, но это не полноценная современная документация поисковой технологии, поэтому выдавать его за официальный технический источник нельзя.
Практический вывод:
отдельно оптимизировать сайт под «Поиск Mail.ru» как под современную независимую поисковую систему оснований нет.
Для российского сайта в первую очередь нужно контролировать Google и Яндекс, а при необходимости дополнительного охвата — Bing и связанные с ним поисковые продукты.
Практический пример
Допустим, на сайте опубликована новая страница услуги.
Она открывается по адресу:
https://example.ru/service/
Через неделю владельцу кажется, что «поисковики её не любят», потому что трафика нет.
Вместо предположений проверяем процесс.
URL Inspection показывает:
- Googlebot смог получить страницу;
- индексирование разрешено;
- canonical совпадает с URL;
- страница находится в индексе.
В Performance при этом почти нет показов.
Значит, проблема уже не в доступности или индексировании. Следующий этап — анализ спроса, содержимого страницы и запросов.
Яндекс
В Вебмастере URL обнаружен, но отсутствует среди страниц в поиске.
Здесь диагностика другая: необходимо посмотреть состояние индексирования именно в Яндексе, а не переносить вывод из Search Console.
Этот пример показывает основное правило:
одна страница
≠
одинаковое состояние во всех поисковиках
Поэтому SEO-диагностика должна опираться на данные конкретной системы.
Частые ошибки и заблуждения
1. Поисковик ищет весь интернет после каждого запроса
Нет.
Основная работа происходит с заранее обнаруженными и обработанными документами в поисковом индексе.
2. Если страницу может открыть пользователь, поисковый робот тоже обязательно сможет
Нет.
Робота могут ограничивать robots.txt, авторизация, серверные ошибки, особенности рендеринга и другие технические условия.
3. Если URL проиндексирован, он обязательно должен получать трафик
Нет.
Индексирование означает возможность участия страницы в поиске, а не гарантированный показ по нужным запросам.
4. Google и Яндекс должны индексировать одинаковые URL
Нет.
Это независимые системы с собственными роботами, индексами и алгоритмами.
5. Sitemap гарантирует попадание в результаты
Нет.
Google прямо указывает, что Sitemap помогает обнаружить URL, но не гарантирует индексирование и не повышает позицию автоматически.
6. Любое падение позиции означает санкции
Нет.
Причины могут быть техническими, алгоритмическими, конкурентными или связанными со спросом. Ручные меры — отдельный механизм.
Поэтому фильтры поисковых систем нельзя диагностировать только по одному падению позиции или трафика.
7. Нужно создать отдельную SEO-стратегию для каждого существующего поискового бренда
Не всегда.
Сначала нужно понять, существует ли у системы собственный индекс и существенный канал поиска для проекта. Например, DuckDuckGo действительно является самостоятельным поисковым продуктом, но значительную часть обычных ссылок получает из Bing; отдельный собственный веб-поиск Mail.ru в актуальном виде не подтверждается.
Чек-лист: что важно поисковым системам с технической стороны
Перед поиском сложных причин проверьте базу:
- важные URL доступны без авторизации;
- сервер возвращает корректные HTTP-ответы;
- robots.txt не закрывает нужные страницы;
- нет случайного
noindex; - canonical соответствует стратегии;
- Sitemap содержит актуальные канонические URL;
- важные страницы имеют обычные внутренние ссылки;
- содержимое доступно поисковому роботу;
- ключевые URL проверены в Search Console;
- ключевые URL отдельно проверены в Яндекс Вебмастере;
- индексирование не путается с ранжированием;
- позиции не используются как единственный показатель результата.
Вывод: что делать на практике
Для SEO полезнее всего перестать воспринимать поисковую систему как один непрозрачный «алгоритм позиций».
Разделяйте процесс:
обнаружение
→ обход
→ индексирование
→ участие в поиске
→ показы
→ клики
→ результат для бизнеса
При проблеме начинайте с самого раннего этапа.
Если робот не может получить страницу, анализировать её позиции бессмысленно. Если URL не индексируется, сначала нужно понять причину этого состояния. Если страница уже индексируется и получает показы, тогда имеет смысл анализировать релевантность, конкуренцию, сниппет и пользовательский спрос.
Для Google используйте Search Console, для Яндекса — Вебмастер. DuckDuckGo имеет собственные технологии, но значительная часть его обычных результатов связана с Bing. Отдельный современный поисковый индекс Mail.ru как самостоятельная SEO-платформа на 2026 год не подтверждается.
Такой подход позволяет искать причину проблемы на конкретном этапе, а не объяснять любое изменение абстрактной фразой «поисковик поменял алгоритм».
Материал подготовлен Максимом Вагизовым для vagizov.com . При цитировании обязательна активная ссылка на источник.
Подробнее об авторских правах