Суть материала
Главное за минуту
GPT-6.1 Sol — модель OpenAI для сложного coding, computer use и профессиональной работы с производительностью, близкой к Astra, но существенно более низкой ценой. Отдельно модель поддерживает beta Multi-agent в Responses API: root model может создавать параллельных subagents, распределять независимые части задачи и синтезировать их результаты.
При выборе модели для API обычно хочется получить простой ответ: какая модель лучше?
Для GPT-6.1 Sol вопрос стоит иначе.
OpenAI уже имеет более мощный GPT-6 Astra и значительно более дешёвый GPT-6 Luna. GPT-6.1 Sol расположен между ними: компания описывает его как модель с near-Astra performance для сложной работы при более низкой стоимости. Для API это делает Sol интересным не как абсолютный максимум качества, а как рабочую модель для сложных coding, computer-use и professional workflows, где стоимость Astra трудно оправдать на каждом запросе.
29 сентября 2026 года вместе с GPT-6.1 Sol появилась ещё одна важная возможность — Multi-agent beta в Responses API. Root model может создавать несколько subagents, распределять независимые части работы параллельно и затем синтезировать их результаты.
Это не новая версия Agents API.
И не автоматическая причина превращать каждый запрос в команду из пяти агентов.
Чтобы понять, когда GPT-6.1 Sol действительно оправдан, полезно сначала разобрать модель отдельно от agent infrastructure.
Где GPT-6.1 Sol находится между Luna и Astra
В актуальной линейке OpenAI логика достаточно понятная.
GPT-6 Luna — наиболее эффективная модель для focused и high-volume tasks.
GPT-6.1 Sol — баланс сложности, качества и стоимости.
GPT-6 Astra — максимальная capability для наиболее требовательных reasoning, coding и professional workflows.
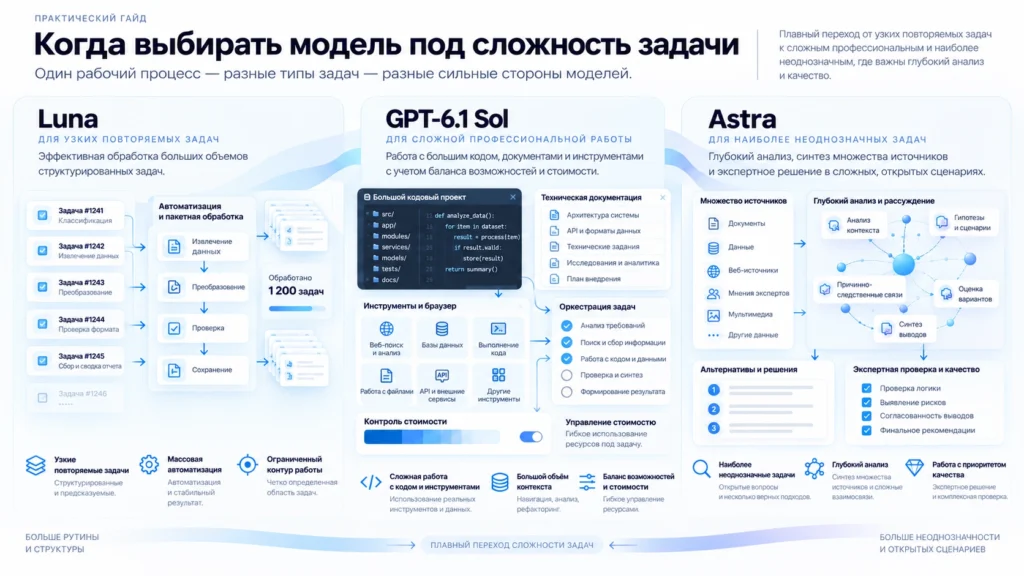
Технически все три актуальные модели имеют очень большой context window — 1 050 000 токенов — и max output 128 000 токенов. Поэтому выбирать Sol только из-за размера контекста бессмысленно: у Astra и Luna сейчас те же пределы.
Разница начинается в стоимости и целевом уровне задачи.
| Модель | Standard input / 1M | Standard output / 1M | Основная роль |
|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.50 | focused и high-volume tasks |
| GPT-6.1 Sol | $2 | $10 | complex work с контролем стоимости |
| GPT-6 Astra | $10 | $50 | hardest quality-first work |
Таким образом, стандартная token price GPT-6.1 Sol в пять раз ниже Astra и в двадцать раз выше Luna по input/output. Но стоимость одного полезного результата нельзя выводить только из тарифа за миллион токенов: более сильная модель может требовать меньше повторных попыток, меньше output или реже нуждаться в человеческой доработке. OpenAI поэтому рекомендует сравнивать модели на собственных representative tasks.
Цена GPT-6.1 Sol сложнее одной строки $2 / $10
Для Standard processing и input до 272K токенов текущая тарификация GPT-6.1 Sol:
- input — $2 / 1M tokens;
- cached input — $0.10 / 1M;
- cache write — $2.50 / 1M;
- output — $10 / 1M.
Если prompt содержит больше 272K input tokens, применяется long-context pricing ко всему запросу: input и cache rates удваиваются, а output становится в 1.5 раза дороже. Для Standard это означает $4 input и $15 output за миллион токенов.
Это особенно важно именно для сценариев, ради которых хочется использовать миллионный context window.
Техническая возможность отправить огромный codebase не означает, что это оптимальная архитектура.
Часто выгоднее:
поиск нужных файлов → ограниченный context → анализ
чем:
загрузить весь repository → надеяться, что модель сама отфильтрует лишнее.
Prompt caching, file search и разделение задачи на subagents здесь способны влиять на экономику сильнее, чем простая смена model ID.
Reasoning effort: больше не всегда лучше
GPT-6.1 Sol поддерживает:
low → medium → high → xhigh → max
Default — medium.
none и minimal не поддерживаются.
Reasoning effort определяет, сколько внутренней вычислительной работы модель может потратить на задачу. OpenAI рекомендует low для достаточно ограниченных задач, medium/high — для диагностики, сравнения вариантов и reasoning по коду, а xhigh/max — только когда собственные evals показывают оправданный прирост качества.
На практике я бы не делал:
сложная статья → maxкод → maxresearch → max
автоматическим правилом.
Для большого числа production-задач выгоднее сначала проверить medium.
Если качество недостаточно — high.
И только потом сравнивать xhigh или max.
Дополнительно у GPT-6 моделей существуют независимые друг от друга reasoning.mode и reasoning.effort: режим pro может дать модели больше вычислительной работы для hardest quality-first tasks, но ценой latency и token usage.
Responses API для Sol важнее Chat Completions
GPT-6.1 Sol доступен через Responses и Chat Completions, но функционально эти варианты сейчас не равнозначны.
Для tool calling OpenAI рекомендует Responses API.
Chat Completions для GPT-6.1 Sol поддерживается без tools.
Через Responses модель поддерживает большой набор инструментов:
- function calling;
- web search;
- file search;
- image generation;
- Code Interpreter;
- hosted shell;
- apply patch;
- Skills;
- computer use;
- MCP;
- tool search.
Поэтому для нового сложного приложения я бы рассматривал Responses API как основной вариант, а Chat Completions — скорее как совместимый endpoint для более простого существующего pipeline.
OpenAI сама рекомендует начинать новые production-интеграции с Responses API, поскольку именно туда в первую очередь приходят новые model behavior, tools, stateful workflows и agent features.
Что такое Multi-agent в Responses API
Здесь особенно важно не перепутать три разных вещи.
GPT-6.1 Sol — модель.
Responses API — API для обращения к модели, tools и stateful workflows.
Multi-agent beta — возможность внутри Responses API позволить root model создавать и координировать subagents.
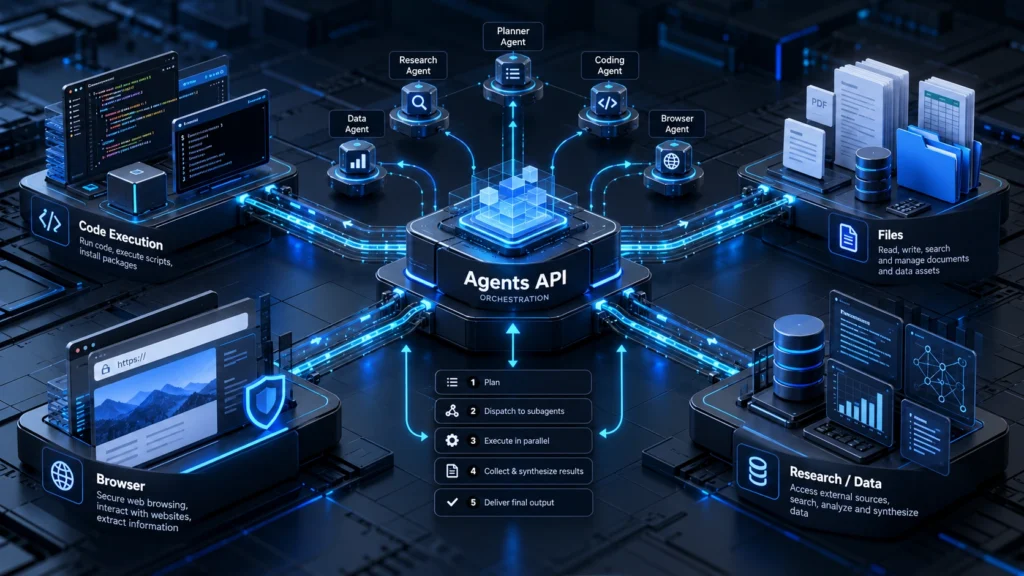
Agents API — отдельная managed agent infrastructure с собственной моделью sessions, environments, sandboxes, recovery и длительного выполнения.
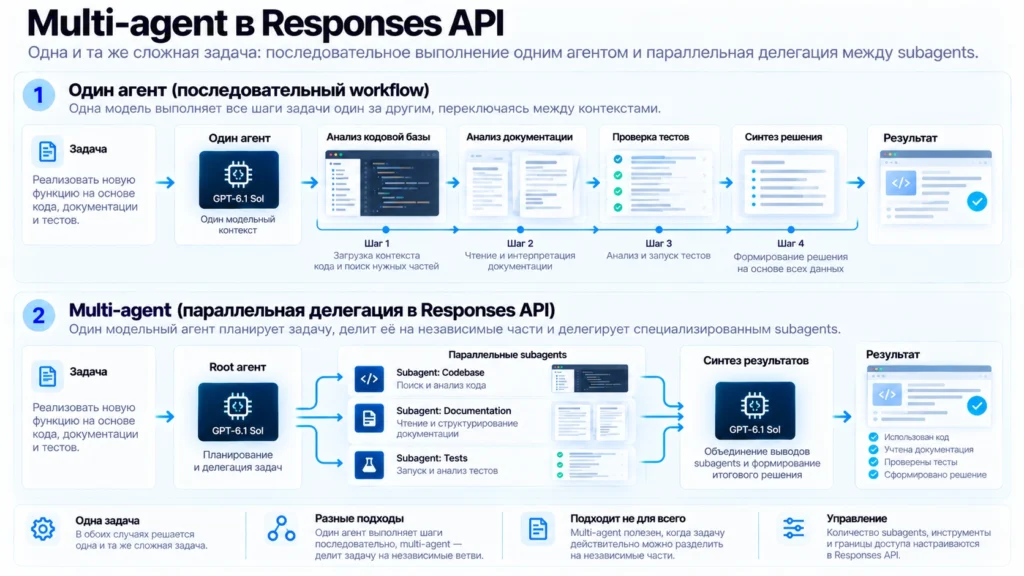
Multi-agent beta позволяет root model самостоятельно создавать subagents, передавать им ограниченные подзадачи, ждать результаты и объединять выводы. Каждый subagent имеет собственный context, поэтому разные линии исследования меньше мешают друг другу.
На 4 октября 2026 года официально поддерживаются:
GPT-6.1 Sol
и
все GPT-5.6 models.
Это важный нюанс: GPT-6 Astra в списке Responses Multi-agent beta сейчас не указан, хотя сама Astra умеет хорошо выполнять agentic и multi-step work и может участвовать в multi-agent архитектурах, которые вы реализуете собственным harness. Hosted Responses Multi-agent beta — более конкретная функция API.
Как включается Multi-agent beta
На уровне запроса идея выглядит примерно так:
const response = await client.beta.responses.create({
  model: "gpt-6.1-sol",
  input: task,
  multi_agent: {
    enabled: true,
    max_concurrent_subagents: 3
  },
  betas: ["responses_multi_agent=v1"]
});
Для HTTP/SDK сейчас используется beta Responses interface и соответствующий beta flag.
max_concurrent_subagents ограничивает количество одновременно работающих subagents во всём дереве, кроме root agent.
Default — 3, и OpenAI рекомендует его для большинства workload. При этом API сейчас не задаёт фиксированный maximum этого параметра, глубины agent tree или общего количества созданных subagents.
Это не означает, что хорошая идея — выставить 50.
Каждая дополнительная ветвь создаёт:
- дополнительный context;
- дополнительные reasoning tokens;
- tool calls;
- output;
- больше результатов для synthesis.
Multi-agent уменьшает wall-clock time не бесплатно.
Практический сценарий: веб-студия разбирает большой проект
Представим WordPress-проект с большой кастомной темой.
Есть три проблемы:
- на части страниц периодически возникает PHP/JS-баг;
- документация старого модуля расходится с кодом;
- после изменений падает несколько integration tests.
Вариант 1. Последовательный pipeline
Можно вообще не использовать reasoning model как agent.
Приложение само задаёт порядок:
найти файлы
→проанализировать PHP
→прочитать документацию
→запустить тесты
→собрать результат.
Если workflow известен заранее и почти детерминирован, такой подход часто лучший.
Вариант 2. Один GPT-6.1 Sol
Передаём модели tools и задачу:
исследуй проблему → выбери нужные файлы → прочитай docs → проверь тесты → сформулируй причину.
Sol сам выбирает порядок действий.
Это хорошо, если этапы связаны.
Например, какой документ читать, становится понятно только после того, как найден проблемный модуль.
В такой ситуации Multi-agent может даже мешать: subagent документации начнёт работу, не зная, что именно нужно искать.
Вариант 3. Sol + Multi-agent
Теперь предположим, что работа естественно делится:
Subagent A: исследовать /theme/ и найти потенциальную причину бага.
Subagent B: проверить всю документацию соответствующего модуля на несоответствия текущему API.
Subagent C: исследовать failing tests и классифицировать причины независимо от первых двух.
Все три задачи можно выполнять одновременно.
Root model затем получает их результаты и ищет общий вывод:
изменение функции X
+устаревшая документация
+два теста ожидают старое поведение.
Вот здесь parallelism имеет смысл.
OpenAI прямо приводит exploration разных частей codebase, анализ документов, independent tests и разные гипотезы причины failure как подходящие Multi-agent scenarios.
В обычной WordPress-разработке AI уже полезен для локальных задач — проверки кода, структуры, шаблонов и диагностики. Практические примеры есть в материале 20 задач WordPress-разработчика, которые ускоряет AI.
Multi-agent не делает модель «в несколько раз умнее»
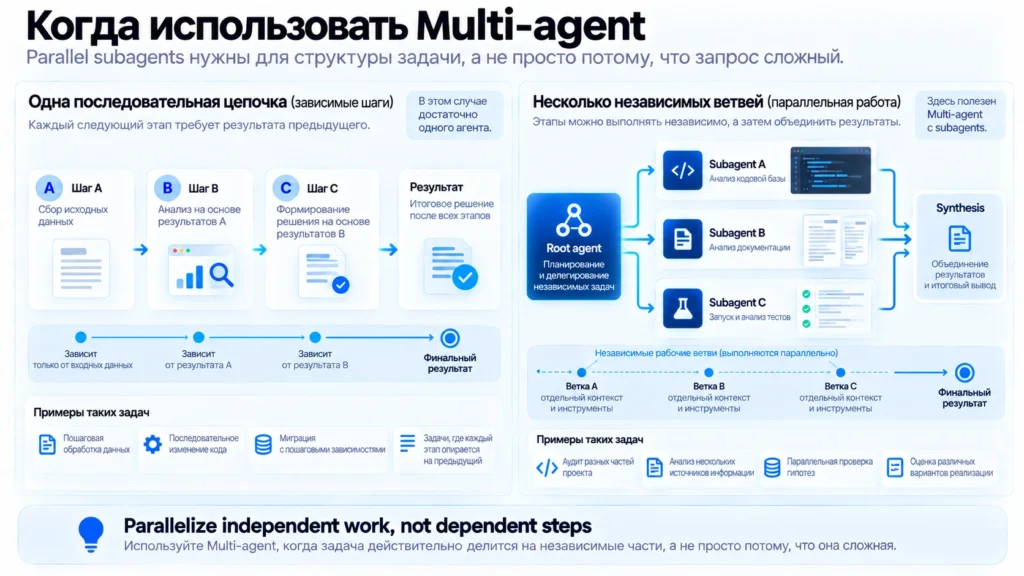
Допустим, задача:
прочитать конфиг → определить версию → найти migration guide → применить нужные изменения.
Шаг B зависит от A.
C зависит от B.
Здесь создание трёх subagents не даёт настоящего параллелизма.
Напротив, появляется coordination overhead.
OpenAI рекомендует один agent, когда этапы прямо зависят друг от друга, задача короткая, agents должны изменять один и тот же mutable resource или требуется фиксированный deterministic execution graph.
И наоборот:
проверь безопасность
+проверь производительность
+проверь тестовое покрытие
для одного pull request — уже естественные независимые направления.
Когда Sol разумнее Astra
Самый очевидный случай — сложная задача повторяется часто.
Если studio каждый день анализирует:
- codebases;
- документацию;
- технические отчёты;
- pull requests;
- browser workflows;
- большие наборы файлов,
то пятикратная разница standard token price между Sol и Astra быстро становится заметной.
Второй случай — качество Astra выше, но бизнес-результат почти не меняется.
Например, Astra получает 96% вашего внутреннего eval, а Sol — 94%, при этом оба проходят обязательные production checks.
Тогда платить пять раз больше за tokens может быть бессмысленно.
Третий случай — нужен именно текущий Responses Multi-agent beta.
GPT-6.1 Sol сейчас входит в официальный список поддерживаемых моделей, Astra — нет.
Но модель всё равно следует выбирать по собственным evals, а не по названию.
Когда Astra лучше
Если задача действительно quality-first и ошибка дорого стоит, Astra остаётся моделью, которую OpenAI рекомендует как максимальный уровень capability.
Это могут быть:
- сложный архитектурный анализ;
- неоднозначная научная задача;
- hardest end-to-end coding;
- профессиональный deliverable с большим количеством пересекающихся ограничений;
- сценарий, где Sol регулярно требует второй попытки, а Astra решает задачу с первого раза.
И здесь появляется важный экономический момент.
Если Astra в пять раз дороже за token, но Sol приходится вызывать шесть раз, реальная экономика уже может оказаться в пользу Astra.
Поэтому правильная метрика:
cost per successful task, а не price per token.
Когда Sol тоже избыточен
На другом конце находится Luna.
GPT-6 Luna стоит $0.10 input и $0.50 output за миллион standard tokens и предназначен для focused, high-volume work. Он также имеет контекст 1.05M и max output 128K.
Если нужно:
- классифицировать тысячи записей;
- извлечь поля;
- сделать простой rewrite;
- проверить формат;
- маршрутизировать заявки;
- выполнять ограниченную повторяемую автоматизацию,
GPT-6.1 Sol может быть неоправданно дорогим.
Это особенно заметно в веб-проектах, где AI часто используется не для сложного reasoning, а для сотен маленьких операций.
Отдельный практический принцип здесь тот же, что и в разработке в целом: AI полезнее всего, когда модель соответствует задаче, а не когда на любой этап ставят максимально мощный вариант. На Vagizov.com это также видно в материале Заменят ли нейросети людей: программисты, музыканты и дизайнеры.
Sol, Multi-agent и Agents API — где проходит граница
Если вы вызываете:
Responses API + gpt-6.1-sol
и модель последовательно работает с tools — это model-driven workflow.
Если включаете:
multi_agent.enabled = true
root model получает возможность создавать subagents внутри Responses request.
Если же требуется:
- durable session;
- long-running task;
- managed environment;
- sandbox;
- recovery;
- отдельный lifecycle агента;
- длительная работа, переживающая один request,
это уже область Agents API, а не просто Multi-agent flag в Responses.
На Vagizov.com материал про Agents API на момент проверки ещё не найден среди опубликованных страниц, поэтому ссылку здесь намеренно не добавляю.
Data residency и Fast mode
GPT-6.1 Sol поддерживает US и EU data residency.
Но есть важное ограничение: Fast mode недоступен при EU data residency.
Также Fast mode тарифицируется вдвое дороже Standard. Batch и Flex, наоборот, стоят примерно на 50% дешевле Standard rates. Regional processing, где доступен, имеет дополнительную наценку.
Это означает, что архитектурный выбор иногда выглядит не просто:
Astra или Sol
а:
Sol Standard
противSol Fast
противSol EU
противBatch/Flex.
Для offline-анализа тысячи документов latency может быть почти неважна.
Для интерактивного developer tool — наоборот.
Как выбирать модель на реальном проекте
Я бы не строил routing по формуле:
простое → Lunaсложное → Solочень сложное → Astra.
Это хороший первый ориентир, но плохая production-система.
Практичнее собрать набор собственных задач.
Например:
- найти bug в большом WordPress theme;
- сравнить две архитектуры API;
- проверить security implications;
- подготовить migration plan;
- обработать сотню однотипных записей;
- исследовать documentation + code + tests.
Для каждой модели замерить:
- выполнение задачи;
- количество ошибок;
- необходимость повторного запуска;
- input/output tokens;
- latency;
- стоимость;
- human review time.
После этого становится видно, что реально требуется проекту.
Вполне возможно, что архитектура окажется смешанной:
Luna — массовая подготовка и triage;
GPT-6.1 Sol — сложный анализ и основная developer automation;
Sol + Multi-agent — большие разделимые исследования;
Astra — наиболее трудные или критичные случаи.
Именно такая система обычно экономичнее, чем попытка выбрать одну универсальную модель на весь продукт.
Главная ценность GPT-6.1 Sol — не в одном benchmark
Официальное позиционирование достаточно ясное: Sol создан для сложной coding, computer-use и professional work, когда нужен близкий к Astra уровень, но стоимость имеет значение.
Multi-agent усиливает это направление, позволяя модели параллельно исследовать независимые части задачи.
Но обе возможности легко использовать неправильно.
Миллионный context не означает, что нужно отправлять миллион токенов.
max reasoning не означает максимальную эффективность.
Три subagents не означают ответ в три раза лучше.
И Sol не является «дешёвой Astra» для абсолютно любого workload.
Правильнее смотреть на него как на рабочую модель для задач, где Luna уже недостаточно, Astra ещё не оправдана, а сложность действительно требует reasoning, tools или параллельного исследования.
И в этом месте GPT-6.1 Sol сейчас выглядит особенно интересно для веб-разработки: большой codebase, документация, browser/tools, независимые проверки и многошаговая диагностика — ровно те задачи, где разница между простым model call и хорошо спроектированным workflow становится наиболее заметной.
FAQ
Что важно знать перед переходом на GPT-6.1 Sol
OpenAI позиционирует Astra как самую мощную модель для наиболее сложной работы, а GPT-6.1 Sol — как вариант с near-Astra performance при меньшей стоимости. У обеих моделей контекст 1.05M и max output 128K, но стандартная цена Sol существенно ниже.
Для Standard processing и запросов до 272K input стандартная ставка — $2 за 1M input tokens, $0.10 за cached input, $2.50 за cache writes и $10 за 1M output. При input больше 272K весь запрос тарифицируется дороже: input/cache — ×2, output — ×1.5.
low, medium, high, xhigh и max; значение по умолчанию — medium. none и minimal для GPT-6.1 Sol не поддерживаются. Более высокий effort даёт модели больше времени на планирование и проверку, но увеличивает latency и token usage.
Нет. Multi-agent beta — функция Responses API, где один root model создаёт subagents внутри конкретного response workflow. Agents API — отдельная managed infrastructure с sessions, environments, recovery и другим agent harness. Это разные уровни абстракции.
Нет. OpenAI рекомендует его для независимых workstreams: разных частей codebase, документов, гипотез или test suites. Если каждый шаг зависит от предыдущего, один agent обычно проще, дешевле и предсказуемее.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.