Каннибализация запросов заметна обычно не в тексте страницы, а в данных: по важному запросу то показывается одна посадочная, то другая, либо видимость распределена между несколькими URL, хотя бизнесу нужен один основной ответ.
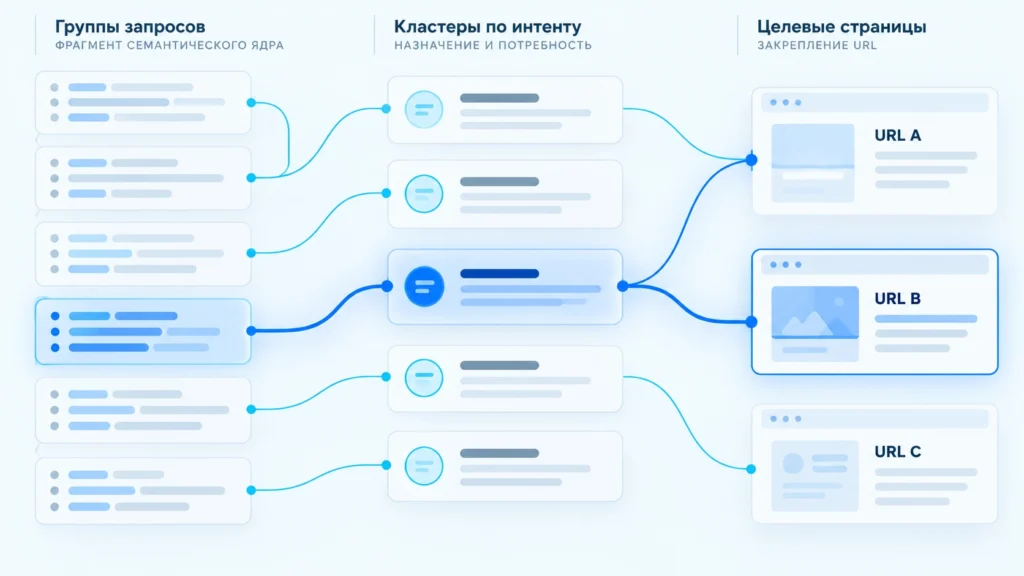
Но два URL одного сайта по одной фразе — ещё не диагноз. Страницы могут закрывать разные намерения пользователя, а поисковая система вправе считать полезными обе. Поэтому проверять нужно не совпадение ключей, а связку запрос → интент → страница → фактическое поведение в выдаче.
Каннибализация запросов: где начинается реальный конфликт
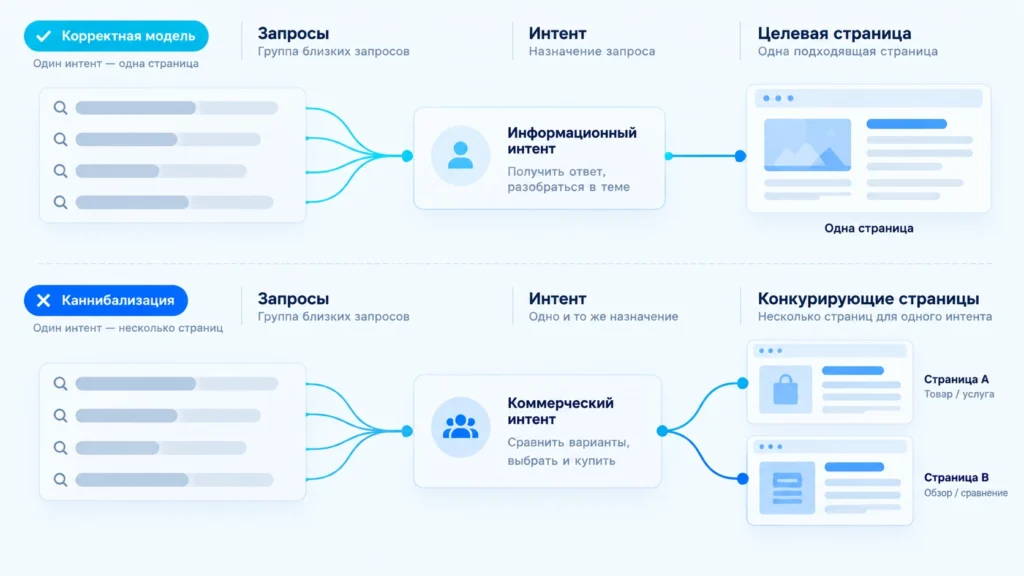
В практическом SEO каннибализацией удобно называть ситуацию, когда два или более URL претендуют на одну и ту же поисковую задачу и отдельное существование этих страниц не даёт понятной пользы пользователю.
Например, на сайте одновременно существуют:
/seo-prodvizhenie/— услуга SEO-продвижения;/seo-prodvizhenie-sayta/— почти такая же услуга;/blog/seo-prodvizhenie/— статья, которая фактически тоже продаёт услугу и оптимизирована под тот же коммерческий интент.
Само присутствие общей лексики ничего не доказывает. Статья «как выбрать SEO-подрядчика» и страница услуги могут пересекаться по словам, но выполнять разные задачи. Гораздо подозрительнее две посадочные с одинаковым предложением, структурой и набором целевых запросов.
Почему несколько URL в выдаче не означают проблему автоматически
Поисковая система оценивает документы и выбирает результаты под конкретный запрос. Google отдельно использует систему разнообразия результатов: обычно верхняя часть выдачи не должна быть заполнена большим количеством страниц одного сайта, хотя для особенно релевантных случаев возможны исключения.
Поэтому наличие двух URL домена в результатах может быть совершенно нормальным. Например, по широкому запросу один документ отвечает на информационную часть задачи, а второй ведёт на подходящий сервис.
Отдельная ситуация — настоящие дубли. Если содержание нескольких URL одинаковое или очень похожее, Google может объединять их в кластер и выбирать канонический документ. Это уже задача каноникализации, а не доказательство того, что две полноценные самостоятельные страницы «отбирают позиции» друг у друга.
В Яндексе логика с дублями также выделена отдельно: похожие документы могут объединяться, а один из них выбирается для участия в поиске. Если же страницы не объединены и остаются отдельными документами, Яндекс прямо допускает их конкуренцию между собой.
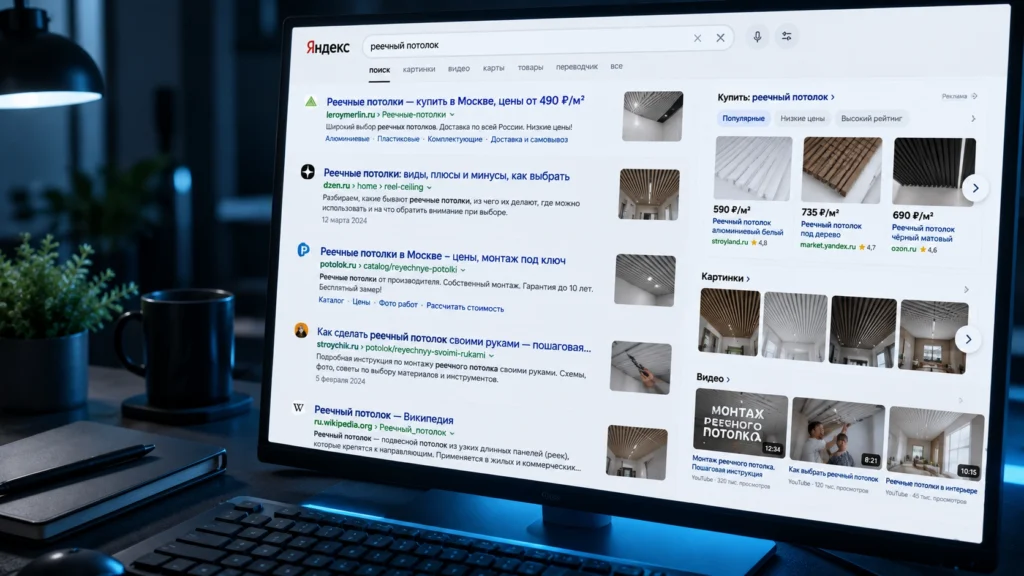
При разборе выдачи стоит фиксировать не только обычные результаты. В рабочей таблице полезна отдельная колонка «блоки поисковой выдачи примеры», чтобы не смешивать классические ссылки с другими форматами SERP.
Как проверить конфликт по данным, а не по ключевым словам
Начать проще всего с запросов, для которых уже есть показы. В Google Search Console можно отфильтровать отчёт эффективности по конкретной фразе, а затем посмотреть данные в разрезе страниц.
Если один запрос получает показы по нескольким URL, это только кандидат на проверку. Для каждой пары нужно выяснить четыре вещи:
- одинаковый ли поисковый интент закрывают страницы;
- какая страница соответствует этому интенту лучше;
- стабильно ли поисковик выбирает один URL или страницы регулярно сменяют друг друга;
- что происходит с суммарными показами, кликами и позициями.
Важно учитывать особенности самих данных Search Console. Не все запросы отображаются в таблицах, а большая часть статистики по дублирующим URL относится к каноническому адресу. Поэтому отчёт нельзя воспринимать как полный технический реестр всех пересечений сайта.
В Яндекс Вебмастере задачу удобно проверять с другой стороны: сервис позволяет анализировать поисковые запросы и URL страниц, которые по ним показываются. Это помогает увидеть, какая страница фактически получает видимость по нужной группе.
Модификаторы запросов помогают развести страницы
Одинаковая базовая фраза может превращаться в разные задачи после добавления модификатора: «цена», «заказать», «как выбрать», «что это», «сравнение», название региона или конкретной технологии.
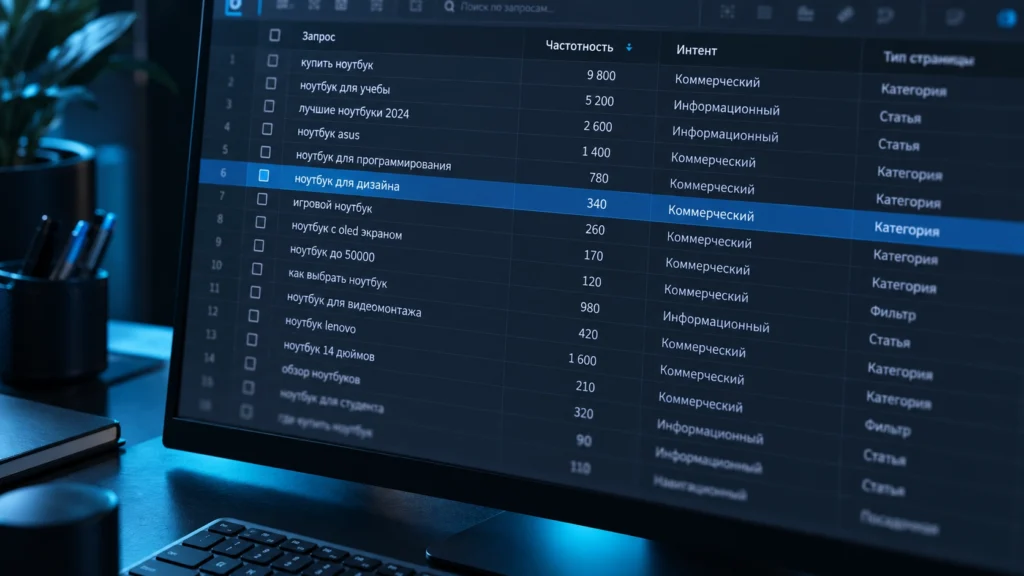
Именно поэтому семантику нельзя распределять только по совпадению слов. Например, среднечастотные запросы внутри одного тематического направления могут относиться к нескольким интентам и требовать разных типов страниц.
Подсказки самой выдачи тоже помогают увидеть язык пользователя. Например, блок люди также ищут способен подсказать соседние формулировки, но окончательное решение о структуре всё равно нужно принимать по интенту и фактическим данным сайта.
Объединить, развести или ничего не менять
После диагностики возможны три основных решения.
| Ситуация | Что делать |
|---|---|
| Страницы решают разные задачи | Оставить обе и сильнее развести интент, содержание и внутренние связи |
| Страницы фактически дублируют одну задачу | Объединить полезный материал на основном URL и при необходимости настроить постоянный редирект |
| Один URL является технической копией другого | Проверить каноникализацию, редиректы и причины появления дубля |
| Несколько URL получают показы, но каждый стабилен в своей группе запросов | Не исправлять то, что не доказано как проблема |
rel="canonical" не стоит использовать как универсальный переключатель «назначить нужную страницу по ключу». Для поисковых систем это прежде всего механизм работы с дублирующими или очень похожими URL.
Точно так же noindex не должен становиться способом скрыть неудобную страницу, которая на самом деле нужна пользователю. Сначала следует решить архитектурный вопрос: зачем существуют оба документа.
Практический пример: статья начинает конкурировать со страницей услуги
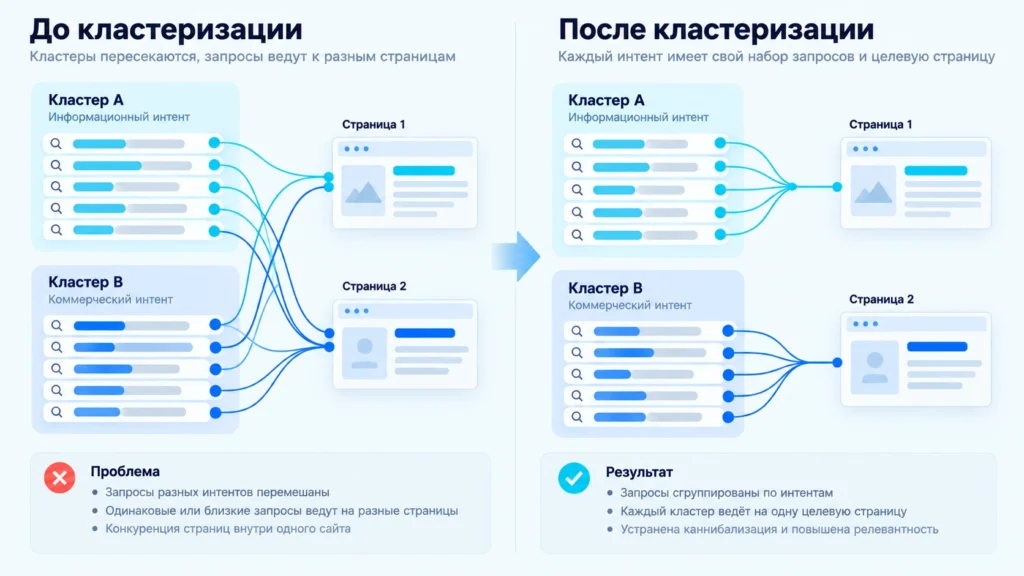
Представим страницу услуги «SEO-продвижение сайта» и большой информационный материал с очень похожим названием. Со временем статья расширилась: в ней появились цены, преимущества работы, коммерческие призывы и описание процесса заказа.
В Search Console видно, что по коммерческой группе запросов показы получает то услуга, то статья. При этом статья не даёт пользователю полноценного коммерческого сценария, а страница услуги периодически теряет долю показов.
В таком случае совпадение URL по одному запросу уже подкреплено вторым признаком — пересечением интента. Логичное решение: вернуть статье информационную специализацию, оставить на ней вопросы выбора и объяснения, а коммерческие блоки сосредоточить на услуге. Если же документы почти полностью повторяют друг друга и отдельная статья не решает самостоятельной задачи, разумнее рассмотреть объединение.
После изменения нельзя делать вывод по одной позиции на следующий день. Нужно сравнивать период до и после правки и смотреть, закрепился ли правильный URL, сохранилась ли суммарная видимость и не потеряны ли запросы, которые раньше действительно требовали второй страницы.
Какие ошибки превращают аудит в лишнюю переделку сайта
Главная ошибка — считать каннибализацией любой запрос с двумя URL. Такая логика быстро приводит к ненужным редиректам и объединению страниц, которые закрывали разные задачи.
Вторая ошибка — принимать совпадение title, H1 или ключевой фразы за достаточное доказательство. Эти признаки полезны для первичного поиска кандидатов, но диагноз ставится после анализа интента и поисковых данных.
Третья — использовать canonical или noindex до решения вопроса о назначении страницы. Техническая директива не заменяет нормальную информационную архитектуру.
Четвёртая — оценивать результат только по позиции одного URL. Цель исправления не в том, чтобы «убрать вторую страницу из отчёта», а в том, чтобы поисковому спросу соответствовала понятная структура сайта без потери полезного охвата.
Если пересечение затрагивает десятки кластеров, коммерческие посадочные и общую структуру сайта, точечной правки одного URL обычно недостаточно. В таком случае комплексное SEO-продвижение сайта уместно как системная работа: сначала разводятся роли страниц и поисковые интенты, затем корректируются структура и контент, а результат проверяется по запросам, показам, кликам и выбранным поиском URL.
Что считать успешным исправлением
Хороший результат — это не обязательно один URL на каждое слово. Важнее, чтобы для каждого самостоятельного интента существовала понятная страница и поисковая система стабильно сопоставляла её с подходящей группой запросов.
Если после изменений нужный документ получает основную видимость по своему интенту, второй URL сохранил собственную полезную семантику либо корректно выведен из структуры, а суммарные клики и показы не просели, проблему можно считать решённой.
Каннибализацию поэтому лучше воспринимать не как «штраф за одинаковые ключи», а как проверку качества архитектуры: насколько ясно сайт объясняет поисковой системе и пользователю, какая страница предназначена для каждой конкретной задачи.
FAQ
Когда пересечение страниц действительно требует исправления
Это ситуация, когда несколько страниц одного сайта фактически пытаются закрыть один и тот же поисковый интент. Проблемой она становится не из-за повторения ключевой фразы, а когда поисковой системе трудно стабильно сопоставить запрос с нужной страницей или выбранный URL не соответствует вашей структуре.
Автоматического правила «два URL — позиции падают» нет. Несколько страниц одного сайта могут появляться по одному запросу без негативного эффекта. Риск возникает при реальном пересечении назначения страниц, нестабильном выборе URL или наличии практически дублирующих документов.
Отфильтруйте отчёт эффективности по интересующему запросу и изучите вкладку страниц. Если показы получают несколько URL, сравните периоды и проверьте, относятся ли страницы к одному интенту. Учитывайте, что Search Console не показывает все запросы, а часть данных по дублирующим URL агрегируется на канонической странице.
Не по умолчанию. rel="canonical" предназначен прежде всего для дублирующих или очень похожих версий контента. Если страницы самостоятельные и должны оставаться в поиске, правильнее развести их интенты и содержание либо объединить материалы, если отдельные URL действительно не нужны.
Сначала выберите страницу, которая должна закрывать этот интент. Затем либо объедините ценную информацию и перенаправьте лишний URL, либо чётко разведите задачи двух страниц. После изменений сравните данные по запросам, URL, кликам и показам с периодом до исправления.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.