15 сентября, 2026 года
 8 мин
 61 просмотр
Семантическое ядро нужно, чтобы превратить поисковый спрос в понятную структуру сайта. В него входят не просто найденные фразы, а очищенные и сгруппированные запросы, для которых определены интент, приоритет и подходящая страница.
Поэтому файл на 50 тысяч строк ещё не становится качественным ядром автоматически. Ценность появляется после ответа на более неприятный вопрос: зачем каждая группа запросов нужна сайту и какой URL должен полноценно решать стоящую за ней задачу.
Что такое семантическое ядро
В прикладном SEO семантическое ядро — структурированный набор поисковых формулировок, описывающий спрос вокруг товаров, услуг, тем и проблем аудитории.
Обычно в рабочей таблице фиксируют:
| Поле | Для чего нужно |
|---|---|
| Запрос | Реальная или рабочая поисковая формулировка |
| Спрос | Помогает оценить масштаб интереса |
| Регион | Позволяет отделить локальный спрос |
| Интент | Показывает задачу пользователя |
| Кластер | Объединяет близкие формулировки |
| URL | Закрепляет группу за страницей |
| Статус | Создать, обновить, объединить или оставить |
Яндекс Вебмастер официально использует сходную логику группировки: его инструмент подбора запросов автоматически объединяет формулировки, близкие по смыслу или намерению пользователя. При этом показатели спроса, кликов и конкурентности в этом инструменте рассчитываются как среднемесячные значения за прошлый год.
Это полезное подтверждение самого принципа. Но готовую архитектуру проекта автоматический кластер всё равно не определяет: одна и та же тематика у интернет-магазина, сервиса и информационного сайта может требовать разной структуры.
Как семантическое ядро связано с поисковым спросом и SEO
Основа ядра — реальные формулировки спроса.
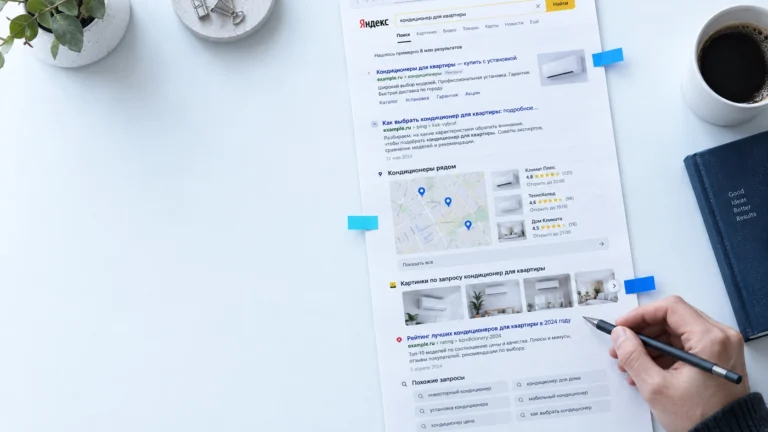
Для Яндекса одним из первичных источников служит яндекс wordstat. Сервис показывает статистику запросов, изменение интереса, региональные различия, популярные и похожие формулировки.
Для работающего сайта этого мало. Нужно понять ещё и то, по каким запросам страницы уже получают поисковую видимость.
Google Search Console показывает запросы, страницы, клики, показы, CTR и среднюю позицию. Google прямо предлагает использовать Queries для поиска формулировок, по которым сайт появляется в выдаче, а Pages — для анализа конкретных URL.
При этом Search Console не является полным справочником всех запросов: часть анонимизируется ради конфиденциальности, а таблица содержит не абсолютно все строки.
Поэтому нормальное ядро обычно складывается из нескольких слоёв:
- внешнего спроса;
- фактических запросов сайта;
- бизнес-терминологии;
- анализа выдачи;
- ручной проверки интента.

Как собрать семантическое ядро
Работа начинается с карты бизнеса или тематики.
Для магазина выписывают категории, типы товаров, характеристики и задачи покупателей. Для сервисного сайта — услуги, проблемы клиентов и географию. Для информационного проекта — основные темы и вопросы аудитории.
После этого начинается сбор семантики.
1. Подготовить исходные формулировки
Допустим, сайт оказывает услуги по кондиционерам.
Стартовые фразы:
установка кондиционеровремонт кондиционеровобслуживание кондиционеровчистка кондиционеров
Этого достаточно, чтобы начать расширение.
2. Расширить список через данные о спросе
В Wordstat можно получить популярные запросы с исходной фразой, похожие варианты, данные по регионам и динамику. Результаты Топов запросов и других основных отчётов доступны для выгрузки в CSV.
Для более точной проверки формулировок сервис поддерживает операторы -, !, +, кавычки, квадратные скобки, круглые скобки и |.
При оценке отдельных групп полезна частотность запросов, но сама цифра ещё не определяет, какая страница нужна и насколько ценен трафик для бизнеса.
3. Добавить запросы действующего сайта
Если ресурс уже работает, проверьте Search Console и Яндекс Вебмастер.
В Search Console полезно искать:
- неожиданные запросы;
- фразы с большим числом показов;
- запросы, по которым один URL уже получает видимость;
- группы близких формулировок.
Google позволяет выбрать конкретный query и затем открыть Pages, чтобы увидеть страницы сайта, показанные по этому запросу.
4. Очистить массив
Сырой список обычно содержит лишнее.
Убираются:
- чужая тематика;
- ненужная география;
- омонимия;
- дубли;
- вакансии и обучение, если сайт продаёт услугу;
- товары, которых компания не предлагает;
- информационные запросы, которые проект сознательно не планирует закрывать.
Это не косметический этап. Ошибка очистки потом размножается в структуре сайта.
Как кластеризовать запросы
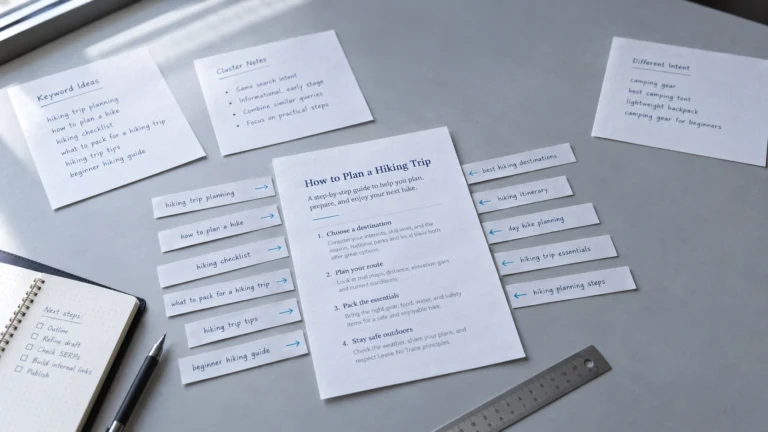
После очистки начинается кластеризация запросов.
Сначала запросы объединяются по смыслу и предполагаемому интенту.
Например:
установка кондиционерамонтаж кондиционераустановка сплит системы
могут относиться к одной услуге.
А запрос:
как установить кондиционер самостоятельно
уже выражает другую задачу.
Яндекс Вебмастер формально определяет кластеризацию как автоматическую группировку запросов, близких по смыслу или интенту.
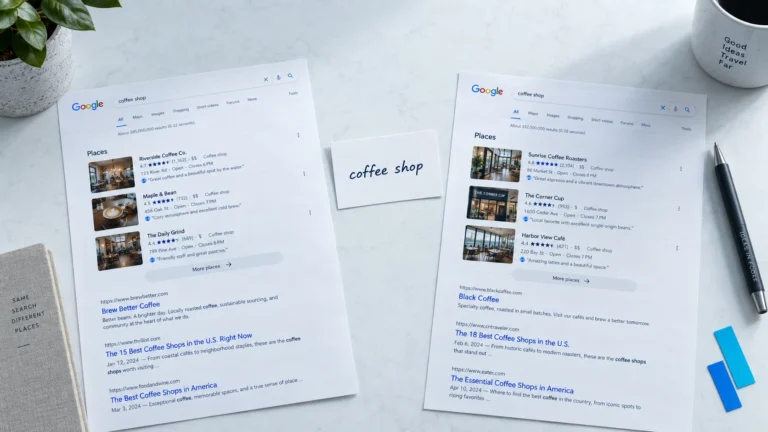
Для спорных случаев используют проверку выдачи. Если по двум фразам поисковики стабильно показывают страницы одного типа и значительная часть результатов совпадает, это дополнительный аргумент в пользу общего URL.
Такой SERP-анализ является практическим SEO-методом, а не опубликованной формулой ранжирования Google или Яндекса.

Как превратить ядро в структуру сайта
После группировки у каждого кластера должно появиться назначение.
Рабочая цепочка выглядит так:
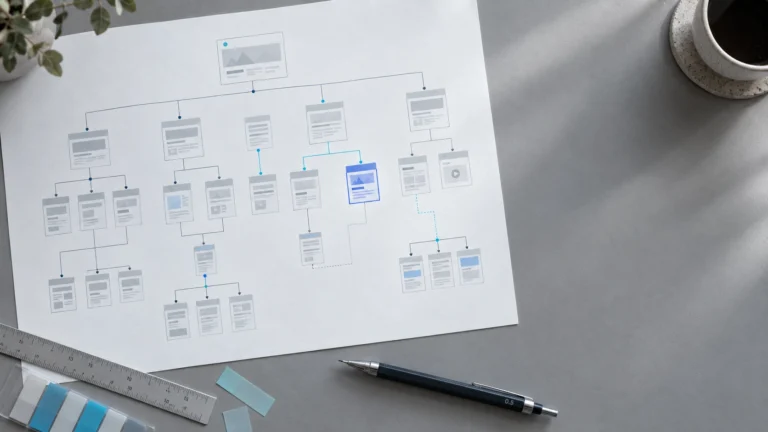
спрос → запросы → интент → кластер → тип страницы → URL

Для каждой группы дальше принимается одно из решений:
- оставить существующую страницу;
- обновить её;
- создать новый URL;
- объединить несколько слабых страниц;
- исключить кластер как нерелевантный бизнесу.
Это и есть момент, когда семантическое ядро начинает приносить практическую пользу.
Само наличие таблицы с ключами позиции не повышает. Ядро помогает проектировать релевантные страницы и понимать спрос, а итоговое ранжирование определяется поисковой системой по множеству сигналов.
Как использовать семантику в контенте
Группа запросов помогает понять главную задачу страницы и связанные вопросы.
Например, коммерческий кластер:
ремонт холодильниковмастер по ремонту холодильниковремонт холодильника на дому
подсказывает направление страницы услуги.
Но из него не следует техническое задание вставить каждую фразу по пять раз.
Google рекомендует анализировать формулировки, которыми аудитория ищет содержание, но его системы способны понимать близкие варианты запросов. В Search Console Google также прямо предлагает группировать похожие формулировки регулярными выражениями при анализе данных.
Рабочий подход проще: страница должна естественно и полно отвечать на общий интент кластера.
Практический пример
Представим сервисный сайт по ремонту бытовой техники. Проектные данные к редакционной строке отсутствуют, поэтому цифры ниже иллюстративные.
На первом этапе собрано 1 250 запросов.
После очистки получилось:
| Этап | Запросов |
|---|---|
| Исходный массив | 1 250 |
| После удаления чужих регионов | 1 080 |
| После удаления нерелевантной тематики | 870 |
| После дублей и явного мусора | 760 |
| После смысловой проверки | 720 |
Затем 720 запросов группируются по задачам.
Появляются кластеры:
- ремонт холодильников;
- ремонт стиральных машин;
- ремонт посудомоечных машин;
- отдельные неисправности;
- информационные инструкции.
Внутри холодильников обнаруживаются запросы ремонт холодильника и ремонт холодильника на дому. По смыслу они близки, а выдача показывает одинаковый тип коммерческих страниц. Их рационально оставить в одной группе.
Запрос почему холодильник не морозит показывает уже смешанную, преимущественно информационную выдачу. Его выделяют в отдельный кластер статьи.
После этого ядро содержит не 720 будущих страниц, а ограниченный набор смысловых групп.

Как проверить готовое семантическое ядро
Перед передачей структуры в разработку или редакцию полезно пройти короткую проверку.
У каждого важного кластера должны быть:
- понятный интент;
- подходящий тип страницы;
- один основной целевой URL;
- релевантные дополнительные запросы;
- подтверждённая бизнес-ценность;
- понятный приоритет.
Для уже работающего сайта модель стоит сравнить с реальными данными Search Console.
Отчёт Performance позволяет группировать данные по queries и pages, анализировать показы, клики, CTR и среднюю позицию. Google отдельно рекомендует при исследовании страницы проверять запросы, по которым она появляется, а при исследовании запроса — страницы, которые по нему показываются.
Так можно обнаружить две противоположные проблемы: один запрос размазан между несколькими страницами либо одна страница получает видимость по совершенно разным задачам.
Типичные ошибки при работе с семантикой
Первая ошибка — считать размер ядра показателем качества. Сто тысяч строк выглядят внушительно, даже если половина относится к чужому интенту.
Вторая — проектировать структуру непосредственно из Wordstat. Сервис показывает спрос, но не принимает за владельца сайта решение о количестве страниц.
Третья — строить всё только по частотности. Более редкий коммерческий запрос способен быть важнее широкой информационной формулировки.
Четвёртая — полностью доверять автоматической кластеризации. Алгоритм ускоряет работу, но спорные группы стоит сверять с выдачей и бизнес-логикой.
Пятая — создавать отдельный URL под каждую словоформу. Близкие запросы часто относятся к одной задаче и одной странице.
Шестая — превращать ядро в норматив повторений слов в тексте. Задача семантики — определить спрос, интент и структуру, а не устроить соревнование по плотности ключей.
Седьмая — собрать ядро один раз и забыть. Спрос меняется, появляются новые товары и услуги, а действующие страницы начинают получать новые запросы. Поэтому семантика требует периодической сверки с поисковой аналитикой.
Вывод: что делать на практике
Семантическое ядро стоит строить не вокруг количества собранных ключей, а вокруг структуры спроса.
Начните с тем бизнеса, расширьте их через Wordstat и данные действующего сайта, очистите массив и определите интент. Затем сгруппируйте близкие запросы, проверьте спорные кластеры по выдаче и закрепите их за существующими или будущими страницами.
Готовое ядро должно отвечать на три вопроса: что ищет пользователь, какую задачу он решает и какая страница сайта отвечает за этот спрос. Если таблица умеет отвечать только на вопрос «сколько строк получилось», работа пока закончилась примерно на середине.
Материал подготовлен Максимом Вагизовым для vagizov.com . При цитировании обязательна активная ссылка на источник.
Подробнее об авторских правах