Сбор семантики для SEO
Сбор семантики это процесс получения поисковых формулировок, которые описывают реальный спрос вокруг товаров, услуг, проблем и тем сайта.
На этом этапе специалист ещё не должен создавать отдельную страницу под каждую найденную фразу. Первичная задача состоит в другом: максимально полно обнаружить релевантные способы, которыми пользователи формулируют свои задачи, а затем очистить полученный массив и подготовить его к дальнейшему анализу.
Рабочая последовательность выглядит так:
тематика → исходные формулировки → расширение → очистка → интент → кластеризация → страницы
На Vagizov.com сбор семантики является самостоятельной taxonomy внутри раздела «Семантика». На момент актуальной проверки здесь опубликовано шесть материалов. Они отдельно раскрывают поисковые подсказки Яндекса, похожие запросы, маски ключевых слов, расширение семантики, минус слова в Wordstat и общий процесс сбора.
Поэтому эта taxonomy должна оставаться центральной страницей именно о получении и первичной обработке массива запросов, не дублируя подробные инструкции по каждому отдельному инструменту.
Сбор семантики и семантическое ядро не одно и то же
Сбор является этапом процесса.
Семантическое ядро является уже обработанным результатом.
Сырой файл из Wordstat на несколько тысяч строк ещё нельзя считать полноценным ядром.
В нём могут находиться:
нерелевантные темы
чужие товары
другая география
информационные вопросы
коммерческие запросы
брендовые формулировки
дубли
опечатки
разные пользовательские задачи
формулировки с практически одинаковым смыслом
После очистки, определения интента, кластеризации и привязки групп к страницам массив превращается в рабочую семантическую модель сайта.
На Vagizov.com «Семантическое ядро» уже существует как отдельная taxonomy. В опубликованном материале ядро определяется как структурированный набор запросов и тем, связанных с задачами пользователей и конкретными страницами сайта.
Следовательно, текущая тема должна отвечать прежде всего на вопрос:
откуда получить качественный исходный материал для дальнейшей работы.
С чего начинается сбор семантики
Сбор не должен начинаться со случайного высокочастотного слова.
Сначала определяется сегмент бизнеса или тематическая область.
Например, для веб студии отдельными направлениями могут быть:
разработка сайтов
SEO продвижение
техническая поддержка
WordPress
аудит сайта
Каждое направление затем исследуется отдельно.
Для интернет магазина стартовыми сегментами могут стать категории товаров.
Для информационного проекта это крупные тематические хабы.
Для сервиса услуг отдельные направления обычно соответствуют реальным услугам, проблемам клиентов и объектам работ.
Чем точнее определён сегмент, тем меньше мусора появится в исходной выгрузке.
Нельзя собирать весь рынок одной фразой
Широкий запрос часто создаёт слишком разнородный список.
Например:
сайт
может привести к формулировкам о разработке, входе на конкретный ресурс, создании сайта самостоятельно, вакансиях, дизайне, хостинге и множестве других задач.
Для студии разработки значительно полезнее начинать с более конкретных направлений:
разработка сайтов
создание интернет магазина
разработка корпоративного сайта
доработка WordPress
После этого каждое направление расширяется отдельно.
Так проще контролировать релевантность и понимать происхождение запроса.
Сидовые запросы
Сидовыми называют базовые формулировки, с которых начинается расширение семантики.
Это отраслевой рабочий термин.
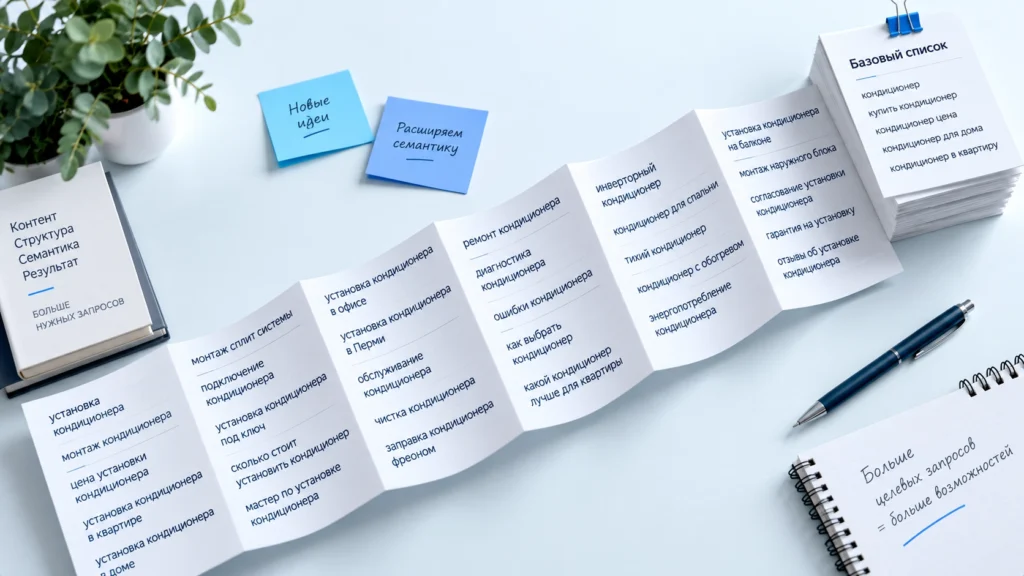
Например, для сервиса кондиционеров начальный набор может выглядеть так:
установка кондиционеров
ремонт кондиционеров
обслуживание кондиционеров
чистка кондиционеров
Эти фразы ещё не являются готовой структурой сайта.
Они используются как отправные точки для поиска реальных пользовательских запросов.
Хороший seed набор охватывает основные направления бизнеса и при этом не пытается заранее перечислить все длинные хвосты.
Маски ключевых слов
Для крупной тематики удобно использовать маски.
Маска задаёт повторяемую модель запроса.
Например:
услуга + объект
товар + характеристика
проблема + объект
услуга + город
бренд + модель
действие + продукт
На Vagizov.com маскам уже посвящён отдельный материал taxonomy. Там они рассматриваются как исходные формулировки и модели, из которых получают более подробные запросы, а не как самостоятельный фактор ранжирования.
Поэтому на уровне основной страницы достаточно понимать их функцию.
Маски помогают не забыть целые сегменты спроса.
Сначала нужно собрать словарь предметной области
Перед массовым расширением полезно выписать основные сущности бизнеса.
Например:
услуги
товары
категории
характеристики
бренды
модели
проблемы
сценарии использования
географию
профессиональные термины
разговорные формулировки
Если сайт посвящён отоплению, пользователь может искать не только официальное название оборудования, но и бытовое описание проблемы.
Если проект работает с программным обеспечением, запросы могут включать как название функции, так и текст конкретной ошибки.
Такой словарь становится основой масок.
Источники семантики нужно комбинировать
Один инструмент редко показывает весь полезный спрос.
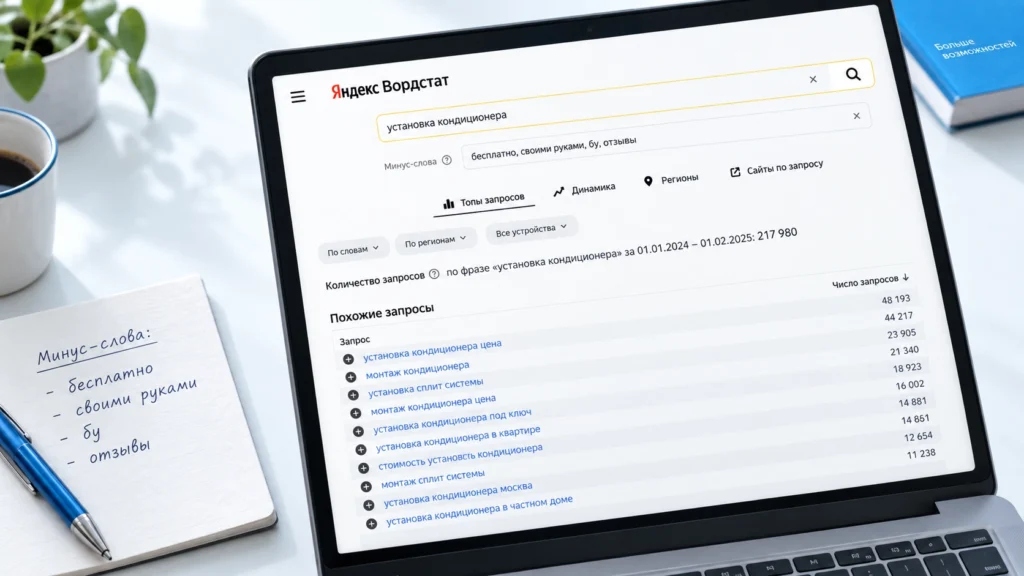
Wordstat хорошо подходит для исследования запросов Яндекса.
Яндекс Вебмастер показывает как внешние идеи для запросов, так и фактические данные собственного сайта.
Google Search Console показывает запросы, по которым сайт уже получает показы в Google.
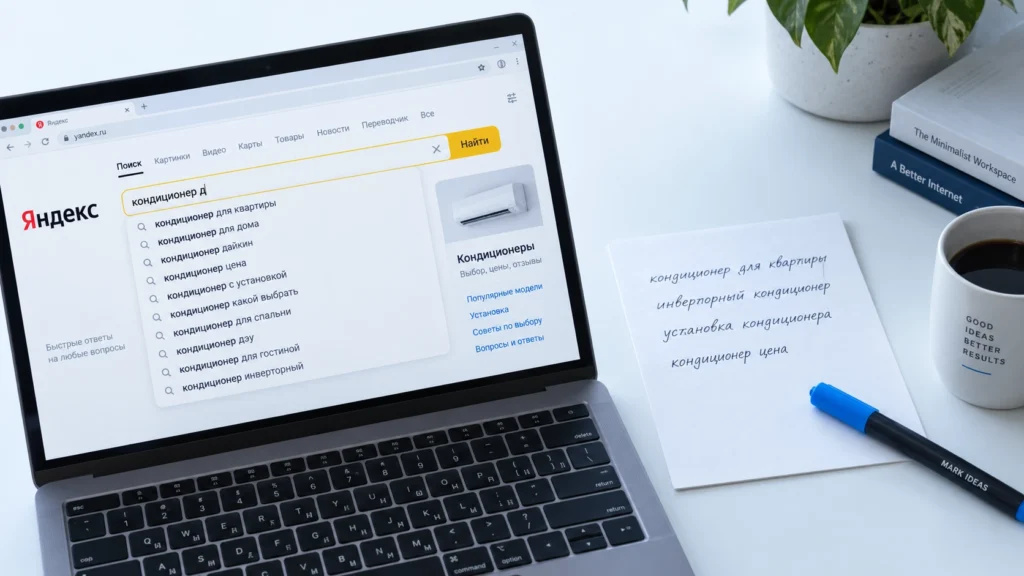
Поисковые подсказки помогают находить формулировки, возникающие при вводе запроса.
Похожие запросы позволяют выйти за пределы буквального повторения исходных слов.
Собственный сайт показывает уже существующие темы и страницы.
Конкурентная выдача помогает обнаружить направления, которые могли отсутствовать в исходном плане.
Полезная семантика появляется после объединения этих источников и последующей очистки.
Яндекс Wordstat
Wordstat является одним из основных источников запросов для русскоязычного SEO.
Сервис показывает статистику поисковых запросов Яндекса и позволяет анализировать формулировки, динамику и региональные различия.
В актуальном интерфейсе доступны данные о популярных запросах с исходной фразой и похожих запросах. Можно учитывать регион и устройство, анализировать динамику и выгружать результаты.
Wordstat полезен для двух основных задач.
Первая:
найти реальные варианты исходной темы.
Вторая:
оценить масштаб и структуру спроса.
Но выгрузку Wordstat нельзя сразу превращать в список будущих страниц.
Каждая строка ещё требует проверки.
Что означает число в Wordstat
Частотность необходимо интерпретировать в контексте конкретного режима и формулировки.
Если введена широкая фраза, результат может включать множество запросов с дополнительными словами.
Поэтому число рядом с исходным выражением не означает автоматически:
столько пользователей перейдут на будущую страницу.
Частотность описывает поисковый спрос внутри методики Wordstat.
Для оценки реального потенциала сайта дальше учитываются:
интент
регион
конкуренция
тип SERP
CTR
позиция
доля доступного рынка
Количество найденных запросов и потенциальный SEO трафик являются разными величинами.
Регион при сборе семантики
Для локального бизнеса регион нужно определять до массовой выгрузки.
Запрос:
ремонт холодильников
в Москве и небольшом городе представляет разные рынки.
Если бизнес работает только в одном регионе, общероссийская статистика способна значительно исказить оценку.
Wordstat позволяет анализировать запросы по регионам и городам.
Яндекс Вебмастер также позволяет учитывать регион при анализе запросов сайта.
Поэтому география является параметром сбора, а не уточнением, которое добавляется после завершения ядра.
Устройство тоже может быть полезно учитывать
Для большинства обычных SEO задач нет необходимости создавать отдельное семантическое ядро для desktop и мобильных устройств.
Но данные по устройствам могут помогать в отдельных тематиках.
Например, запросы, связанные с мобильными приложениями, навигацией, локальными услугами или срочными задачами, способны иметь заметно отличающийся спрос на смартфонах.
Wordstat позволяет фильтровать данные по типу устройства.
Яндекс Вебмастер и Google Search Console также предоставляют соответствующие разрезы для фактической поисковой видимости сайта.
Это дополнительный слой анализа, а не обязательное усложнение каждого проекта.
Динамика спроса
Одного текущего месяца иногда недостаточно.
Для сезонной тематики спрос способен значительно изменяться.
Например:
кондиционеры
дачные работы
отопление
подарки
туризм
школьные товары
Если собрать семантику только в пиковый месяц, можно переоценить постоянный спрос.
Если исследовать рынок в низкий сезон, можно недооценить его.
Wordstat предоставляет динамику запросов по времени, поэтому важные формулировки можно проверять не только по текущему значению.
Подробный анализ сезонности уже относится к отдельной taxonomy «Сезонность».
Похожие запросы Wordstat
Похожие запросы особенно полезны, когда пользователи используют другую лексику.
Например, исходная формулировка:
моющий пылесос
а связанный вариант:
пылесос с влажной уборкой
Буквального совпадения мало, но задача близкая.
На Vagizov.com этому источнику уже посвящён отдельный материал. Его основная логика состоит в том, что похожая формулировка является кандидатом на анализ, а не готовой новой страницей.
После получения такого запроса необходимо проверить:
релевантность
спрос
интент
выдачу
подходящий URL
Подсказки поисковой системы
Autocomplete помогает обнаруживать реальные варианты формулировок.
Пользователь начинает вводить:
как настроить
и поисковая система предлагает продолжения.
Для SEO эти варианты полезны как источник гипотез.
Но появление фразы в подсказке не является доказательством высокой частотности или необходимости отдельной страницы.
На Vagizov.com подсказкам Яндекса уже посвящён отдельный материал текущей taxonomy. В нём используется именно такая последовательность:
подсказка → проверка спроса → анализ интента → решение по странице
Поэтому основной SEO текст не должен повторять подробный способ выгрузки подсказок.
Яндекс Вебмастер для поиска новых запросов
Актуальный Яндекс Вебмастер содержит отдельный инструмент подбора поисковых запросов и анализа рынка.
Он позволяет ввести исходные слова ниши и получить основные и дополнительные запросы.
Для них сервис показывает данные о спросе, кликах, конкурентности и кластере. Дополнительные запросы помогают находить неочевидные формулировки, которые невозможно получить простым добавлением слов к исходной фразе.
Это делает Вебмастер полезным не только для мониторинга собственного сайта, но и для расширения семантики.
Но автоматически предложенный кластер не означает, что структура сайта уже спроектирована.
Окончательное решение по URL требует проверки бизнес логики и SERP.
Яндекс Вебмастер для существующего сайта
Для работающего проекта особенно ценны реальные запросы, по которым сайт уже появляется в Яндексе.
Вебмастер позволяет анализировать данные в разрезе запросов и URL. Для запросов доступны поисковые показатели, включая показы, клики, CTR и позиции.
Так можно обнаружить формулировки, которые специалист не включил в первоначальный список.
Например, страница уже получает показы по неожиданному вопросу.
Это может означать:
существующая страница частично закрывает тему
на сайте отсутствует важный самостоятельный материал
поисковая система иначе интерпретирует содержание страницы
нужно просто дополнить текущую семантическую группу
Дальнейшее решение принимается после проверки интента.
Google Search Console
Для существующего сайта Search Console является основным источником фактических запросов Google.
Performance report показывает запросы, по которым сайт появлялся в Search, а также клики, показы, CTR и среднюю позицию. Данные можно группировать по Queries, Pages, Countries, Devices и другим измерениям.
Это позволяет находить дополнительную семантику уже опубликованных страниц.
Например, можно выбрать конкретный URL и посмотреть запросы, по которым он получает показы.
Или выбрать запрос и проверить, какие страницы сайта появляются по нему.
Такой анализ особенно полезен при расширении существующей структуры.
Search Console не показывает весь поисковый спрос Google
Это важное ограничение.
Нельзя выгрузить запросы из Search Console и назвать их полным семантическим ядром рынка.
Google указывает, что часть запросов скрывается для защиты конфиденциальности. Кроме того, из-за внутренних ограничений в таблице показываются не все строки данных.
Search Console описывает фактическую видимость конкретного сайта.
Если сайт пока вообще не имеет страницы по важной теме, соответствующий запрос может не присутствовать в отчёте.
Поэтому данные Search Console необходимо дополнять внешним исследованием рынка.
Search Console и Wordstat решают разные задачи
Эти инструменты нельзя напрямую сравнивать.
Wordstat отвечает на вопрос:
что пользователи ищут в Яндексе.
Search Console отвечает:
по каким запросам конкретный сайт показывается в Google.
Яндекс Вебмастер в режиме статистики собственного сайта отвечает:
по каким запросам конкретный сайт показывается в Яндексе.
Инструмент подбора Вебмастера дополнительно позволяет исследовать внешний рынок.
Поэтому хороший сбор семантики использует источники по назначению, а не ищет один универсальный сервис.
Сбор семантики для нового сайта
У нового проекта ещё нет фактической поисковой статистики.
Поэтому работа начинается с бизнес структуры и внешнего спроса.
Сначала фиксируются:
товары
услуги
категории
проблемы аудитории
характеристики
варианты использования
география
После этого создаются seed запросы и маски.
Затем список расширяется через Wordstat, подбор запросов Вебмастера, подсказки, похожие формулировки и анализ рынка.
После первичной очистки начинается работа с интентами.
Так будущая структура появляется из реального спроса, а не только из внутреннего списка услуг компании.
Сбор семантики для существующего сайта
У работающего проекта схема отличается.
Перед созданием новых страниц нужно изучить уже накопленные данные.
Сначала полезно получить:
текущие URL
Search Console
Яндекс Вебмастер
существующие категории
taxonomy
контент план
страницы услуг
После этого становится понятно, какую часть спроса сайт уже закрывает.
Только затем внешний сбор показывает пробелы.
Так снижается риск создания второго URL под интент, который уже получает подходящая страница.
Семантика конкурентов
Конкуренты могут использоваться как дополнительный источник тем.
Это не означает копирование их ключевых слов или структуры.
Полезнее анализировать:
какие типы страниц присутствуют
какие товарные или сервисные направления выделены
какие пользовательские задачи закрыты
какие темы регулярно встречаются в SERP
Если у нескольких поисковых конкурентов существует самостоятельный раздел, которого нет на вашем сайте, это гипотеза для проверки.
Дальше нужно подтвердить реальный спрос и соответствие бизнесу.
Поисковый конкурент и бизнес конкурент могут различаться
Компания может конкурировать за клиентов с местными студиями.
Но по информационному запросу в Google рядом с её страницей могут находиться:
документация
крупное медиа
форум
справочник
маркетплейс
Поэтому собирать семантику только с сайтов прямых коммерческих конкурентов недостаточно.
Фактическая поисковая выдача показывает более широкий круг ресурсов, которые закрывают конкретный пользовательский интент.
Нужно ли собирать вопросы
Да, если они относятся к реальным задачам аудитории.
Например, для услуги SEO полезными могут быть запросы:
сколько времени занимает SEO
почему сайт не растёт
как выбрать SEO специалиста
Но такие вопросы не обязательно должны находиться на коммерческой странице услуги.
Сначала они добавляются в семантику.
Позже при анализе интента может выясниться, что часть запросов требует отдельных информационных материалов.
Сбор фиксирует спрос.
Распределение происходит позже.
Длинный хвост
При расширении семантики появляются более подробные запросы.
Например:
разработка сайта
разработка сайта для строительной компании
разработка сайта строительной компании цена
Чем длиннее формулировка, тем конкретнее может быть задача пользователя.
Но длина запроса сама по себе не определяет его ценность или тип.
Длинная фраза может быть:
коммерческой
информационной
навигационной
нерелевантной
нулевой по реальному спросу
Поэтому long tail является источником детализации, а не автоматическим основанием для создания страниц.
Не нужно стремиться собрать максимальное количество строк
Количество фраз легко превратить в красивую отчётную метрику.
Можно собрать:
10 000 запросов
100 000 запросов
миллион комбинаций
Но само число не показывает качество семантики.
В опубликованном материале Vagizov.com о сборе семантики основная мысль сформулирована практично: большая выгрузка не превращается в структуру сайта сама по себе.
Лучше получить 300 релевантных запросов по реальному сегменту, чем 30 000 строк, большая часть которых не относится к бизнесу.
Первичная очистка семантики
После сбора появляется сырой массив.
До кластеризации его необходимо очистить.
Первый уровень очистки касается очевидно нерелевантных формулировок.
Например, компания занимается ремонтом кофемашин.
В массиве могут встретиться:
купить кофемашину
аренда кофемашины
вакансии мастер кофемашин
кофемашина бесплатно
инструкция производителя
Если бизнес не предоставляет соответствующие услуги и не планирует информационные материалы по этим задачам, такие запросы исключаются.
Нерелевантность определяется бизнесом, а не только словами
Одна и та же фраза может быть полезной одному проекту и мусорной другому.
Запрос:
ремонт холодильника самостоятельно
не подходит как коммерческая семантика сервисной страницы.
Но для информационного раздела сервисного центра он может стать полезной статьёй, которая приводит аудиторию на раннем этапе принятия решения.
Поэтому очистка должна учитывать контентную стратегию проекта.
Не всё информационное является автоматически нерелевантным.
Минус слова
Минус слова помогают исключать очевидно ненужные уточнения ещё на этапе работы с Wordstat.
Например, для магазина новых товаров могут быть нерелевантны:
б у
бесплатно
ремонт
инструкция
вакансия
Однако нельзя создавать огромный список минус слов до просмотра фактической выдачи запросов.
Слово может иметь разное значение в разных сочетаниях.
На Vagizov.com минус словам в Wordstat уже посвящён отдельный материал текущей taxonomy. Страница подробно разбирает актуальный интерфейс и применение оператора исключения.
Поэтому здесь важен только принцип:
минус слова ускоряют очистку, но не заменяют содержательный анализ.
Дубли запросов
После объединения нескольких источников появляются одинаковые строки.
Например, один запрос может одновременно прийти из:
Wordstat
Вебмастера
Search Console
ручного списка
данных конкурентов
Перед дальнейшей обработкой точные дубли имеет смысл объединить.
Но похожие фразы не следует удалять только потому, что специалист считает их синонимами.
Например:
ремонт ноутбука
и
ремонт ноутбуков
могут оказаться одной группой.
Но решение принимается уже на этапе смыслового анализа и кластеризации.
Сырые данные лучше сохранять, чтобы не потерять реальную формулировку спроса.
Нормализация запросов
Для удобства обработки данные можно технически нормализовать.
Например:
убрать лишние пробелы
привести текст к единому регистру
отделить служебные символы
сохранить источник
зафиксировать регион
Но чрезмерная нормализация может уничтожить полезные различия.
Название бренда.
Модель.
Аббревиатура.
География.
Версия программы.
Год.
Все эти элементы способны менять пользовательскую задачу.
Поэтому исходная формулировка должна оставаться доступной.
Опечатки
Поисковая семантика может содержать опечатки.
Создавать отдельные тексты с намеренно неправильным написанием обычно не требуется.
Но опечатки могут быть полезны как данные о реальном спросе.
Особенно это касается:
брендов
иностранных названий
сложных терминов
транслитерации
При дальнейшей кластеризации такие варианты обычно объединяются с нормальной формой, если интент совпадает.
Проверка релевантности
Для каждой крупной группы полезно задать простой вопрос:
может ли сайт реально решить задачу человека, который ввёл этот запрос.
Если ответ отрицательный, формулировка не нужна только потому, что имеет высокую частотность.
Например, студия разработки сайтов не должна собирать запрос:
скачать шаблон сайта бесплатно
в коммерческое ядро только из за большого спроса.
Такой посетитель ищет другой продукт.
Релевантность бизнесу важнее размера цифры в инструменте.
После сбора начинается определение интента
Интент показывает, что пользователь хочет получить.
Например:
объяснение
товар
услугу
конкретный сайт
сравнение
действие
На Vagizov.com уже существуют самостоятельные taxonomy для информационных, коммерческих, транзакционных, брендовых и навигационных запросов. Родительский раздел также отдельно содержит кластеризацию, распределение запросов, поисковый спрос и семантическое ядро.
Поэтому «Сбор семантики» должен доходить до подготовки массива к определению интента, но не подменять все эти направления.
SERP помогает проверить спорный запрос
Две фразы могут казаться одинаковыми SEO специалисту, но поисковая выдача показывает разные типы страниц.
Например:
установка кондиционеров
и
как установить кондиционер
первая формулировка может вести к услугам.
Вторая к инструкциям.
В таком случае объединять запросы только из за общей лексики нельзя.
И обратная ситуация возможна.
монтаж кондиционера
и
установка кондиционера
могут показывать практически одинаковые коммерческие страницы.
Тогда они, вероятно, относятся к одному кластеру.
В опубликованном материале Vagizov.com о сборе семантики используется именно такая логика проверки выдачи перед созданием отдельных URL.
Сбор и кластеризация являются разными этапами
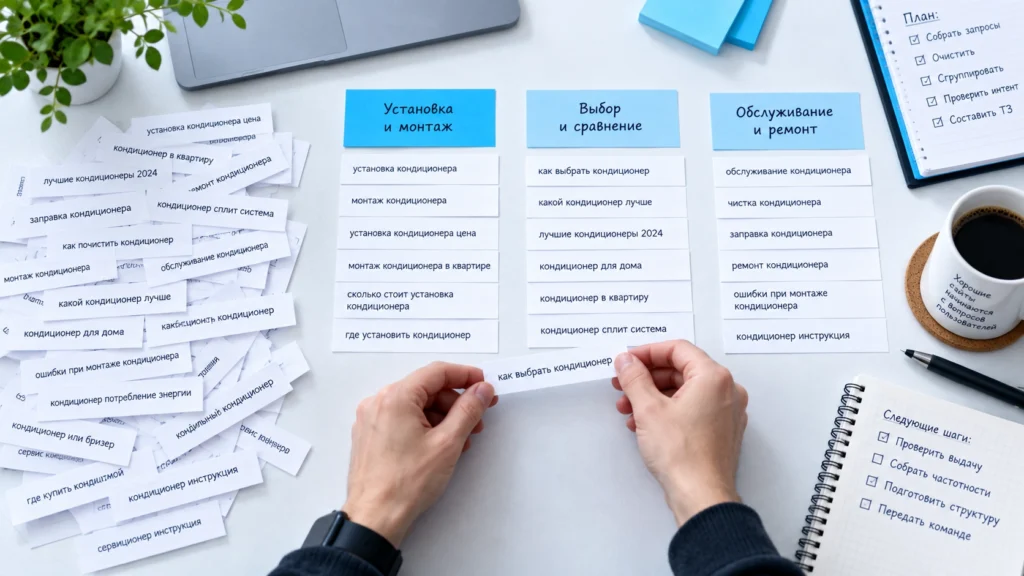
После получения и очистки массива начинается кластеризация.
Её задача состоит в объединении запросов, которые может полноценно закрывать одна страница.
На Vagizov.com это уже отдельная taxonomy. В существующем материале кластеризация определяется как группировка близких поисковых формулировок по смыслу и намерению пользователя с дополнительной проверкой спорных случаев по SERP.
Поэтому текущая страница не должна подробно описывать hard, soft или другие способы автоматической SERP кластеризации.
Граница простая:
сбор отвечает на вопрос:
какие запросы существуют.
Кластеризация отвечает:
какие из них должны работать вместе.
Сбор и распределение по URL тоже разные процессы
Даже после кластеризации ещё необходимо определить целевую страницу.
Группа может относиться к:
существующему URL
новой странице услуги
категории
товарной карточке
статье
taxonomy
главной странице
На Vagizov.com распределение запросов вынесено в самостоятельную тему. Родительская taxonomy прямо показывает отдельный раздел «Распределение запросов».
Следовательно, сбор семантики заканчивается не публикацией новых страниц, а подготовкой качественных данных для следующего этапа.
Один запрос не равен одному URL
Это принципиально важно уже во время сбора.
Если специалист воспринимает каждую строку как будущую страницу, большой список становится опасным.
Например:
ремонт холодильников
ремонт холодильника
мастер по ремонту холодильников
починить холодильник
могут выражать одну пользовательскую задачу.
Сбор должен сохранить все реальные формулировки.
Но количество будущих URL определяется только после кластеризации.
Сбор семантики для коммерческого сайта
Для сайта услуг полезно начинать с реального каталога услуг.
Например:
SEO продвижение
аудит
разработка
поддержка
Каждое направление расширяется через:
объект услуги
проблему
характеристику
отрасль
географию
стоимость
результат
Затем информационные и коммерческие группы разделяются.
Так структура сайта опирается на фактическое предложение бизнеса.
Сбор семантики для интернет магазина
В ecommerce основой становятся:
категории
подкатегории
товары
бренды
характеристики
назначение
совместимость
пользовательские задачи
Особенно опасно автоматически создавать SEO страницу для каждой комбинации характеристик.
На этапе сбора все такие формулировки могут оставаться в массиве.
Но решение о самостоятельной индексируемой категории принимается только после проверки спроса, ассортимента и интента.
Семантика помогает проектировать каталог.
Она не должна механически размножать фильтры.
Сбор семантики для информационного проекта
Здесь исходными сущностями становятся не услуги, а темы и вопросы аудитории.
Полезно собирать:
основные понятия
проблемы
инструкции
сравнения
ошибки
варианты использования
связанные технологии
вопросительные формулировки
Далее запросы группируются в тематические кластеры.
Один большой хаб может содержать десятки статей.
Но статья создаётся под самостоятельную задачу, а не под каждый вариант заголовка.
Брендовые запросы лучше маркировать отдельно
Брендовый спрос полезно сохранять в семантике отдельным признаком.
Например:
vagizov seo
vagizov отзывы
vagizov разработка сайтов
Такие формулировки показывают уже существующую известность бренда и могут иметь иной пользовательский путь, чем общие запросы:
SEO продвижение сайта
разработка сайта
При анализе роста видимости это разделение помогает отличать брендовый спрос от небрендового.
Подробная работа с такими формулировками уже относится к taxonomy «Брендовые запросы».
Геозапросы
Если бизнес работает локально, географические модификаторы нужно учитывать в исходной модели.
Например:
ремонт ноутбуков Пермь
ремонт ноутбуков в Перми
сервис ноутбуков Пермь
Но наличие города в запросе не означает необходимость отдельного URL под каждую формулировку.
Если бизнес работает сразу в нескольких регионах, сначала нужно определить реальную географию обслуживания.
Только после этого семантика расширяется по городам.
Так не появляются посадочные страницы для регионов, где компания фактически не работает.
Сезонные запросы нужно маркировать
Некоторые группы стоит помечать как сезонные ещё при сборе.
Это помогает не принимать временный всплеск за постоянный спрос.
Например:
подготовка дачи к зиме
подарки на Новый год
кондиционер летом
рассада весной
В дальнейшем такой признак полезен для:
контент плана
сроков публикации
аналитики
сравнения результатов
Но детальный анализ сезонности уже относится к отдельной taxonomy.
Что хранить в рабочей таблице
Минимальная таблица может содержать:
запрос
источник
регион
спрос
статус релевантности
комментарий
После дальнейшего анализа добавляются:
интент
кластер
тип страницы
целевой URL
приоритет
Не обязательно заполнять все поля сразу.
Лучше постепенно обогащать данные по мере прохождения этапов.
Главное, чтобы всегда можно было понять происхождение запроса.
Источник запроса полезно сохранять
Если запрос получен из Search Console, это означает, что Google уже показывал по нему сайт.
Если строка пришла из Wordstat, это внешний спрос Яндекса.
Если запрос обнаружен в подсказках, это пока только гипотеза для дополнительной проверки.
Если фраза взята из Яндекс Вебмастера конкретной страницы, она уже связана с фактической видимостью URL.
Поэтому поле «Источник» помогает правильно интерпретировать данные.
Без него все строки выглядят одинаково, хотя их доказательная ценность различается.
Автоматизация сбора
Для небольшого сайта запросы можно собирать вручную.
Для крупной тематики количество масок быстро становится слишком большим.
Тогда используются:
API
собственные scripts
парсеры
специализированные сервисы
табличная автоматизация
Яндекс предоставляет Wordstat API через Search API. В актуальной документации доступны методы для получения популярных запросов, динамики и распределения по регионам.
Автоматизация полезна для получения данных.
Но она не должна автоматически превращать каждую найденную строку в страницу.
Массовый сбор требует лимитов
Если программа автоматически перебирает тысячи масок, можно получить огромный массив, большая часть которого не понадобится.
Поэтому перед массовым сбором полезно определить:
тематику
географию
типы запросов
минимальные требования к релевантности
источники
правила удаления дублей
формат хранения
Так automation экономит время, а не просто быстрее производит мусор.
Search Console можно использовать для расширения существующей семантики
Для опубликованной страницы полезно периодически смотреть новые запросы.
Google прямо рекомендует использовать Performance report, чтобы видеть, какие запросы показывают сайт и какие из них приводят трафик.
Можно обнаружить запрос с большим количеством показов, которого нет в рабочей семантике.
После этого задаётся вопрос:
это дополнительная формулировка существующей темы или новый самостоятельный интент.
В первом случае расширяется текущая страница.
Во втором появляется кандидат на отдельный кластер.
Так семантика развивается на основе реальных данных.
Новые запросы не нужно автоматически добавлять в текст
Если Search Console показал ещё двадцать формулировок, это не означает, что их необходимо дословно вставить в статью.
Сначала нужно понять общую задачу.
Часто несколько десятков строк являются разными способами спросить одно и то же.
SEO текст должен полно отвечать пользователю, а не имитировать выгрузку из аналитики.
Собранные запросы являются данными для проектирования содержания.
Они не являются обязательным списком точных вхождений.
Семантика должна обновляться
Сбор не обязательно выполняется один раз при запуске сайта.
Со временем меняются:
продукты
терминология
конкуренты
поисковый спрос
технологии
вопросы пользователей
состав SERP
На работающем сайте дополнительно накапливаются новые данные Search Console и Яндекс Вебмастера.
Поэтому семантика становится живой системой.
Периодически можно повторно проверять:
новые запросы
страницы с растущими показами
новые направления спроса
изменение терминологии
пробелы существующей структуры
На Vagizov.com «Расширение семантики» уже опубликовано как отдельный материал текущей taxonomy и посвящено именно дополнению существующей модели новыми запросами.
Сбор семантики перед созданием статьи
Для одной статьи не всегда требуется собирать огромное ядро всего сайта.
Достаточно исследовать конкретный кластер.
Например, тема:
301 редирект
может расширяться запросами о:
назначении
настройке
Nginx
Apache
WordPress
проверке
SEO последствиях
ошибках
После анализа становится понятно, что относится к одной статье, а какие темы заслуживают отдельных материалов.
Так локальный сбор семантики используется даже внутри уже существующей структуры сайта.
Сбор перед созданием новой услуги
Для страницы услуги важно проверить не только главный коммерческий запрос.
Полезно собрать:
основное название услуги
синонимы
варианты объекта
ценовые формулировки
результат
проблемы клиента
отраслевые уточнения
географию
После этого SERP показывает, какие запросы действительно относятся к одному коммерческому интенту.
Информационные вопросы можно оставить для статей.
Так одна страница не пытается закрыть весь тематический спрос сразу.
Сбор перед проектированием нового сайта
На новом коммерческом сайте семантика должна появляться до окончательного меню и дизайна.
Она помогает понять:
какие услуги имеют самостоятельный спрос
какие категории нужны
какие направления стоит объединить
какие информационные разделы могут привлекать аудиторию
какие страницы вообще не нужны
Если структуру сначала утвердить без исследования спроса, после SEO анализа часто приходится переделывать меню, URL и шаблоны.
Поэтому сбор семантики является частью проектирования.
Сбор после запуска сайта
После запуска начинается второй тип работы.
Теперь есть фактические поисковые данные.
Можно сравнить первоначальную модель с тем, как Google и Яндекс реально воспринимают страницы.
Например:
планировалось продвижение по одному кластеру
но поисковая система показывает URL по дополнительной теме
или:
страница вообще не получает показов по ожидаемой группе
Это повод пересмотреть семантику и интент.
Сбор после запуска превращается из проектного этапа в постоянное исследование спроса.
Как оценить качество сбора
Хорошая семантика не определяется количеством строк.
Полезнее проверить другие признаки.
Основные товарные или сервисные направления присутствуют.
Синонимы и реальные пользовательские формулировки не пропущены.
Учтён целевой регион.
Есть данные о фактических запросах существующего сайта.
Нерелевантные темы удалены.
Источники запросов сохранены.
Спорные группы можно проверить по SERP.
Массив готов к кластеризации.
Если эти условия выполнены, сбор решает свою задачу.
Что не является качественным результатом
Файл с тысячами строк без источника.
Выгрузка Wordstat без очистки.
Список запросов одного конкурента.
Семантика только из Search Console.
Набор ключей, полученный исключительно через генеративную модель без проверки спроса.
Список всех возможных комбинаций слов.
Таблица, где каждому запросу заранее назначена отдельная страница.
Все эти варианты могут быть промежуточным сырьём.
Но не завершённой работой.
AI при сборе семантики
Нейросеть может помогать формировать:
seed запросы
синонимы
варианты масок
список объектов
характеристики
возможные пользовательские вопросы
категории для очистки
Но модель не является поисковой статистикой.
Сгенерированная фраза может:
не иметь спроса
использоваться пользователями иначе
относиться к другому интенту
вообще не встречаться в реальном поиске
Поэтому AI удобно использовать как генератор гипотез.
Подтверждение выполняется по реальным данным.
AI особенно полезен для тематического словаря
Перед обращением к Wordstat модель может помочь быстро разложить предметную область.
Например, для котельного оборудования:
типы котлов
топливо
мощность
ошибки
обслуживание
монтаж
комплектующие
бренды
проблемы
Такой словарь затем превращается в маски.
После этого уже реальные поисковые сервисы показывают, какие комбинации действительно используют люди.
Это значительно надёжнее, чем публиковать структуру только по генерации модели.
Частые ошибки при сборе семантики
Первая ошибка состоит в начале сбора с одной слишком широкой фразы.
Вторая в использовании только одного источника данных.
Третья в принятии Wordstat за прогноз фактического трафика.
Четвёртая в использовании Search Console как полного списка спроса рынка.
Пятая в игнорировании региона.
Шестая в смешивании всех интентов в одном массиве без последующей классификации.
Седьмая в удалении похожих запросов до анализа.
Восьмая в стремлении получить максимальное количество строк.
Девятая в создании отдельного URL под каждый запрос.
Десятая в копировании семантики конкурента без проверки релевантности бизнесу.
Одиннадцатая в генерации запросов через AI без проверки реального спроса.
Двенадцатая в отсутствии повторного анализа после запуска сайта.
Все эти ошибки превращают исследование спроса в механическую работу с таблицами.
Практический порядок сбора семантики
Сначала определяется отдельный тематический сегмент.
После этого выписываются реальные товары, услуги, проблемы и другие сущности бизнеса.
Из них формируются seed запросы и маски.
Затем исходные формулировки расширяются через Wordstat.
Добавляются похожие запросы и подсказки.
Для работающего сайта подключаются Search Console и Яндекс Вебмастер.
Проверяются дополнительные запросы через инструмент подбора Вебмастера.
После объединения источников удаляются точные дубли.
Массив очищается от явно нерелевантных тем.
Фиксируются регион, источник и данные спроса.
После этого запросы передаются на этап анализа интента и кластеризации.
И только затем группы распределяются по существующим и будущим URL.
Так сбор остаётся отдельным понятным этапом, а не смешивается сразу со всей SEO стратегией.
Какой результат должен остаться после сбора
Результатом является не готовый сайт и даже не обязательно готовое семантическое ядро.
На выходе нужен качественный массив запросов, который можно анализировать дальше.
Для каждой строки желательно понимать:
что искал пользователь
откуда получена формулировка
относится ли она к проекту
какой регион исследуется
есть ли подтверждённый спрос
какие уточнения требуют дополнительной проверки
После этого начинается смысловая работа.
Что находится в разделе «Сбор семантики»
На момент актуальной проверки taxonomy «Сбор семантики» на Vagizov.com содержит шесть материалов.
«Сбор семантики: как собирать, анализировать и применять в SEO» описывает общий процесс от определения сегмента спроса и исходных формулировок до очистки и подготовки запросов к группировке.
«Маски ключевых слов: как анализировать запросы и использовать в семантике» раскрывает построение исходных моделей запросов.
«Похожие запросы: как находить дополнительные темы и семантику» посвящён поиску формулировок, которые могут использовать другую лексику, но относиться к близкой пользовательской задаче.
«Подсказки Яндекса: как использовать для расширения семантики» рассматривает поисковые саджесты как источник новых гипотез.
«Расширение семантики: как собирать, анализировать и применять в SEO» посвящено развитию уже существующей семантической модели.
«Минус слова в Wordstat: как исключать мусор при сборе семантики» раскрывает очистку исходных выгрузок непосредственно в Wordstat.
Поэтому новые публикации этой taxonomy логично посвящать именно способам получения и первичной обработки запросов: источникам семантики, автоматизации сбора, API, работе с большими массивами, комбинированию данных разных систем, новым возможностям Wordstat и Вебмастера и другим задачам до полноценной кластеризации.