Робот Яндекса — это не один универсальный бот, который «индексирует весь сайт за один заход». У Яндекса работает несколько роботов для разных задач, а основной индексирующий робот использует User-Agent с YandexBot. Именно его обращения обычно интересуют SEO-специалиста при диагностике обхода сайта. Официальная документация отдельно перечисляет основной YandexBot, робот определения зеркал и специализированные агенты.
При этом посещение страницы роботом нельзя приравнивать к попаданию в поиск. Яндекс Вебмастер прямо отмечает, что URL может быть обойдён, но отсутствовать в поисковой базе. Поэтому при проблеме с индексированием нужно разделять три вопроса: знает ли Яндекс об URL, смог ли робот его загрузить и участвует ли страница в поиске.
Как робот Яндекса находит страницы сайта
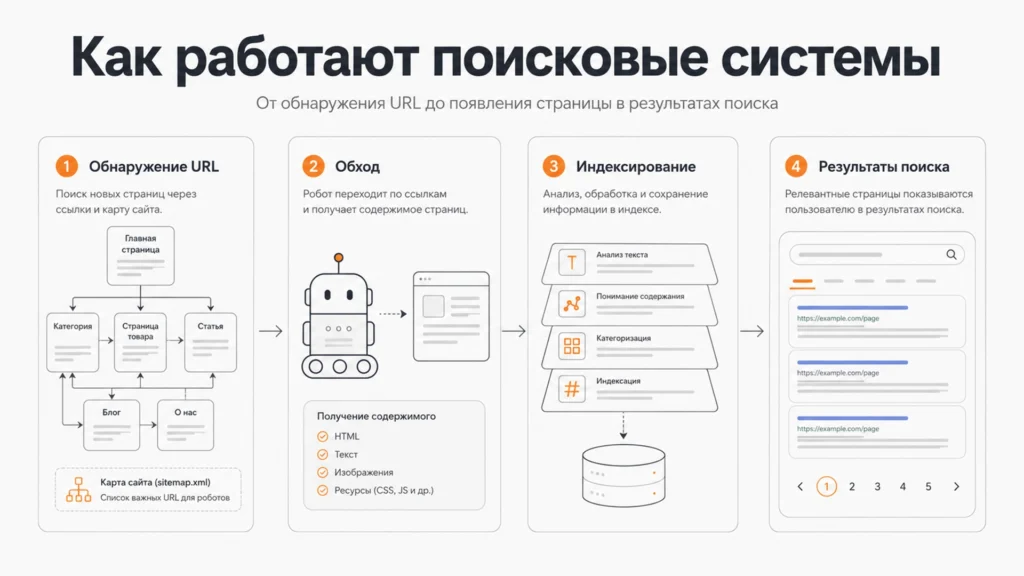
Основной поисковый робот получает адреса не только из Sitemap. Яндекс указывает, что сайты и страницы обнаруживаются в том числе через внутренние и внешние ссылки. Sitemap дополняет этот механизм и особенно полезен для больших сайтов, глубоко вложенных URL и страниц, на которые мало навигационных ссылок. Само присутствие URL в Sitemap не гарантирует его появления в поиске.
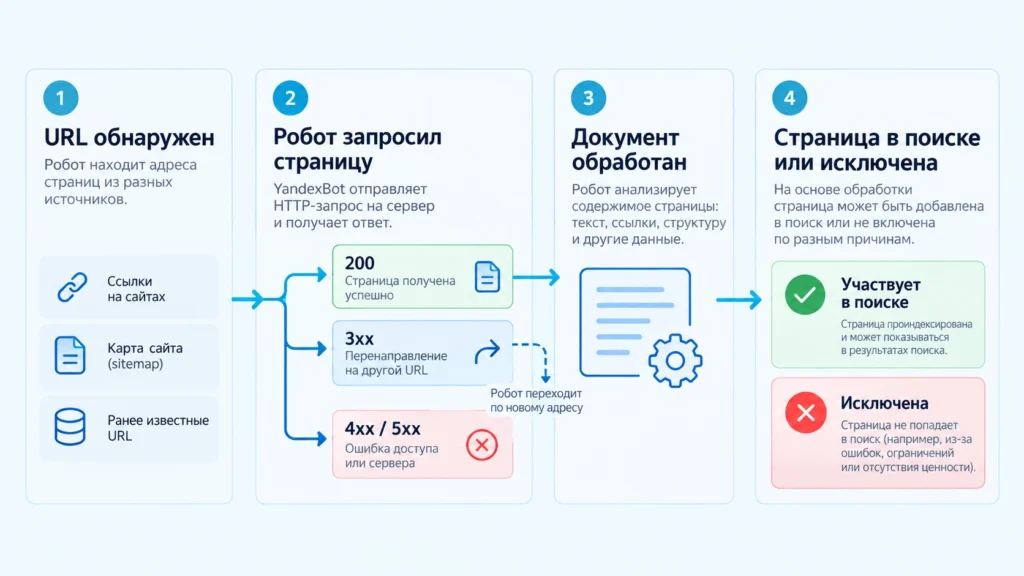
Упрощённо процесс выглядит так:
- Яндекс узнаёт об URL.
- Робот проверяет возможность его обхода.
- Сервер получает HTTP-запрос и возвращает страницу или другой ответ.
- Полученный документ обрабатывается поисковой системой.
- После обработки страница может быть включена в поиск, исключена либо признана дублем.
На практике краулинг становится неэффективным, когда значительная часть запросов уходит на технические фильтры, бесконечные GET-параметры, удалённые URL, дубли или страницы, которые не должны участвовать в поиске.
Что определяет доступ YandexBot к URL
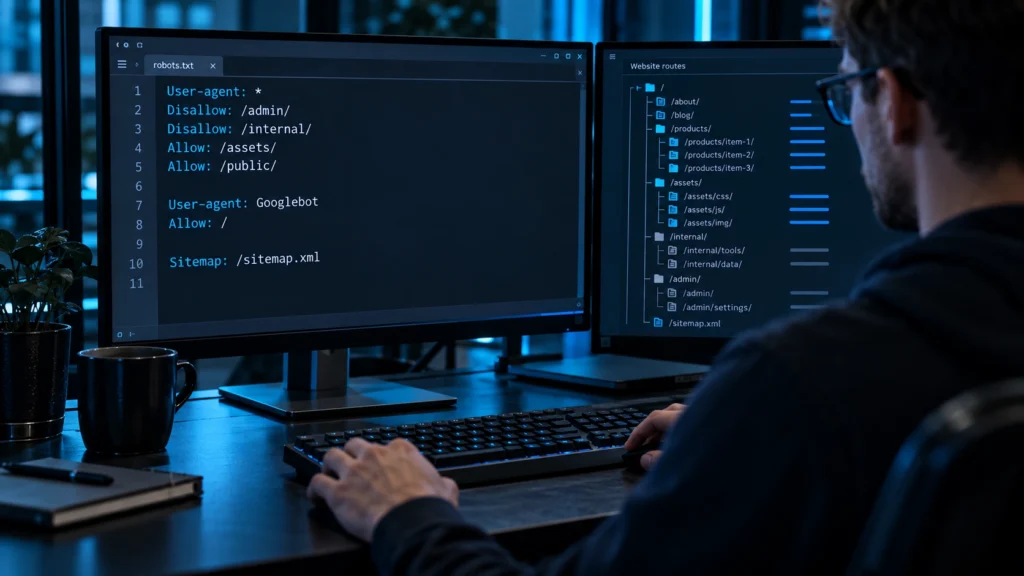
Первое место проверки — robots.txt. Для основного индексирующего робота можно использовать секцию:
User-agent: YandexBotДля правил, рассчитанных шире на роботов Яндекса:
User-agent: YandexЯндекс указывает, что при наличии отдельной секции для конкретного робота применяются её правила, а более общие секции для него уже не используются.
Пример простой конфигурации:
User-agent: Yandex
Disallow: /cart/
Disallow: /search/
Sitemap: https://example.com/sitemap.xml
Важно понимать назначение Disallow: это ограничение обхода, а не гарантированный способ удалить уже известный URL из поиска. Яндекс предупреждает, что закрытый через robots.txt адрес при определённых условиях всё равно может участвовать в поиске. Если поисковику нужно прочитать noindex, запрещать ему загрузку этой же страницы через robots.txt не следует.
Ещё одна устаревшая практика — Crawl-delay. Яндекс не учитывает эту директиву с 22 февраля 2018 года. Скорость обращений индексирующего робота регулируется через Яндекс Вебмастер.
Как проверить реальный обход сайта
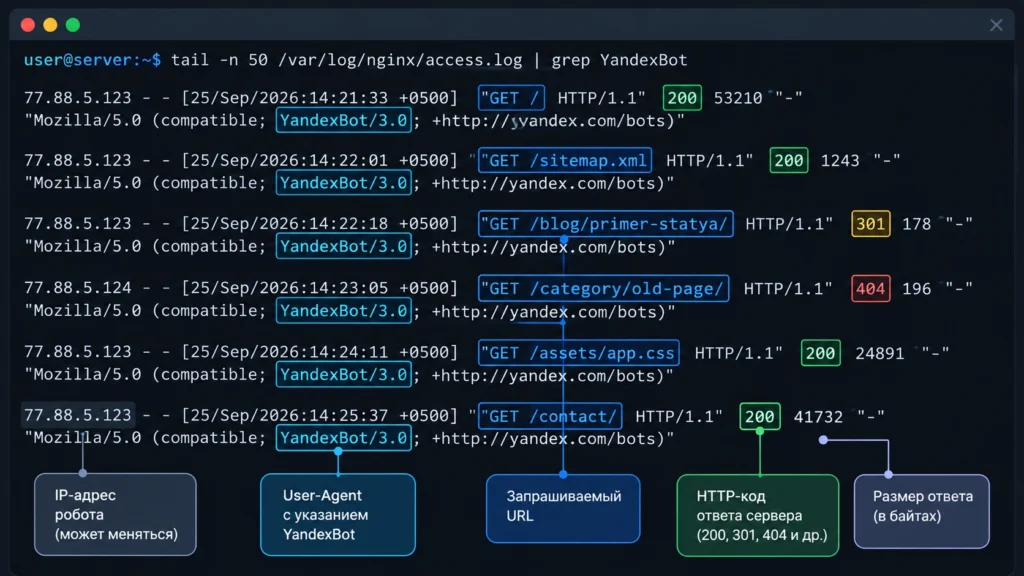
Самый прямой источник — серверные access-логи. Именно они показывают, какой URL запрашивался, когда это произошло, какой HTTP-код был возвращён и какой User-Agent пришёл на сервер.
Запись может содержать строку с YandexBot/3.0, но одного User-Agent недостаточно для подтверждения, что запрос действительно принадлежит Яндексу: сторонний бот может его подделать. Официальный способ проверки — reverse DNS либо инструмент проверки IP в Яндекс Вебмастере. Яндекс также указывает, что адреса роботов меняются и фиксированный список IP не публикуется.
Поэтому yandexbot в access-логе следует анализировать вместе с IP, кодом ответа и запрошенным URL.
Например:
GET /catalog/item/ HTTP/1.1" 200
GET /catalog/?sort=price HTTP/1.1" 200
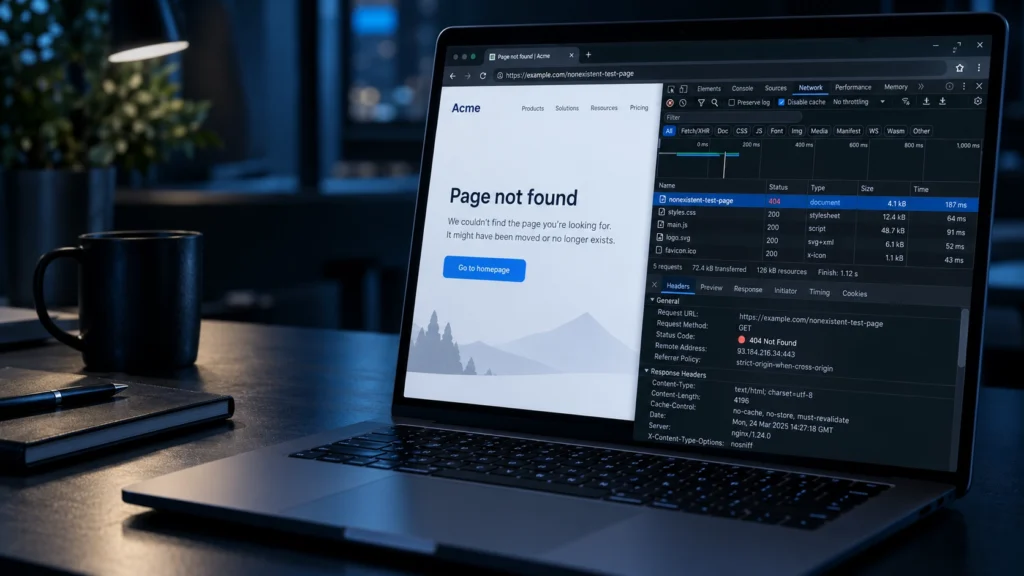
GET /old-page/ HTTP/1.1" 404
Такой фрагмент уже показывает три разных задачи: нормальный обход полезной страницы, потенциальный обход параметрического дубля и повторные обращения к отсутствующему URL.
Что смотреть в Яндекс Вебмастере
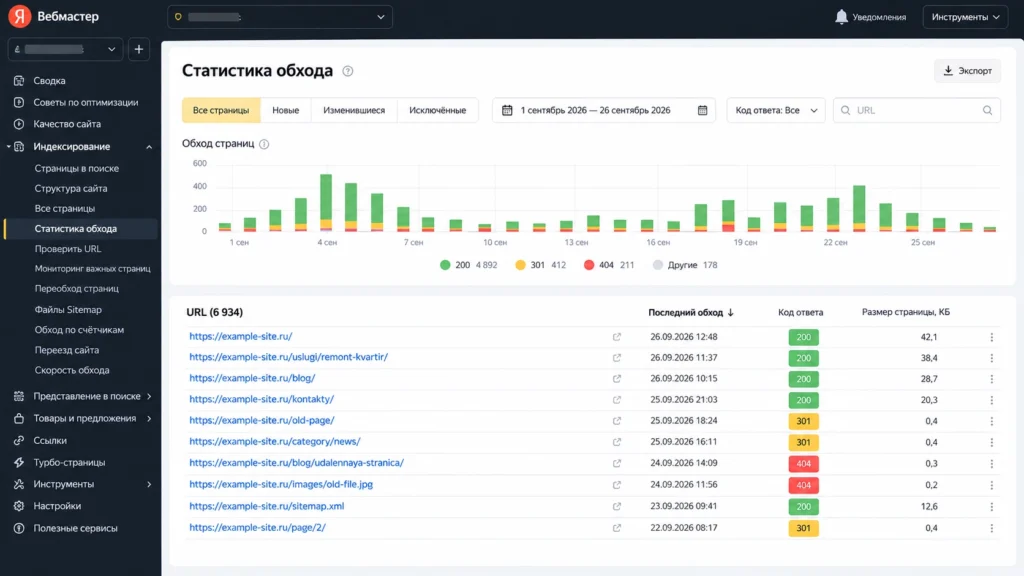
Для диагностики не обязательно начинать с сырых логов. В разделе «Индексирование → Статистика обхода» Яндекс показывает адреса, которые посещал робот, даты обхода и полученные HTTP-коды. Данные можно фильтровать по разделам и ошибкам.
Если проблема относится к одному URL, полезнее «Проверка страницы» и «Проверка ответа сервера». Для критичных страниц есть «Мониторинг важных страниц», где отображаются дата последнего обхода, ответ сервера и состояние страницы в поиске.
Такое сканирование сайта со стороны Яндекса нужно оценивать не по одному общему числу посещений, а по распределению запросов: получает ли робот полезные страницы или значительная часть обхода расходуется на технический мусор.
Когда робот тратит обход не на те страницы
Для крупного сайта один из самых заметных симптомов — количество загруженных роботом страниц значительно превышает объём действительно полезных URL. Сам Яндекс рекомендует в такой ситуации проверить статистику обхода и обратить внимание на адреса с GET-параметрами и однотипный контент.
Типичные причины:
- фильтры создают множество комбинаций URL;
- служебные параметры меняют адрес, но не содержимое;
- внутренние ссылки продолжают вести на удалённые страницы;
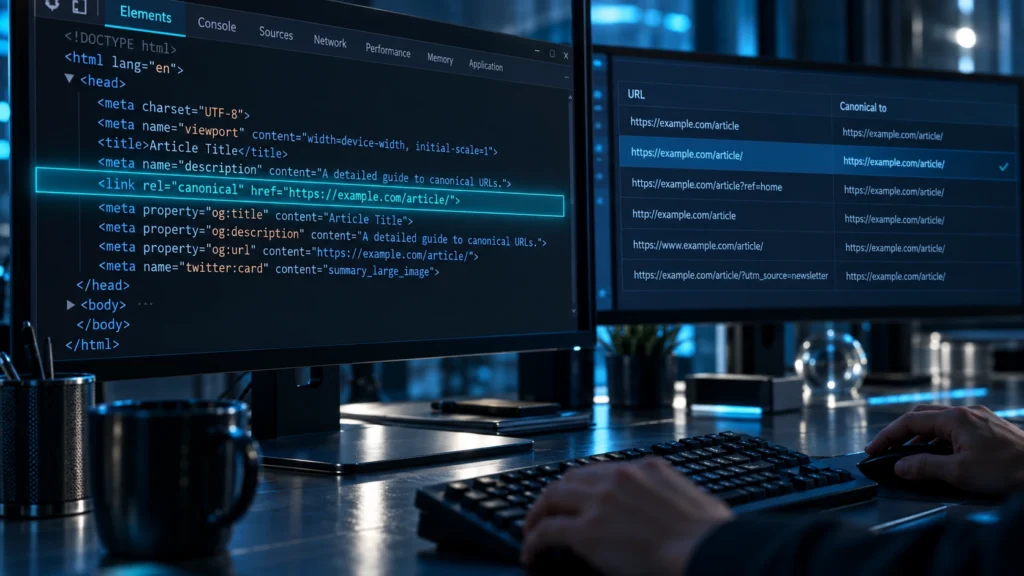
- Sitemap содержит ненужные или неканонические URL;
- сервер нестабилен и периодически возвращает
5xx; - полезные страницы находятся слишком глубоко или почти не связаны внутренними ссылками.
Для параметров, которые не меняют содержимое страницы, Яндекс поддерживает Clean-param. Документация отдельно отмечает, что большое количество таких дублей способно замедлять обход полезных страниц.
Практический пример: робот активно ходит по фильтрам, а новые товары обходит редко
Допустим, интернет-магазин имеет 20 000 полезных карточек, но серверные логи и «Статистика обхода» показывают многочисленные адреса вида:
/catalog/?sort=price
/catalog/?sort=name
/catalog/?utm_source=partner
/catalog/?utm_source=email
Первое действие — определить, какие параметры действительно меняют содержимое, а какие создают технические варианты одного документа. Механически запрещать все URL с ? нельзя: среди них могут быть функционально разные страницы.
Дальше проверяются внутренние ссылки, Sitemap и правила robots.txt. Для незначимых параметров при необходимости применяется Clean-param, а из Sitemap удаляются URL, которые не должны рассматриваться как самостоятельные страницы.
После изменения конфигурации нужно снова проверить логи и статистику обхода. Полезный результат здесь — не «рост позиций после настройки», а уменьшение ненужных маршрутов обхода и более чистая структура известных роботу адресов. Из этого уже может следовать более рациональное использование ресурсов обхода, но автоматический рост поисковой видимости такой настройкой не гарантируется.
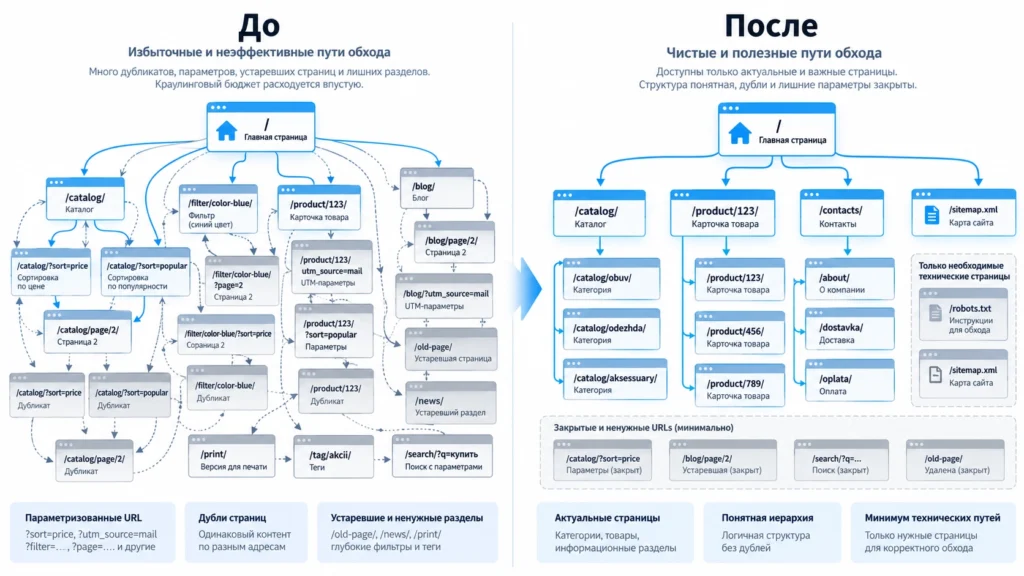
Если YandexBot системно тратит обход на параметры, дубли, ошибочные URL и устаревшие маршруты, проблема обычно выходит за рамки одной настройки robots.txt. При комплексном продвижении сайта такие группы URL стоит разбирать вместе с внутренними ссылками, Sitemap, HTTP-ответами и фактической статистикой обхода, а после исправлений повторно проверять логи, чтобы подтвердить изменение поведения робота.
FAQ
Что проверять, если YandexBot приходит редко или обходит не те URL
Да. Яндекс прямо разделяет факт обхода URL и его участие в поиске. Если робот уже получил страницу, но она отсутствует в выдаче, нужно дополнительно смотреть её статус в «Проверке страницы» и «Страницах в поиске», а не пытаться только увеличивать частоту обхода.
Не доверять только строке User-Agent. Возьмите IP из access-лога и проверьте его через официальный инструмент Яндекса либо выполните рекомендованную проверку reverse DNS.
Нет. Яндекс перестал учитывать Crawl-delay в 2018 году. Для индексирующих роботов скорость обхода настраивается через Яндекс Вебмастер; при реальной перегрузке сервера документация также описывает HTTP 429 как сигнал о необходимости снизить число обращений.
Он может по-прежнему находить этот адрес во внутренних или внешних ссылках. В статистике обхода Яндекс отдельно предупреждает, что обращения к удалённой странице могут продолжаться, пока на неё существуют ссылки или доступ не ограничен. Сначала стоит найти источник URL и проверить корректность серверного ответа.
Смотрите на проверяемые признаки: важные URL отдают корректные HTTP-коды, доступны роботу, появляются в статистике обхода, а поток запросов к бесполезным дублям сокращается. Для критичных страниц удобно дополнительно использовать мониторинг важных URL. Сам по себе такой результат не является обещанием улучшения позиций.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.