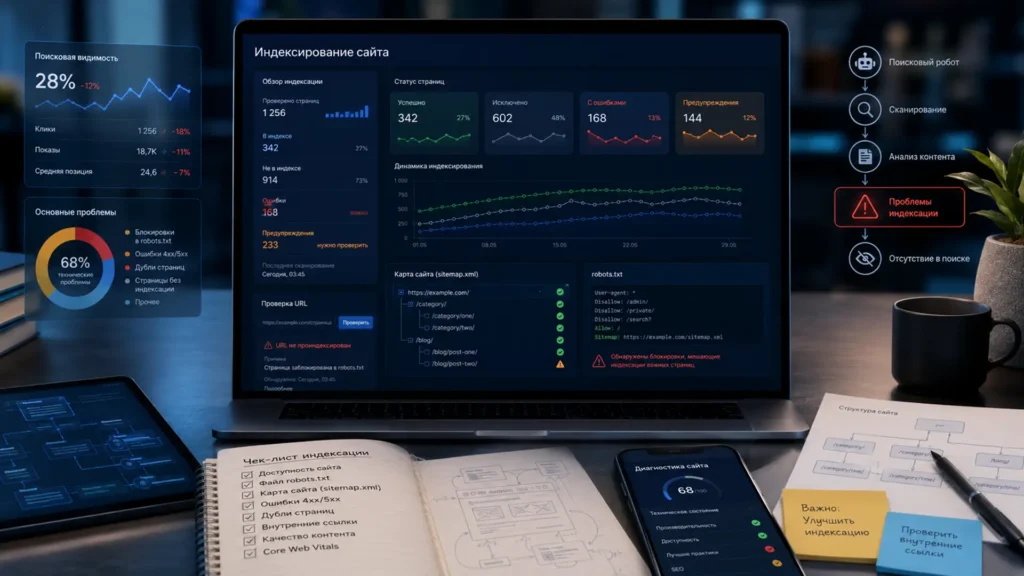
robots.txt решает довольно узкую задачу: управляет тем, какие адреса сайта поисковому роботу разрешено запрашивать. Google прямо определяет его как средство управления доступом crawler к URL и отдельно предупреждает, что файл не предназначен для исключения обычной веб-страницы из результатов поиска. Яндекс также указывает, что запрещённый через robots.txt адрес при определённых условиях всё равно может участвовать в поиске.
Отсюда главное правило настройки: сначала определить, что именно требуется — прекратить лишний обход, исключить страницу из индекса, удалить несуществующий URL или сообщить поисковику об актуальных страницах. Только после этого выбирать директиву.
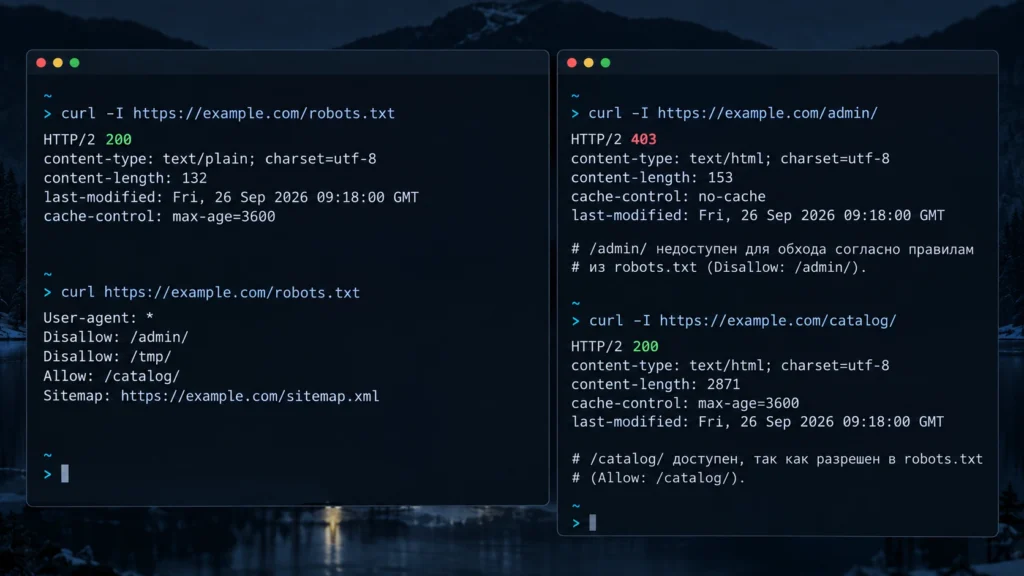
Сначала определите задачу: обход и индексирование — не одно и то же
Одна из самых частых SEO-ошибок выглядит так:
User-agent: *
Disallow: /private-page/
Владелец ожидает, что /private-page/ исчезнет из поиска. Но Disallow говорит роботу не загружать адрес. Если поисковая система уже знает URL из ссылок, сам адрес потенциально может оставаться в индексе без содержимого страницы.
Google рекомендует для исключения доступной страницы из результатов использовать noindex через HTML или HTTP-заголовок. При этом робот должен иметь возможность загрузить страницу и увидеть это указание: если одновременно закрыть URL в robots.txt, Googlebot не сможет прочитать noindex.
У Яндекса логика аналогична: официальная справка прямо предупреждает, что ограниченные в robots.txt страницы могут участвовать в поиске, а для удаления страницы следует использовать noindex в HTML или HTTP-заголовке, не блокируя при этом её обход.
Поэтому полезно разделять инструменты:
| Задача | Основной механизм |
|---|---|
| Не тратить обход на служебный раздел | Disallow |
| Разрешить исключение внутри закрытого раздела | Allow |
| Исключить доступную HTML-страницу из поиска | noindex |
| Исключить PDF или другой не-HTML ресурс | X-Robots-Tag: noindex |
| Сообщить о полезных индексируемых URL | sitemap xml |
| Удалённая страница больше не существует | корректный 404 или 410 |
| У Яндекса есть дубли из незначимых GET-параметров | Clean-param |
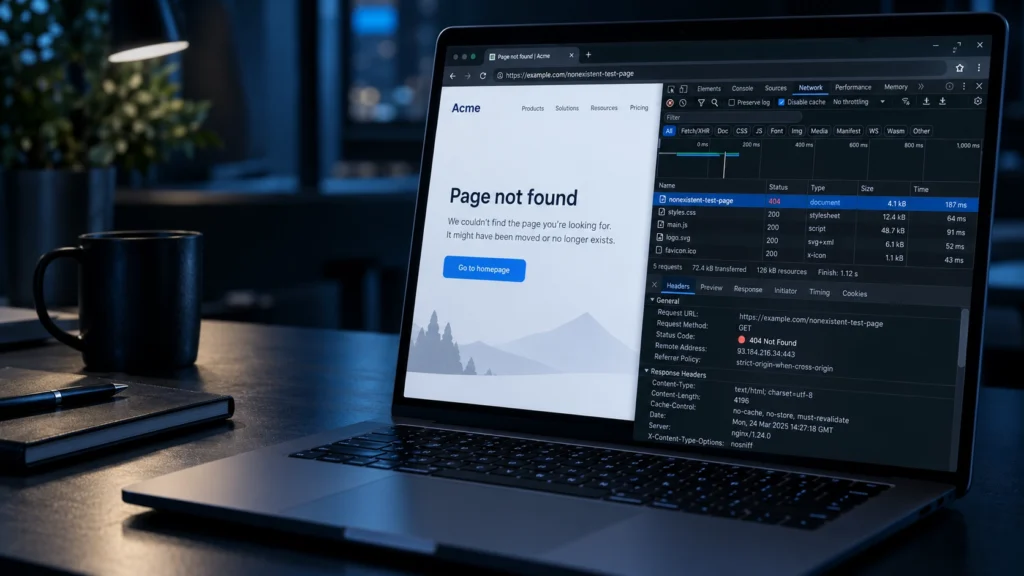
Отдельно стоит проверять страницы 404: закрывать исчезнувшие URL через Disallow обычно бессмысленно, потому что поисковику полезнее получить настоящий HTTP-ответ об отсутствии документа.
Как устроен robots.txt и какие директивы реально нужны
Файл размещается в корне конкретного хоста:
https://example.com/robots.txtДля Google область действия robots.txt привязана к протоколу, хосту и порту. Например, файл https://example.com/robots.txt не управляет https://shop.example.com/ и не распространяется на HTTP-версию этого же домена. Google также указывает, что файл должен быть обычным UTF-8 текстом.
Минимальная открытая конфигурация может выглядеть так:
User-agent: *
Allow: /

Sitemap: https://example.com/sitemap.xml
User-agent
Определяет, для какого робота действует группа правил:
User-agent: *означает общую группу.
Можно создавать отдельные группы:
User-agent: Googlebot
Disallow: /example/

User-agent: Yandex
Disallow: /example/
Но без реальной необходимости усложнять файл отдельными наборами правил не стоит: чем больше пересекающихся секций, тем выше вероятность ошибки.
Disallow
Запрещает обход соответствующего пути:
User-agent: *
Disallow: /search/
Disallow: /cart/
Важно учитывать префиксы. Правило для /search/ распространяется не только на один адрес, а на URL, начинающиеся с этого пути.
Allow
Используется для разрешения более узкого URL внутри запрещённой области:
User-agent: *
Disallow: /files/
Allow: /files/public/
Google поддерживает Allow и Disallow; Яндекс также включает Allow в поддерживаемые директивы.
Sitemap
Путь к Sitemap можно указывать непосредственно в robots.txt:
Sitemap: https://example.com/sitemap_index.xmlGoogle требует полный абсолютный URL. Яндекс рассматривает Sitemap как межсекционную директиву и использует переданный путь при последующих сессиях загрузки.
Robots txt SEO: что файл реально решает
Связка robots txt seo полезна прежде всего в техническом SEO: файл помогает ограничивать обход бесполезных маршрутов и не расходовать ресурсы сервера на некоторые служебные URL.
Но robots.txt не является самостоятельным фактором повышения позиций. Его корректная настройка устраняет технические препятствия и может улучшить структуру обхода, а результат для поисковой видимости зависит уже от доступности, индексируемости, качества страниц, внутренней архитектуры и других сигналов.
Как проверить robots.txt до изменения
Начать стоит с самого файла:
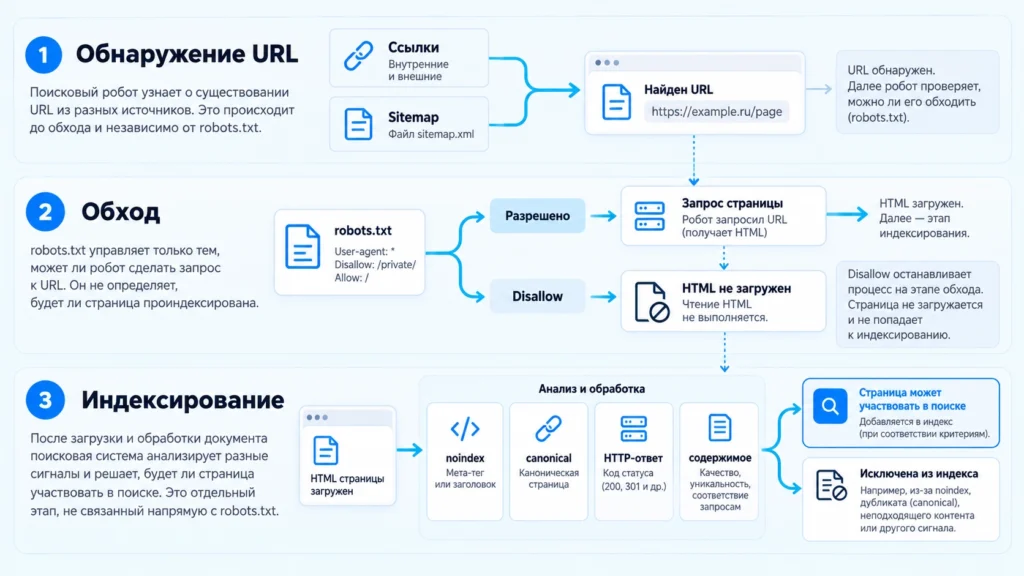
curl -I https://example.com/robots.txt
curl https://example.com/robots.txt
Нужно убедиться, что используется правильный хост, возвращается ожидаемый файл и сервер не подменяет его страницей ошибки, защитой CDN или другим HTML.
У Яндекса файл должен находиться в корне сайта и быть доступным роботу. В официальной документации указан лимит 500 КБ. У Google действует лимит 500 KiB: содержимое сверх него игнорируется.
После этого проверяются конкретные URL, а не только синтаксис файла.
Например, если есть:
User-agent: *
Disallow: /catalog/filter/
нужно взять реальные адреса:
/catalog/
/catalog/product-1/
/catalog/filter/color-blue/
/catalog/filter/brand-example/
и убедиться, что правило затрагивает именно нужные страницы.
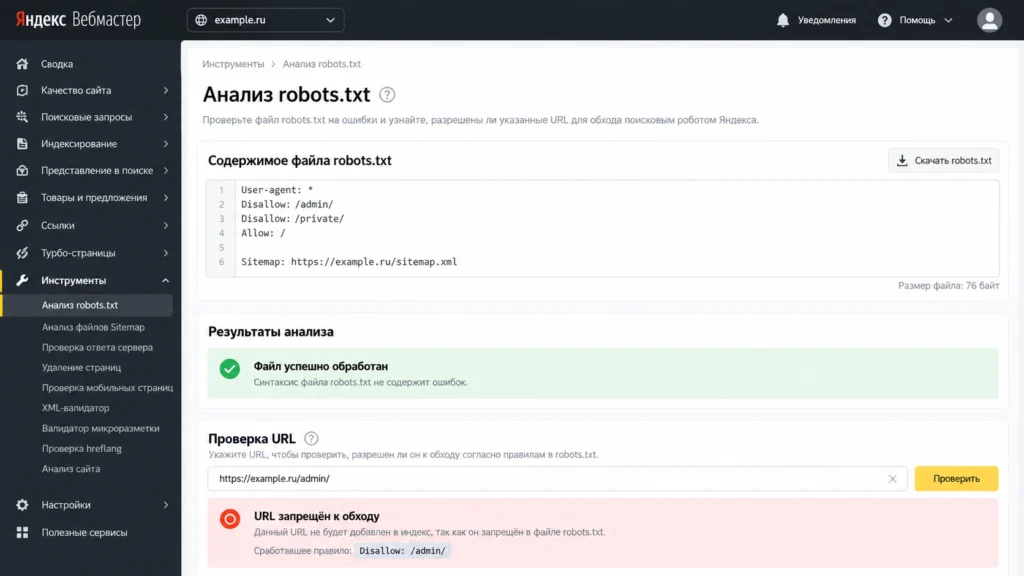
Яндекс Вебмастер предоставляет инструмент «Анализ robots.txt»: он показывает ошибки, применяемые правила, историю изменений и позволяет проверить разрешённость конкретного URL.
В Google Search Console есть отдельный отчёт robots.txt, где видны обнаруженные Google файлы, состояние загрузки, предупреждения и ошибки. Для проверки блокировки конкретной страницы Google рекомендует URL Inspection; разработчикам доступна также открытая библиотека парсера robots.txt.
Как настроить рабочий файл без лишних запретов
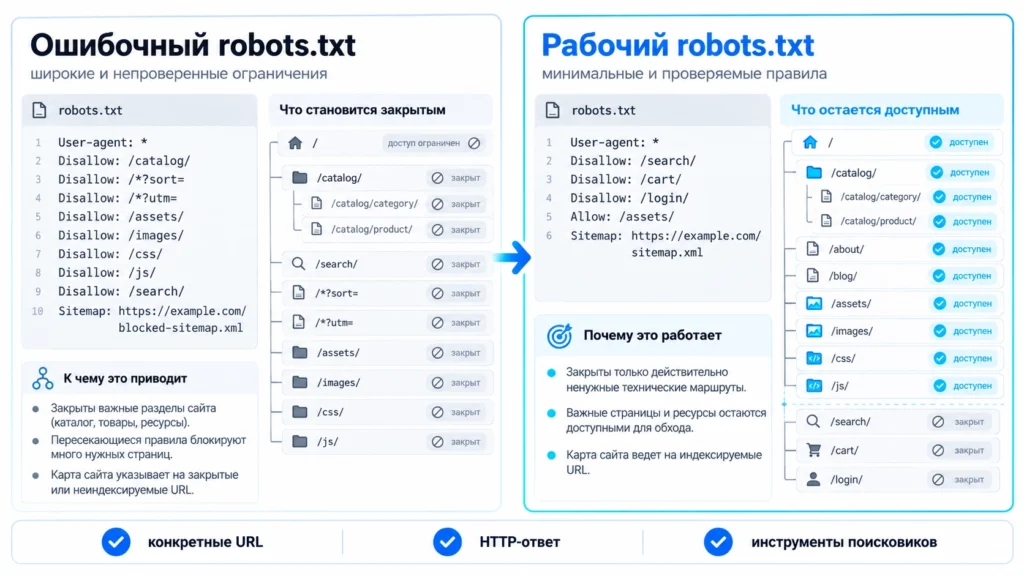
Для большинства обычных сайтов полезнее короткий и понятный файл, чем десятки правил «на всякий случай».
Пример:
User-agent: *
Disallow: /wp-admin/
Disallow: /search/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/sitemap_index.xml
Это только пример структуры, а не универсальный шаблон для копирования. Реальные закрываемые пути определяются устройством конкретного сайта.
Для WordPress особенно важно не копировать чужой wordpress robots.txt без проверки темы, плагинов, AJAX, фильтров и собственной структуры URL. Один сайт может безопасно запретить определённый путь, а другому этот же ресурс нужен для корректного рендеринга или работы страниц.
Не стоит закрывать CSS и JavaScript только потому, что это «технические файлы». Google прямо предупреждает: если блокировка ресурсов мешает crawler корректно понять страницу, качество анализа документа может ухудшиться.
Где robots.txt чаще всего ломают
Закрывают весь сайт при переносе со staging.
User-agent: *
Disallow: /
Такое правило допустимо на закрытом тестовом стенде, но опасно на production. После запуска нужно отдельно проверить фактически отдаваемый файл.
Одновременно используют Disallow и noindex для одной страницы.
Если цель — позволить поисковику увидеть meta robots с noindex, страницу нельзя блокировать для соответствующего робота раньше, чем он прочитает HTML. Для Google это прямо зафиксировано в документации.
Закрывают параметрические URL слишком широким шаблоном.
Например, правило против URL с ? может случайно перекрыть функциональные страницы, если параметры действительно меняют содержимое.
Для Яндекса незначимые параметры можно обрабатывать через Clean-param. Яндекс рекомендует этот механизм для параметров, не меняющих содержание страницы, и отмечает, что большое количество дублей может замедлять обход полезных URL.
Оставляют в Sitemap закрытые страницы.
Это два разных сигнала: Sitemap сообщает поисковику об URL, которые владелец хочет предоставить для обхода, а robots.txt запрещает доступ. Google рекомендует включать в Sitemap URL, которые должны появляться в поиске.
Считают Crawl-delay универсальной директивой.
Google её не поддерживает в robots.txt. У поисковых систем набор поддерживаемых расширений может различаться, поэтому нельзя считать файл единым языком с абсолютно одинаковой интерпретацией всех нестандартных директив.
Практический сценарий: после аудита обнаружены тысячи URL фильтров
Исходная ситуация: интернет-магазин создаёт URL:
/catalog/?sort=price
/catalog/?utm_source=email
/catalog/?utm_source=cpc
/catalog/?session=123
Сначала эти адреса группируются по назначению. Параметр sort может менять порядок товаров, UTM — обычно только источник аналитики, а session вообще не должен создавать поисковую сущность.
Дальше нельзя просто добавить:
Disallow: /*?и считать проблему решённой. Нужно проверить, нет ли полезных страниц с параметрами, как устроена внутренняя перелинковка, какие URL входят в Sitemap и какие варианты уже известны поисковым системам.
Для Яндекса незначимые параметры можно описать, например:
User-agent: Yandex
Clean-param: utm_source&utm_medium&utm_campaign
Clean-param — специальное расширение Яндекса, а не универсальная директива для всех поисковиков.
После правки проверяются конкретные адреса в анализаторе robots.txt, выполняется повторный краул сайта и контролируется фактический обход. Критерий успеха здесь — не мгновенный рост трафика, а отсутствие блокировки важных URL и сокращение ненужных маршрутов обхода.
Если проблема robots.txt оказывается частью более широкой картины — вместе с дублями URL, ошибками Sitemap, неправильной индексируемостью и слабой внутренней структурой, — одной правки файла обычно недостаточно. В рамках поискового продвижения сайта такие ограничения имеет смысл исправлять вместе: после изменения правил повторно обходить проект, проверять доступность важных страниц и отслеживать, как поисковые системы перерабатывают исправленную структуру.
FAQ
Что проверить, если robots.txt закрывает нужные страницы или не убирает ненужные
Потому что запрет обхода и запрет индексирования — разные механизмы. Google и Яндекс допускают ситуацию, когда поисковик знает о закрытом URL из других источников, хотя не может загрузить его содержимое. Если задача именно удалить доступную страницу из выдачи, нужно выбирать соответствующий способ управления индексированием.
Для Google — нет: официальная документация прямо указывает, что правило noindex в robots.txt не поддерживается. Используйте метатег или HTTP-заголовок X-Robots-Tag.
Не обязательно. Если нет разделов, которые требуется ограничивать для crawler, отсутствие специальных правил само по себе не является проблемой. Google указывает, что при отсутствии запрещающего правила доступ к URL по умолчанию разрешён.
Поисковики не обязаны получать файл заново после каждой локальной правки мгновенно. Google обычно кэширует robots.txt и автоматически обновляет его; в Search Console можно посмотреть полученную версию и при необходимости запросить повторное сканирование файла.
Проверьте сам robots.txt, несколько URL каждого затронутого шаблона, HTTP-ответы, Sitemap и инструменты Google и Яндекса. После публикации повторите краул сайта и убедитесь, что важные страницы остались доступны, а ограничения срабатывают только там, где планировалось.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.