15 сентября, 2026 года
 8 мин
 53 просмотра
Сбор семантики начинается с вопроса, какой поисковый спрос должен закрывать сайт. После этого собираются реальные формулировки пользователей, удаляются нерелевантные варианты, выделяются разные интенты и определяется, какие запросы способны работать на одной странице.
Яндекс Вордстат позволяет искать популярные формулировки, похожие запросы, динамику и региональные различия спроса. Для действующего сайта Яндекс Вебмастер дополняет картину фактическими запросами, по которым страницы уже получают показы и клики.
Именно сочетание внешнего спроса и данных самого проекта даёт полезную основу. Выгрузить 50 тысяч строк и торжественно назвать файл семантикой тоже можно, но структура сайта от такого ритуала обычно сама не появляется.
Что такое сбор семантики
Семантика в SEO описывает темы, формулировки и задачи пользователей, связанные с сайтом. Сбор представляет первый технический этап работы с этими данными.
Полный процесс обычно включает:
- Определение тематического сегмента.
- Подготовку базовых фраз.
- Расширение списка запросов.
- Проверку частотности и региона.
- Очистку нерелевантных формулировок.
- Определение интента.
- Кластеризацию.
- Распределение групп по страницам.
Результатом становится семантическое ядро, то есть уже структурированный массив запросов, связанный с архитектурой проекта.
Важно различать сбор и дальнейшую обработку. Парсер способен получить тысячи фраз автоматически, но автоматическая выгрузка сама по себе ничего не говорит о том, какие запросы относятся к одной странице, какие отражают другой продукт, а какие попали в список из-за омонимии.
Как сбор семантики связан с поисковым спросом и SEO
Поисковые запросы показывают язык аудитории.
Например, компания может называть услугу восстановлением климатического оборудования, а пользователи искать ремонт кондиционера. Если структура сайта строится только на внутренней терминологии бизнеса, часть реального спроса способна остаться без подходящих страниц.
Wordstat показывает запросы, содержащие введённое слово или словосочетание с учётом возможных форм. В разделе Топы запросов доступны популярные и похожие формулировки за последний месяц, а данные можно фильтровать по региону и устройству.
Для действующего сайта появляется второй слой данных. Яндекс Вебмастер показывает запросы, по которым ресурс уже участвует в поиске, вместе с показами, кликами, CTR и средними позициями. При этом цифры Вебмастера способны отличаться от Wordstat из-за различий методики расчёта.
Google Search Console решает похожую задачу для Google: Performance report позволяет анализировать реальные запросы, страницы, показы, клики, CTR и среднюю позицию.
У Search Console есть важное ограничение: часть запросов скрывается из-за требований конфиденциальности, а таблица содержит только наиболее значимые строки. Поэтому Search Console полезен как источник фактической видимости сайта, но считать его полным источником всей семантики проекта нельзя.
Как собрать семантику для сайта
Начинать стоит с карты бизнеса, а не с кнопки парсера.
Выпишите основные услуги, товары, категории, проблемы клиентов и типовые формулировки из заявок, звонков или внутренних материалов. Они станут исходными масками для расширения.
Например, для компании по установке кондиционеров стартовый набор может выглядеть так:
установка кондиционеровмонтаж кондиционеровобслуживание кондиционеровремонт кондиционеровчистка кондиционеров
Дальше каждая тема расширяется через Wordstat.
Шаг 1. Собрать исходные запросы
Введите базовую фразу в Топы запросов. Просмотрите основную выборку и похожие запросы.
Wordstat позволяет фильтровать результаты по региону и устройству, а данные разделов можно скачивать в CSV.
Для локального бизнеса регион стоит задавать сразу. Общероссийская частотность для услуги, которую компания оказывает в одном городе, способна красиво смотреться в отчёте и почти бесполезно описывать реальный рынок.
Шаг 2. Добавить данные работающего сайта
В Яндекс Вебмастере проверьте запросы, по которым уже показываются важные URL.
Для отдельной страницы расширенная аналитика позволяет выгрузить дату, URL, запрос, регион, клики, показы и позицию. Это помогает найти реальные формулировки, которые могли отсутствовать в исходной карте семантики.
Для Google аналогично стоит проверить Queries и Pages в Search Console. Часто существующая страница уже получает показы по формулировкам, которые при первоначальном сборе никто в план не включал.

Шаг 3. Очистить массив
После расширения начинается наиболее важная часть работы.
Удаляются:
- запросы другого товара или услуги;
- чужие города и регионы;
- информационные темы, которые проект не планирует закрывать;
- вакансии, инструкции и бесплатные варианты при коммерческом интенте;
- омонимия;
- явные дубли;
- бессмысленные и случайные сочетания.
При большом проекте расширение семантики стоит отделять от очистки: сначала системно получить максимум релевантных направлений, затем сокращать массив по бизнес-логике и интенту.
Шаг 4. Определить интент
Две похожие фразы способны требовать разные страницы.
Например:
купить кондиционерустановка кондиционеракак выбрать кондиционер
Первая ведёт к товарному спросу, вторая к услуге, третья к информационному материалу.
Яндекс Вебмастер в инструменте Подбор поисковых запросов и анализ рынка использует автоматические кластеры для фраз, близких по смыслу или пользовательскому интенту. Сервис также показывает спрос, клики и конкурентность.
Это хороший вспомогательный источник, хотя итоговую архитектуру сайта всё равно стоит сверять с бизнес-моделью и самой выдачей.

Шаг 5. Сгруппировать запросы
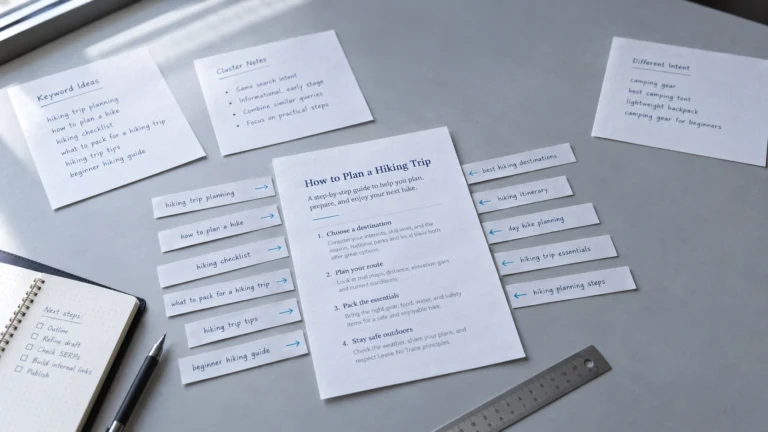
Кластеризация объединяет запросы, которые рационально закрывать одной страницей.
Практически применяются два слоя проверки:
- смысл и пользовательская задача;
- состав поисковой выдачи.
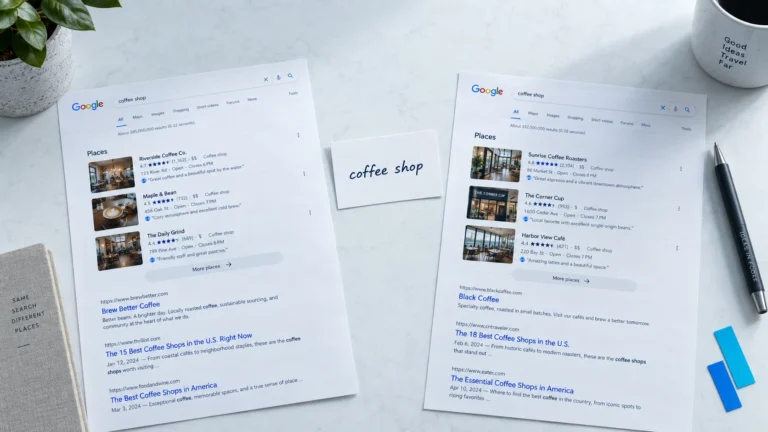
Второй подход часто называют SERP-кластеризацией: сравнивается пересечение результатов по нескольким запросам. Это отраслевой метод, а не официальное правило Яндекса или Google. Его стоит использовать как диагностический инструмент, а не как математический приказ создать или объединить URL.

Как использовать результат в структуре сайта и контенте
После кластеризации семантика становится картой страниц.
Для каждой группы стоит зафиксировать:
| Поле | Что указать |
|---|---|
| Кластер | Основную тему группы |
| Интент | Коммерческий, информационный или другой |
| Основной запрос | Репрезентативную формулировку |
| Дополнительные запросы | Близкие варианты |
| Целевой URL | Существующую или будущую страницу |
| Статус | Создать, обновить, оставить |
| Приоритет | Значимость для проекта |
Так семантика сайта связывается со структурой, а не остаётся отдельной таблицей на несколько тысяч строк.
Если нужная страница уже существует, семантику используют для проверки полноты содержания, заголовков и соответствия интенту. Если отдельной страницы пока нет, кластер способен стать основанием для создания нового URL.
При этом копировать все запросы из группы в текст буквально не требуется. Google прямо относит неестественное многократное повторение слов ради манипуляции выдачей к keyword stuffing. Яндекс аналогично относит длинные списки запросов и переоптимизированные SEO-тексты без пользовательской ценности к нарушениям.
Семантика подсказывает, что хочет аудитория. Она вовсе не выдаёт норматив, сколько раз употребить каждый ключ.
Отдельно стоит проверить сезонность запросов. В Wordstat раздел Динамика по умолчанию показывает помесячные данные за последние два года, а более длинный период позволяет смотреть месячную и недельную историю вплоть до пяти лет. Подневная детализация доступна за последние 60 дней.
Для сезонных категорий это влияет на приоритет и срок подготовки страниц.
Практический пример
Представим компанию, которая занимается ремонтом и установкой кондиционеров в Перми. Цифры ниже иллюстрируют методику, поскольку проектная статистика к редакционной строке отсутствует.
На первом этапе собрано 780 запросов из Wordstat и поисковых данных действующего сайта.
После очистки:
| Этап | Осталось запросов |
|---|---|
| Первичный массив | 780 |
| После удаления чужой географии | 640 |
| После очистки нерелевантных тем | 510 |
| После удаления дублей | 460 |
| После проверки интента | 430 |
Дальше 430 фраз распределяются по группам.
Одна группа объединяет запросы про установку кондиционера. Вторая относится к ремонту. Третья описывает обслуживание. Отдельная информационная группа содержит вопросы про выбор места установки.
После проверки выдачи выясняется, что запрос монтаж кондиционера Яндекс преимущественно связывает с тем же типом страниц, что и установка кондиционера. Создавать два почти одинаковых URL только ради разницы слов выглядит слабой идеей.
В итоге вместо сотен отдельных страниц появляется ограниченная карта целевых URL.

Типичные ошибки при работе с семантикой
Первая ошибка — собирать всё подряд. Огромное ядро выглядит солидно, но нерелевантные запросы только усложняют структуру и приоритизацию.
Вторая ошибка — опираться исключительно на Wordstat. Для действующего сайта важно добавлять реальные запросы из Вебмастера и Search Console. При этом методики сервисов различаются, поэтому цифры стоит использовать по назначению.
Третья ошибка — создавать отдельную страницу под каждую формулировку. Сначала проверяются интент и пересечение результатов.
Четвёртая ошибка — кластеризовать исключительно автоматически. Алгоритм способен объединить близкие запросы, но бизнес-логика иногда требует другого решения.
Пятая ошибка — игнорировать региональность и сезонность. Особенно больно это выглядит у локальных и сезонных услуг.
Шестая ошибка — превращать семантику в техническое задание на количество вхождений. Google и Яндекс прямо выступают против искусственного насыщения страницы запросами.
Вывод: что делать на практике
Сбор семантики стоит начинать с бизнес-задачи и базовых тем. Затем запросы расширяются через Wordstat и фактические данные сайта, очищаются от мусора, группируются по интенту и проверяются по выдаче.
Финальным результатом должна стать карта страниц: какой кластер какую задачу пользователя закрывает, какой URL за него отвечает и что требуется сделать с этой страницей.
Если после недели работы получился только Excel на двадцать тысяч строк, сбор закончился чуть раньше самого полезного места.
Материал подготовлен Максимом Вагизовым для vagizov.com . При цитировании обязательна активная ссылка на источник.
Подробнее об авторских правах