15 сентября, 2026 года
 5 мин
 44 просмотра
Семантика сайта нужна не ради количества ключей. Её задача — связать реальные поисковые формулировки с задачами пользователя и определить, какой URL должен на них отвечать. Рабочий результат выглядит как цепочка «запрос → интент → кластер → страница», а не как таблица на тысячи строк.
Google не требует отдельного файла «семантического ядра», но рекомендует использовать слова, которыми люди ищут контент, в заметных и уместных элементах страницы. Яндекс прямо связывает релевантность с тем, насколько содержание отвечает формулировке запроса. Это подтверждает пользу работы с семантикой, но не делает размер ядра или плотность ключей самостоятельным доказанным фактором ранжирования.
Официальные источники: Google Search Essentials, рекомендации Яндекс Вебмастера о соответствии сайта запросам.
Что такое семантика сайта
В SEO под семантикой сайта обычно понимают модель поискового спроса: что ищут пользователи, какой интент стоит за запросом и какая страница должна отвечать на него. Это профессиональный термин, а не отдельный файл для поисковой системы.
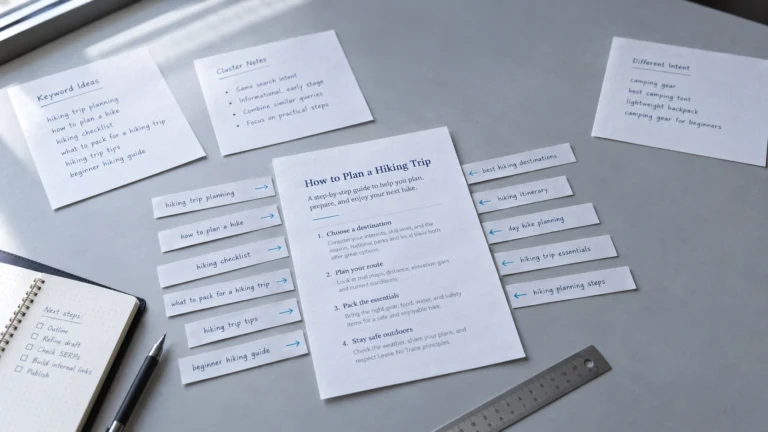
Семантическое ядро — практическая форма такой модели: список запросов после очистки, группировки и привязки к URL. Полезное ядро отвечает на три вопроса: какие темы действительно ищут, какие фразы можно объединить одним интентом и где нужны отдельные страницы.
Как семантика сайта связана с поисковым спросом и SEO
Семантика находится между исследованием спроса и архитектурой сайта. Запросы собирают, очищают и группируют, после чего кластеру назначают подходящий тип страницы: услугу, категорию, карточку товара, статью или инструкцию.
Google рекомендует использовать понятные пользователям слова в заголовках, тексте, alt и ссылках, но предупреждает против чрезмерного повторения ключей. Яндекс также требует, чтобы содержание страницы соответствовало запросу. Поэтому цель — не «вставить все фразы», а сделать страницу понятным ответом на одну группу близких задач.
На действующем сайте гипотезу проверяют данными Search Console и Яндекс Вебмастера: запросами, показами, кликами и URL. Так видно, по чему страница уже появляется в поиске и не распределился ли один интент между несколькими адресами.

Как собрать или проверить данные по теме семантики сайта
Для нового проекта начинают с ассортимента, услуг и задач аудитории, затем расширяют базовые маркеры реальными запросами. Вордстат показывает статистику, динамику, региональные различия и связанные формулировки; операторы уточняют выборку, но не делают её готовым ядром.
Отдельный сбор семантики включает расширение маркеров, очистку, проверку интента и кластеризацию. Когда основная структура уже собрана, расширение семантики помогает находить новые формулировки без полного пересбора ядра.
Для действующего сайта достаточно сопоставить три слоя данных:
| Источник | Что смотреть | Что проверяем |
|---|---|---|
| Вордстат | формулировки, динамика, регион | есть ли спрос и как его называют |
| Search Console / Вебмастер | запросы, показы, клики, URL | по чему сайт уже показывается |
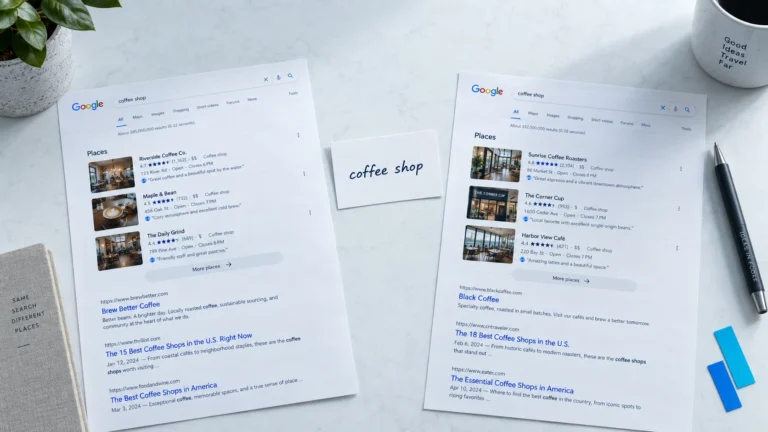
| текущая выдача | типы результатов | какой формат страницы соответствует интенту |
Частотность нельзя считать прогнозом трафика: она не учитывает ваши позиции, CTR, конкуренцию и особенности выдачи. Для тем с заметными колебаниями отдельно проверяйте сезонность запросов.

Как использовать результат в структуре сайта и контенте
После кластеризации каждой смысловой группе назначают один основной URL или решают создать новый. Если несколько запросов означают одну задачу и выдача показывает одинаковый тип результатов, их обычно разумно объединять. Если за похожими словами стоят разные действия — например, «купить» и «как выбрать» — одной страницей закрыть оба интента сложнее.
Затем кластер переводят в требования к странице: H1, SEO Title, основной ответ, смысловые блоки, факты и внутренние ссылки. Список запросов не должен превращаться в перечень обязательных точных вхождений. Для существующей страницы полезно выгрузить фактические запросы по URL и проверить, совпадает ли реальная видимость с целевым кластером.

Практический пример
Допустим, компания устанавливает видеонаблюдение. В сыром списке есть «установка видеонаблюдения», «монтаж камер видеонаблюдения», «видеонаблюдение цена», «камеры для склада» и «как выбрать камеру видеонаблюдения».
По совпадению слов можно ошибочно сделать пять страниц. После проверки интента первые три запроса могут оказаться одной коммерческой группой, если страница услуги содержит понятный блок цены. «Камеры для склада» нужно проверить отдельно: выдача может показывать отраслевые посадочные страницы. «Как выбрать камеру» — информационная задача и кандидат на статью.
Результат — не максимальное число URL, а структура, где у каждой страницы есть собственная задача. После публикации решение проверяют по фактическим запросам и показам в Search Console и Яндекс Вебмастере. Это рабочий критерий качества распределения, а не гарантия роста позиций.

Типичные ошибки при работе с семантикой
Первая ошибка — оценивать ядро по числу строк. Большой список легко содержит нерелевантные фразы, повторы, другой регион и запросы, на которые бизнес не может дать полезный ответ.
Вторая — создавать отдельный URL под каждую формулировку. Это раздувает структуру и может породить почти одинаковые страницы. Google относит doorway abuse к спамным практикам; похожие посадочные допустимы только при самостоятельной ценности.
Третья — механически повторять ключи в тексте. Это не заменяет полного ответа и может ухудшить читаемость. Четвёртая — считать семантику одноразовой работой: спрос, ассортимент и фактические запросы меняются, поэтому ядро нужно периодически сверять с данными поиска.
Материал подготовлен Максимом Вагизовым для vagizov.com . При цитировании обязательна активная ссылка на источник.
Подробнее об авторских правах