15 сентября, 2026 года
 6 мин
 75 просмотров
Плотность ключевых слов — техническая метрика текста, а не настройка поискового ранжирования. Она показывает, какую долю текста занимает выбранное слово или фраза, и иногда помогает заметить неестественные повторы.
Google определяет keyword stuffing через попытку заполнить страницу словами или числами ради манипуляции поисковыми позициями. В качестве признака компания прямо приводит повторение слов и фраз настолько часто, что текст начинает звучать неестественно. Числового порога в этом правиле нет.
Яндекс использует похожую логику: к нарушениям относятся запросный спам и переоптимизация, когда слова или словосочетания употребляются избыточно, объём текста искусственно увеличивается, а дополнительная задача пользователя при этом не решается.
Что такое плотность ключевых слов
В простейшем варианте показатель можно рассчитать так:
плотность = количество вхождений / общее количество слов × 100%
Например, если условная фраза встретилась 6 раз в тексте на 1 000 слов, простая математическая плотность составит 0,6%.
Но даже сама методика расчёта неоднозначна. Один сервис считает только точное вхождение, другой объединяет словоформы, третий анализирует отдельные слова внутри фразы. Поэтому сравнивать проценты из разных инструментов без понимания алгоритма бесполезно.
И главное: в актуальной официальной документации Google и Яндекса нет опубликованной нормы вида «ключ должен занимать 2%, 3% или 5% текста». Правила описывают естественность, релевантность, полезность и отсутствие искусственной переоптимизации.
Рабочие ключевые слова seo поэтому нужны прежде всего для понимания спроса и темы страницы, а не для достижения заранее выбранного процента.
Как плотность ключевых слов связана с поисковым спросом и SEO
Поисковая фраза появляется в тексте потому, что страница отвечает на соответствующую тему или задачу пользователя. Причинно-следственная связь должна идти именно в таком направлении.
Например, статья про ремонт холодильника естественно содержит слова «холодильник», «ремонт», названия неисправностей и деталей. Их повторяемость обусловлена темой.
Google рекомендует думать о словах, которыми разные пользователи способны искать материал, но отдельно поясняет: современные системы языкового сопоставления понимают связь страницы со множеством запросов даже без точного употребления каждой возможной вариации.
Яндекс оценивает релевантность шире формального совпадения запроса: в актуальной документации она описывается как соответствие страницы реальной задаче пользователя.
Отсюда практический вывод: ключевые запросы помогают определить содержание страницы, но увеличение количества вхождений само по себе не доказывает повышение релевантности.

Как проверить плотность и переоптимизацию
Сам процент можно посчитать редактором или любым текстовым анализатором. Но полезная проверка начинается после цифры.
Стоит задать пять вопросов:
| Проверка | Что искать |
|---|---|
| Естественность | Звучат ли повторы нормально при чтении |
| Польза | Добавляет ли очередное упоминание новую информацию |
| Интент | Отвечает ли текст реальной задаче пользователя |
| Структура | Используются ли нормальные заголовки, абзацы и списки |
| Вариативность | Пишет ли автор естественным языком вместо одной заученной конструкции |
Google прямо запрещает повторять слова или фразы настолько часто, что они начинают звучать неестественно.
Яндекс, напротив, отдельно поясняет и допустимые случаи: умеренные повторы в навигации, каталогах, прайс-листах, стандартах и инструкциях сами по себе нарушением не считаются, если обусловлены спецификой страницы.
Поэтому счётчик без контекста способен выдавать ложные тревоги. У технической инструкции термин закономерно повторяется чаще, чем у журнального материала.

Как использовать результат в структуре сайта и контенте
Правильная последовательность выглядит так:
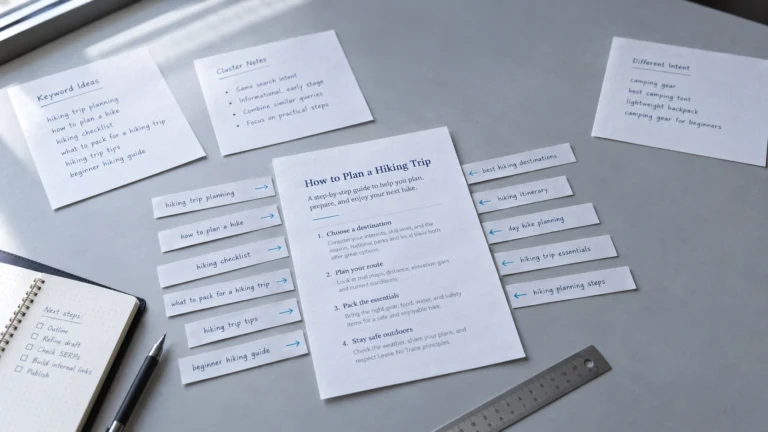
запрос → интент → кластер → страница → естественный текст

Близкие ключевые фразы обычно объединяются вокруг одной задачи. Нет необходимости буквально перечислять все варианты в тексте.
То же относится к маски ключевых слов: они помогают расширять семантику, но найденные комбинации не превращаются автоматически в список обязательных вхождений.
Отдельно стоит забыть старую идею использовать <meta name="keywords"> как скрытое место для семантики. Google официально указывает, что этот метатег игнорируется и никак не влияет на индексирование и ранжирование.
Практический пример
Представим страницу услуги по ремонту холодильников. Проектных данных к редакционной строке нет, поэтому пример методологический.
Редактор получает кластер:
ремонт холодильниковремонт холодильника на домумастер по ремонту холодильниковремонт холодильника цена
Первый вариант текста механически повторяет «ремонт холодильников» практически в каждом абзаце:
Ремонт холодильников выполняют мастера по ремонту холодильников. Чтобы заказать ремонт холодильников, оставьте заявку на ремонт холодильников…
Процент вхождений растёт, но дополнительной информации пользователь почти не получает. По критериям Google такой текст приближается к неестественному повторению ключей, а по терминологии Яндекса — к запросному спаму или переоптимизации.
Во втором варианте страница раскрывает:
- какие неисправности устраняются;
- какие марки обслуживаются;
- есть ли выезд;
- как формируется стоимость;
- что проверить до приезда мастера;
- как проходит ремонт.
Основная фраза при этом употребляется там, где звучит естественно. Остальная семантика раскрывается через нормальный русский язык и содержание.
Сравнивать варианты полезнее не по тому, получился ли условный показатель 1,8% вместо 3,2%, а по тому, исчезли ли искусственные повторы и стала ли страница лучше отвечать на задачу.

Типичные ошибки при работе с семантикой
Первая ошибка — искать универсальную идеальную плотность. В проверенных официальных правилах Google и Яндекса числового порога для нормального текста нет.
Вторая — оптимизировать процент раньше содержания. Хорошая цифра в анализаторе никак не гарантирует, что страница отвечает на пользовательскую задачу.
Третья — считать каждый повтор проблемой. В каталоге, инструкции, спецификации или прайс-листе термин способен закономерно встречаться часто. Яндекс прямо приводит такие случаи как допустимые.
Четвёртая — пытаться перечислить все запросы из семантического ядра. Google умеет понимать различные формулировки и не требует буквального употребления каждой вариации.
Пятая — хранить семантику в meta keywords в надежде повлиять на Google. Этот тег поиском Google игнорируется.
Вывод: что делать на практике
Плотность ключевых слов можно использовать как вспомогательную редакторскую диагностику, но не как целевой SEO-показатель.
Сначала определите интент и содержание страницы, напишите полноценный ответ пользователю и только затем проверьте, не появились ли искусственные повторы. Не подгоняйте текст под заранее выбранные 2%, 3% или любую другую красивую цифру: поисковики такой нормы не публикуют.
Если анализатор сообщает 2,73%, а текст всё равно невозможно читать, победил анализатор. Страница — не очень.
Материал подготовлен Максимом Вагизовым для vagizov.com . При цитировании обязательна активная ссылка на источник.
Подробнее об авторских правах