async часто воспринимают как простой способ «убрать JavaScript из блокировки загрузки». Это только часть картины. Браузер действительно может получать внешний скрипт параллельно разбору HTML, однако выполняет его сразу после готовности — даже если документ ещё не разобран полностью.
Для независимого счётчика это обычно нормально. Для кода, который строит основной контент, создаёт навигацию, меняет метатеги или ожидает другую библиотеку, такое поведение способно превратить обычную оптимизацию загрузки в плавающую техническую ошибку.
Что именно меняет async в выполнении JavaScript
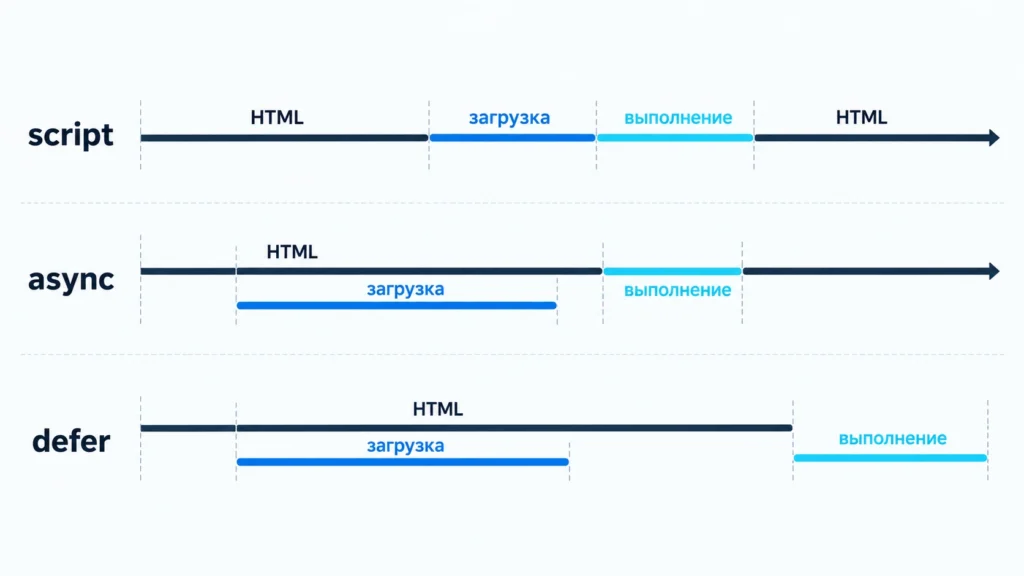
У внешнего классического скрипта без async и defer браузер приостанавливает разбор документа, получает файл и выполняет его. При async файл загружается параллельно, но выполняется сразу, как только будет готов. Порядок между несколькими async-скриптами не гарантируется.
defer решает другую задачу: файл тоже можно получать параллельно разбору HTML, но выполнение откладывается до завершения разбора документа, причём классические отложенные скрипты сохраняют порядок появления.
| Подключение | Получение файла | Когда выполняется | Гарантия порядка |
|---|---|---|---|
<script src> | с остановкой парсинга | сразу | порядок документа |
<script async> | параллельно | как только файл готов | нет |
<script defer> | параллельно | после разбора HTML | да, для классических defer-скриптов |
<script type="module"> | параллельно | после разбора документа | учитывает граф модулей |
У модульных скриптов есть отдельный нюанс: обычный type="module" уже ведёт себя отложенно относительно разбора HTML. Добавление async заставляет модуль и его зависимости выполняться, как только граф станет готов, поэтому здесь тоже нельзя бездумно рассчитывать на момент окончания парсинга.
Когда Async JavaScript становится проблемой для индексации
Google способен выполнять JavaScript. Обработка JavaScript-страницы включает получение URL, рендеринг и последующую работу с результатом: поисковая система использует отрендеренный HTML, в том числе для обнаружения содержимого и ссылок.
Поэтому вопрос не в том, «понимает ли Google async». В javascript seo важнее другое: получит ли рендерер стабильно тот же смысловой результат, который получает обычный пользователь.
Проблема начинается, когда критическая часть документа существует только после успешного выполнения хрупкой цепочки:
- основной текст добавляется после ответа API;
app.jsзапускается раньше библиотеки, от которой зависит;- скрипт обращается к элементу DOM, который ещё не создан;
- ссылка существует как обработчик клика, а не как обычный
<a href>; - контент появляется только после прокрутки или другого действия пользователя;
- ошибка одного запроса оставляет приложение в состоянии пустого
app shell.
В такой архитектуре рендеринг страницы становится не просто способом показать интерактивный интерфейс, а обязательным условием существования самого индексируемого документа.
Почему «у меня в Chrome всё работает» недостаточно
Плавающие ошибки async особенно неприятны тем, что зависят от скорости сети, кэша и порядка получения ресурсов.
Представим каталог. В нём отдельно подключены библиотека, конфигурация и код приложения:
<script async src="/js/vendor.js"></script>
<script async src="/js/config.js"></script>
<script async src="/js/catalog.js"></script>
Разработчик рассчитывает, что vendor.js и config.js будут готовы раньше catalog.js. Атрибут async такой гарантии не даёт.
На рабочем компьютере библиотека уже находится в кэше, поэтому каталог строится правильно. При другом наборе сетевых задержек catalog.js способен выполниться первым, получить ошибку и не вставить карточки товаров в DOM. В итоге URL отвечает 200 OK, оболочка страницы присутствует, но содержательная часть отсутствует.
Исправление здесь не сводится к замене всех async на defer. Сначала нужно разделить независимый и критический код. Аналитический скрипт, который не формирует страницу, можно оставить асинхронным. Зависимые классические скрипты логичнее выполнять детерминированно, например через defer, модульный граф или явное управление зависимостями.
Ещё надёжнее, когда заголовок, основной текст, важные ссылки и другие необходимые поиску элементы присутствуют уже в HTML-ответе или появляются через устойчивый серверный/гибридный рендеринг.
Какие ошибки нужно искать кроме порядка скриптов
Критический контент требует действия пользователя
Google прямо рекомендует не строить загрузку нужного контента так, чтобы для неё требовались клик или прокрутка. Lazy loading допустим, но нужный фрагмент должен появляться по условиям видимости, а не ждать ручного взаимодействия.
Внутренние ссылки существуют только в JavaScript
Для обнаружения URL надёжная конструкция — обычный элемент <a> с корректным href. Кнопка, span или элемент с одним onclick не являются равноценной заменой индексируемой ссылке.
Метаданные меняются после нестабильного запроса
Если title, robots или canonical строятся клиентским кодом, ошибка JavaScript способна оставить другое состояние документа. Для canonical Google допускает генерацию через JavaScript, но предпочтительнее задавать его в HTML и не создавать конфликтующие значения.
Это особенно важно там, где CMS уже выводит собственный canonical. Зона wordpress canonical должна иметь один предсказуемый источник значения, а не конкурировать с поздним клиентским скриптом.
Код рассчитывает на сохранённое состояние
Логика, без которой невозможно получить основной контент, не должна зависеть только от localStorage, sessionStorage, ранее установленных cookies или пользовательской сессии. Рендерер поисковой системы не обязан воспроизводить последовательность действий реального постоянного посетителя.
Практический сценарий: каталог есть у пользователя, но пуст в рендере Google
Исходная ситуация: SPA-каталог отвечает 200, содержит H1 и оболочку приложения, а карточки и ссылки на товары получает через JavaScript. После изменения загрузки ресурсов разработчики переводят несколько файлов на async. В обычном браузере заметных проблем почти нет, но часть категорий индексируется нестабильно.
Диагностика начинается не с позиций, а с трёх состояний документа:
- исходный HTML от сервера;
- DOM после выполнения JavaScript в обычном браузере;
- отрендеренный HTML в Live Test инструмента проверки URL Search Console.
Если карточки есть только во втором варианте, нужно смотреть загруженные ресурсы и JavaScript-ошибки. Далее проверяют, не запускается ли код приложения до готовности зависимости и не требует ли получение данных состояния, которого нет при чистом открытии URL.
Рабочее исправление может выглядеть так:
<script async src="/js/analytics.js"></script>
<script defer src="/js/vendor.js"></script>
<script defer src="/js/catalog.js"></script>
Независимая аналитика остаётся async, а связанные скрипты получают детерминированный порядок. Если карточки являются основным содержимым категории, более сильное архитектурное решение — отдавать их сервером или предусмотреть устойчивый серверный/гибридный вариант, а JavaScript использовать для последующей интерактивности.
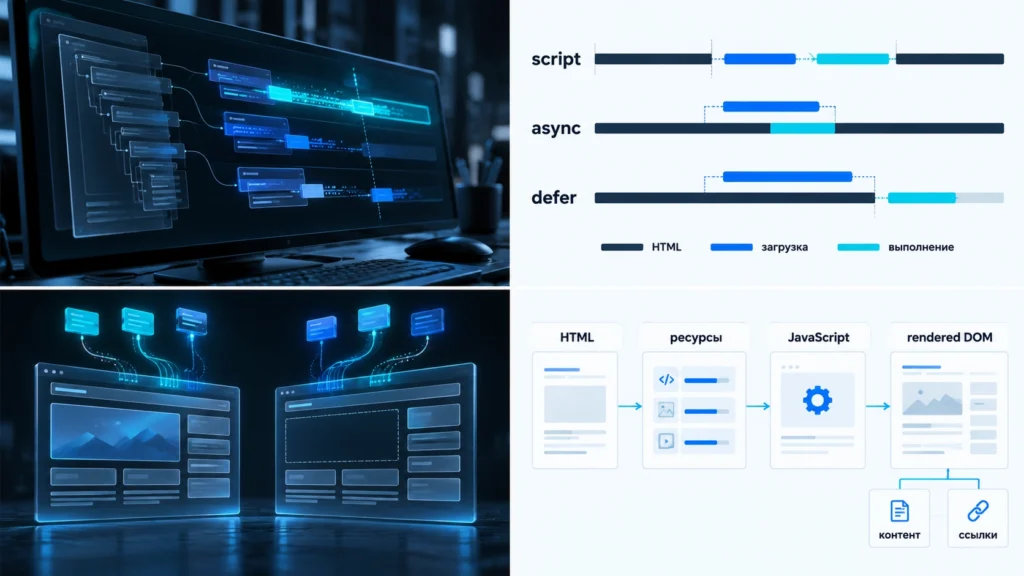
Ожидаемый результат проверки — не просто отсутствие ошибок в консоли. Основной текст, товарные ссылки, изображения и необходимые метаданные должны присутствовать в отрендеренном HTML без кликов, прокрутки и случайно сохранившегося состояния браузера.
Когда async действительно стоит оставить
async хорошо подходит скрипту, если одновременно выполняются три условия: он независим от других файлов, ему не требуется полностью построенный DOM и его сбой не убирает основное содержимое страницы.
Поэтому переносить на async все файлы ради формального сокращения parser-blocking JavaScript — плохая стратегия. Нужен разбор роли каждого ресурса.
Для критического кода полезнее задать другой вопрос: что увидит новый посетитель при первом открытии URL, если кэш пуст, сеть медленнее обычного, один API-запрос задержался, а порядок получения файлов изменился? Если ответ — «страница потеряет значимую часть содержимого», проблема уже архитектурная.
Проверять такую страницу следует по конечному результату: один URL, корректный HTTP-ответ, доступные ресурсы, полноценный rendered DOM, обычные href-ссылки и стабильные поисковые метаданные. Если эти условия выполняются независимо от случайного порядка сетевых событий, async остаётся полезным инструментом, а не источником трудноуловимых ошибок индексации.
FAQ
Где проходит граница между безопасным async и проблемой индексации
Нет. async — штатный механизм загрузки скриптов, и его наличие не является негативным SEO-фактором. Риск появляется, если результат страницы зависит от порядка выполнения нескольких скриптов, готовности DOM, ответа API или другой операции, которая может завершиться не так, как ожидает приложение.
Если скрипт зависит от DOM или других скриптов, для классического внешнего JavaScript обычно предсказуемее defer, поскольку отложенные скрипты выполняются после разбора документа и сохраняют порядок. async лучше подходит независимым сценариям, которым не требуется гарантированная последовательность, например части аналитики.
Да, Google умеет выполнять JavaScript и использовать отрендеренный HTML для индексирования. Но критический контент всё равно должен стабильно появляться при рендеринге: ошибка скрипта, заблокированный ресурс, зависимость от пользовательского действия или неудачный API-запрос способны оставить нужный фрагмент вне итогового DOM.
Сравните исходный HTML, DOM обычного браузера и HTML из проверки Live URL в Search Console. Одновременно проверьте загруженные ресурсы и JavaScript-ошибки. Если нужный контент есть у пользователя, но отсутствует в отрендеренной Google версии, причина уже локализована значительно точнее, чем при проверке одной позиции страницы в поиске.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.