SPA может выглядеть для посетителя идеально: каталог переключается мгновенно, карточки товаров открываются без перезагрузки, фильтры работают красиво. Но поисковику важна не красота перехода, а более приземлённый вопрос: что именно он получает по конкретному URL и может ли из этого получить полноценную страницу.
Представьте ресторан, где посетителю через минуту приносят отличное блюдо, а проверяющему на входе выдают пустую тарелку и инструкцию: «подождите, сейчас всё соберётся». Иногда действительно соберётся. Для SEO гораздо спокойнее, когда основная часть блюда уже находится на тарелке.
Именно этим занимается SPA SEO: не «продвигает React» и не заставляет поисковик любить JavaScript, а устраняет технические ситуации, из-за которых публичные страницы приложения плохо обнаруживаются, рендерятся или индексируются.
SPA SEO начинается с вопроса: что получает поисковый робот
Обычная серверная страница чаще всего приходит уже с заголовком, текстом, ссылками и другими важными элементами HTML.
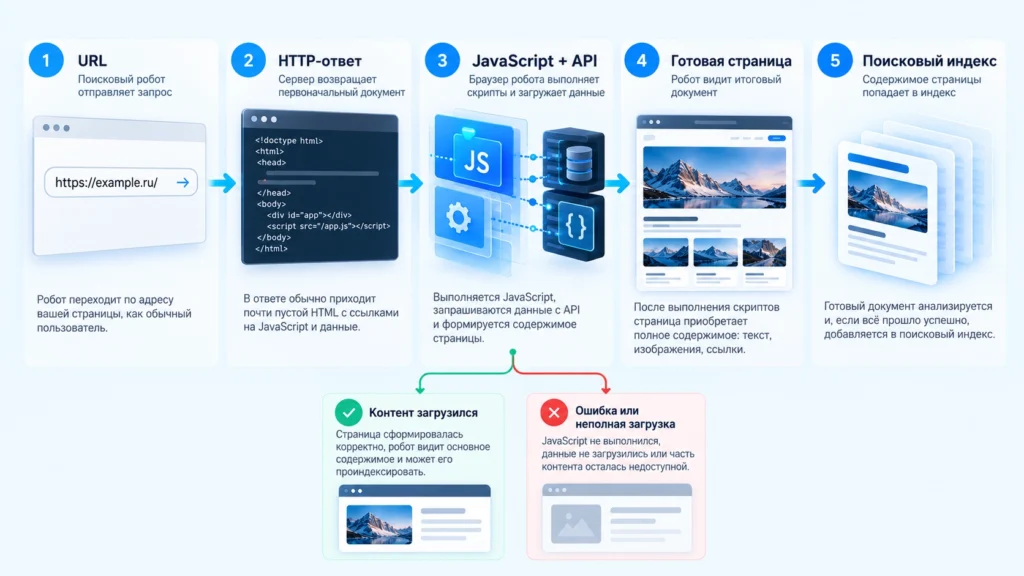
В SPA сценарий может быть другим:
- сервер возвращает базовый HTML-каркас;
- браузер загружает JavaScript;
- приложение обращается к API;
- получает данные;
- JavaScript собирает окончательный экран.
Для пользователя весь процесс занимает мгновение. Для поисковой системы это несколько отдельных этапов.
Google официально описывает обработку JavaScript через цепочку обход → рендеринг → индексирование. JavaScript выполняется в Web Rendering Service на базе Chromium. Это означает, что утверждение «Google вообще не видит JavaScript» давно неверно.
Но из этого не следует обратное: «раз Google умеет выполнять JavaScript, можно больше ни о чём не думать».
Если скрипт завершился ошибкой, ресурс закрыт, данные API не загрузились, контент зависит от пользовательского действия или маршрут построен неправильно, итоговый документ может оказаться неполным.
Подробнее сам путь от обнаружения URL до поискового индекса разобран в материале «Индексация сайта: как поисковики находят страницы».
Пять ошибок SPA, которые действительно мешают поиску
Один адрес используется для разных страниц
У бизнеса есть каталог, десять категорий и сотни карточек, но приложение меняет только содержимое экрана. Если поисковая система не получает самостоятельный URL для каждого важного состояния, ей нечего индексировать как отдельные документы.
Для публичных страниц логика должна быть привычной:
/catalog/
/catalog/divany/
/product/divan-model-123/
Старый вариант вроде /#/product/123 плох тем, что содержимое фактически завязывается на URL-фрагмент. Google рекомендует не использовать фрагменты # для переключения индексируемого содержимого и применять History API. Аналогичную рекомендацию даёт Яндекс для AJAX-сайтов.
Навигация работает, но ссылок нет
Пользователь нажимает карточку товара и переходит дальше. Однако переход может быть реализован как JavaScript-событие на div, а не как обычная ссылка с href.
Человеку всё равно. Роботу — уже нет.
Для важных переходов безопаснее иметь нормальную HTML-ссылку:
<a href="/catalog/divany/">Диваны</a>То есть хороший интерфейс и хорошая структура внутренних ссылок должны работать вместе, а не по очереди.
На всех маршрутах остаются одинаковые метаданные
Типичная SPA загружается из одного index.html, а затем меняет экран. Если настройки сделаны неаккуратно, каталог, карточка товара и страница услуги могут получить одинаковый title, description или неправильный canonical.
Особенно неприятен canonical, который первоначально указывает на главную, а JavaScript позже пытается заменить его на текущую страницу. Google рекомендует по возможности задавать canonical уже в исходном HTML и не менять его JavaScript.
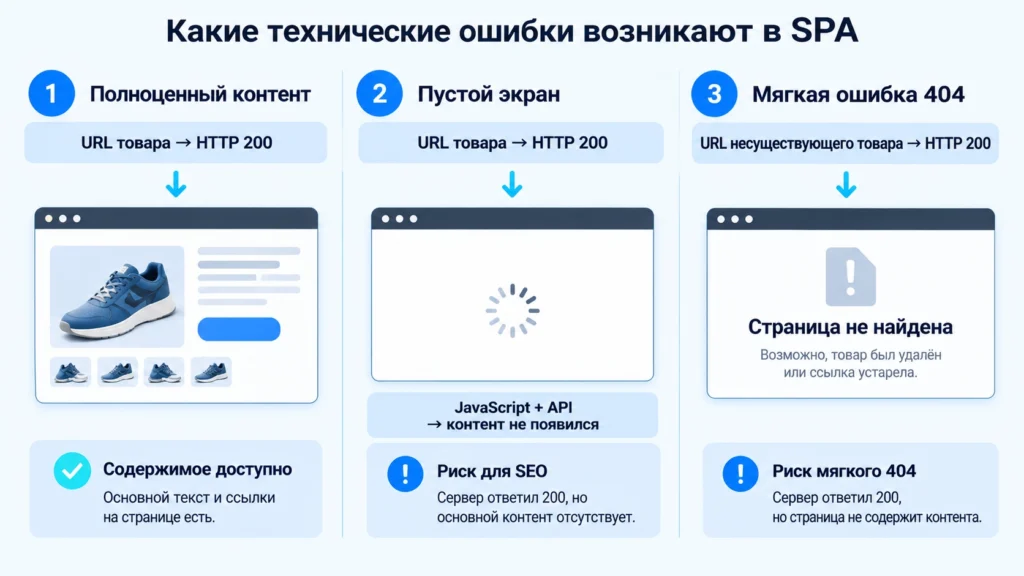
Несуществующая страница выглядит как 404, но отвечает 200 OK
Человек открывает удалённый товар и читает: «Ничего не найдено».
Сервер при этом радостно сообщает:
HTTP/1.1 200 OKДля SPA это распространённый сценарий: приложение само рисует сообщение об ошибке, а HTTP-ответ остаётся успешным.
Такие URL могут превратиться в soft 404. Если товара или страницы действительно нет, технический ответ тоже должен соответствовать ситуации.
Подробнее роль серверных ответов при обходе разобрана в статье «Поисковый робот: как работает и что проверять».
Контент появляется только после действия человека
Если описание товара загружается только после клика по вкладке, список объектов появляется только после прокрутки или приложению требуется разрешение пользователя, нельзя автоматически считать такой контент доступным поисковому роботу.
Например, Google прямо указывает, что при lazy loading важное содержимое не должно требовать от робота прокрутки или клика для загрузки.
Нужен ли SPA-сайту SSR
Не каждому SPA нужно срочно переписывать половину проекта ради трёх букв SSR.
Полезнее сначала разделить маршруты по бизнес-задаче.
| Тип страницы | Нужна видимость в поиске | Практичный подход |
|---|---|---|
| Услуги и посадочные | Да | SSR или статическая генерация |
| Категории каталога | Обычно да | SSR / SSG |
| Карточки товаров | Обычно да | SSR, SSG или другой устойчивый HTML-рендеринг |
| Статьи и справочные страницы | Да | Серверный или заранее сформированный HTML |
| Личный кабинет | Обычно нет | Client-side rendering допустим |
| Внутренняя CRM | Нет | SEO-рендеринг обычно не нужен |
| Конфигуратор после авторизации | Обычно нет | Решается исходя из продукта, а не SEO |
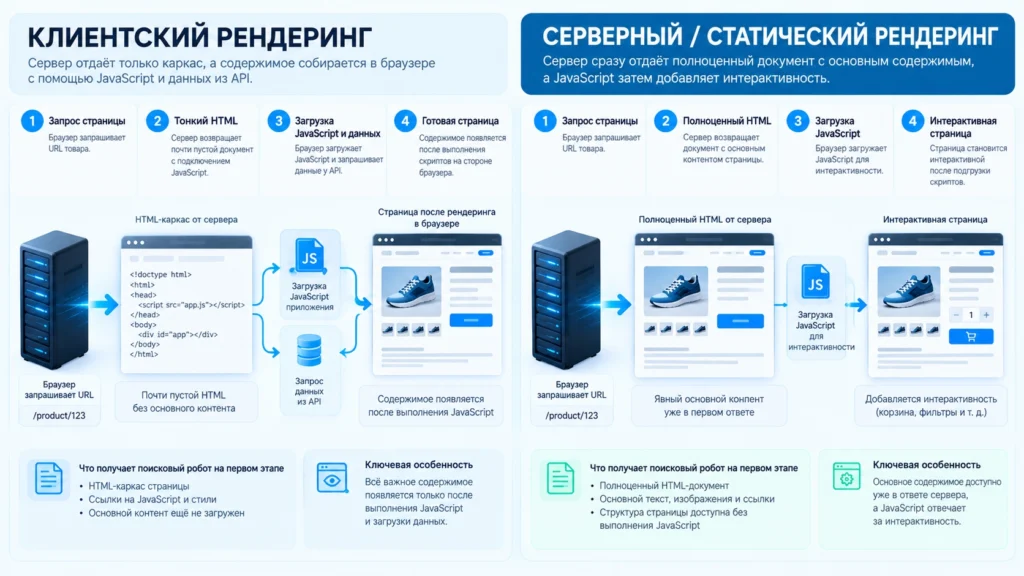
SSR — server-side rendering: сервер формирует содержимое страницы до отправки браузеру.
Статическая генерация делает похожую работу заранее — например, во время сборки проекта.
После получения HTML JavaScript может «оживить» страницу и вернуть ей привычную интерактивность. Пользователь продолжает работать с приложением, а робот не обязан начинать знакомство с пустого каркаса.
Google называет серверный и статический рендеринг хорошими решениями и отдельно подчёркивает, что dynamic rendering сегодня считается обходным, а не рекомендуемым долгосрочным вариантом.
Поэтому схема «узнаем Googlebot и генерируем специально для него другую страницу» не должна автоматически становиться архитектурой нового проекта. Тем более нельзя показывать роботам содержательно одну страницу, а посетителям другую.
Если технические ограничения индексации затрагивают большой каталог или важные коммерческие страницы, их имеет смысл исправлять как часть SEO-продвижения сайта, а не маскировать дополнительными текстами и ключевыми словами.
Как проверить SPA SEO, не превращаясь во frontend-разработчика
Владельцу бизнеса необязательно читать JavaScript-бандлы. Нужно проверить результат.
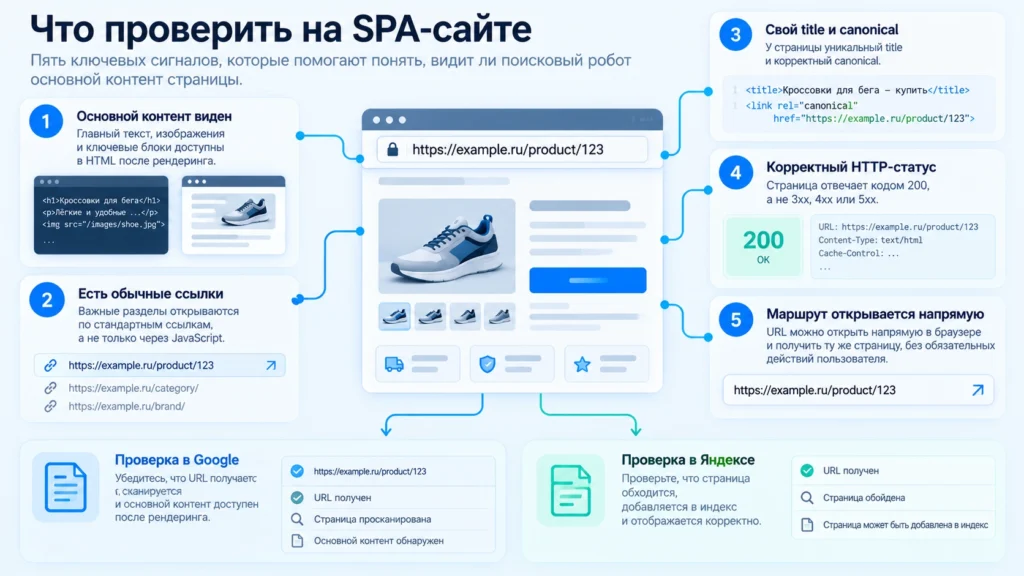
Для Google используйте проверку конкретного URL в Search Console и смотрите отрендеренную версию страницы. В ней должны присутствовать основной текст, заголовки и другие элементы, ради которых URL вообще существует.
Затем проверьте несколько вещей.
Каждый важный экран имеет отдельный адрес. Карточку товара можно открыть по прямой ссылке, отправить другому человеку и повторно загрузить.
Поисковику доступны обычные ссылки. Категории и товары не существуют только за кликами JavaScript.
Метаданные соответствуют маршруту. У карточки товара не должен оставаться заголовок главной страницы или canonical на /.
Ошибки отвечают ошибками. Несуществующий маршрут не должен бездумно возвращать 200 OK.
Важные JavaScript-ресурсы не заблокированы. Если робот не может получить код, необходимый для формирования страницы, ожидать корректного рендеринга странно.
В Яндексе есть дополнительный удобный уровень проверки: Вебмастер позволяет работать с рендерингом страниц JavaScript и оценивать содержимое с выполнением JS и без него. По умолчанию решение о выполнении JavaScript может оставаться на усмотрение робота.
Если же на сайте уже реализован полноценный SSR или пререндеринг, документация Яндекса отдельно предлагает рассмотреть отключение дополнительного JavaScript-рендеринга роботом, чтобы не создавать ненужную нагрузку.
Практический пример: интернет-магазин работает, а карточки почти не видны в поиске
Представим магазин мебели на React.
Главная индексируется. Категория открывается. Пользователи без проблем ходят по сайту. При этом большая часть карточек товара почти не появляется в поиске.
У разработчиков всё выглядит исправно: «В браузере же товар есть».
При проверке выясняется:
/product/divan-123/первоначально возвращает почти пустой каркас приложения;- название, описание и характеристики приходят из API;
- переходы между товарами реализованы JavaScript-обработчиками;
- удалённая карточка всё равно отвечает
200; - часть маршрутов отсутствует среди нормальных внутренних ссылок;
- canonical формируется только после выполнения клиентского кода.
Здесь бессмысленно начинать с увеличения текста карточки с 1500 до 3000 знаков. Если поисковая система нестабильно получает сам документ, ещё один абзац про «идеальное сочетание качества и цены» ситуацию не спасёт.
Команда переводит публичные категории и товары на серверный или статический рендеринг, оставляя интерактивную часть приложения. У каждого товара сохраняется самостоятельный адрес, навигация формирует обычные ссылки, метаданные относятся к текущему маршруту, удалённые товары получают корректную обработку.
После изменений первым критерием успеха будет не «через три дня позиции выросли».
Сначала нужно подтвердить технический результат: робот получает нужное содержимое, обнаруживает ссылки, видит согласованный canonical и отличает существующий URL от удалённого.
И только затем имеет смысл смотреть, какие страницы попали в индекс и как меняется поисковая видимость. Само индексирование и тем более SSR не гарантируют высоких позиций.
Общую диагностику краулинга и технических препятствий удобно продолжить по материалу «Краулинг: как поисковые роботы обходят сайт и что проверять».
Что в итоге важно владельцу сайта
SPA SEO — не спор между разработчиками о React, Vue и любимом способе рендеринга.
Для бизнеса вопрос проще: может ли каждая важная поисковая страница существовать как нормальный самостоятельный документ.
Если категория, услуга или товар имеют отдельный URL, доступны по обычным ссылкам, возвращают правильный HTTP-ответ, содержат ожидаемый контент и метаданные после обработки поисковиком — архитектура решает свою задачу.
Если же весь магазин фактически живёт внутри одного HTML-каркаса, маршруты существуют только после кликов, удалённые страницы отвечают 200, а поисковик должен каждый раз успешно собрать сайт из нескольких JavaScript-зависимостей, проблема уже не в «плохом SEO-тексте».
Сначала нужно сделать страницы технически доступными и понятными поиску. Уже после этого можно обсуждать семантику, контент, ссылки и позиции.
FAQ
Когда SPA действительно создаёт проблему для поиска
Нет. Сам формат SPA не является причиной плохих позиций. Проблемы начинаются, когда важный контент, ссылки или метаданные невозможно нормально получить и обработать по отдельным URL. Хорошо настроенное приложение может полноценно участвовать в поиске.
Да. Google использует Web Rendering Service и выполняет JavaScript, однако сам Google предупреждает о различиях и ограничениях такого процесса. Поэтому для важных поисковых страниц серверный или статический HTML остаётся более надёжной архитектурой, особенно если приложение зависит от сложной цепочки API и скриптов.
Нет. Сначала нужно определить, какие маршруты вообще должны получать поисковый трафик. Публичные услуги, категории, товары и статьи имеет смысл отдавать поисковикам в устойчивом HTML-виде, а личный кабинет, внутренние панели и служебные экраны обычно не требуют поисковой индексации.
В Яндекс Вебмастере можно проверить страницу и посмотреть, какое содержимое доступно поисковому роботу. Отдельный инструмент рендеринга JavaScript позволяет сравнивать работу страницы с выполнением JavaScript и без него и управлять рендерингом для сайта.
Проверяйте не позиции на следующий день, а технический результат: нужный URL доступен отдельно, основной контент присутствует после обработки страницы, ссылки обнаруживаются, canonical и метаданные относятся к текущему маршруту, а удалённые страницы возвращают корректный статус. После этого уже отдельно оценивается индексация и поисковая видимость.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.