Краулинг — это не синоним индексации и тем более не показатель позиций. Сначала поисковой системе нужно узнать о существовании URL, затем получить его содержимое, а уже после этого обработать страницу и решить, подходит ли она для индекса. Google прямо разделяет поиск на стадии crawling, indexing и serving: успешный обход является лишь одной частью этого процесса.
Из-за этого вопрос «почему страницы нет в поиске?» нельзя начинать только с метатегов или качества текста. Сначала нужно установить более простой факт: знает ли поисковик URL, приходил ли к нему робот и какой ответ получил.
Краулинг начинается ещё до запроса страницы
У робота нет готового списка всех страниц интернета. Новые URL он обнаруживает через уже известные ссылки, Sitemap, редиректы и другие доступные источники. Google указывает внутренние ссылки и Sitemap среди основных способов обнаружения новых страниц.
Поэтому технически исправная страница может оставаться почти невидимой для краулера, если до неё нельзя нормально добраться из структуры сайта. Типичный пример — новая статья существует, возвращает 200 OK, разрешена в robots.txt, но ни одна индексируемая страница на неё не ссылается и в Sitemap её тоже нет.
Для аудита эту цепочку полезно разделять. сканирование сайта помогает увидеть структуру URL со стороны технического обхода, а данные поисковой системы показывают уже реальное поведение её собственного робота.
После обнаружения адреса поисковик решает, когда и нужно ли его запрашивать. Googlebot не обязан посещать каждый известный URL и самостоятельно регулирует интенсивность запросов, в том числе с учётом реакции сервера. Серверные проблемы и ошибки 5xx могут привести к снижению интенсивности обхода.
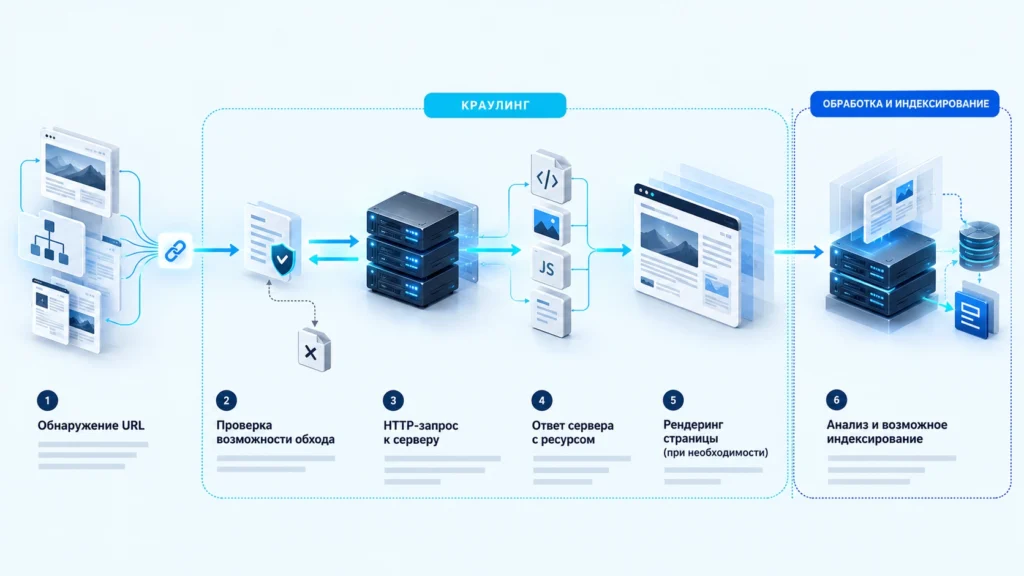
Где робот может потерять важную страницу
Проблему удобно искать не по одному признаку, а по всей цепочке доступа.
| Точка проверки | Что может пойти не так | Что это означает |
|---|---|---|
| Обнаружение URL | нет внутренних ссылок, адрес отсутствует в Sitemap | робот может редко находить страницу или не знать о ней |
robots.txt | нужный раздел закрыт Disallow | робот не может нормально получить содержимое |
| HTTP-ответ | 404, 5xx, цикл или длинная цепочка редиректов | ресурс не получен либо обход расходуется на промежуточные URL |
| Рендеринг | важный контент появляется только после проблемного JavaScript | робот может получить не тот результат, который видит пользователь |
| URL-инвентарь | фильтры и параметры создают тысячи вариантов | робот тратит запросы на второстепенные адреса |
| Сигналы индексирования | noindex, дубли, выбран другой canonical | URL мог быть обойдён, но в индекс как самостоятельная страница не попасть |
Особенно важно не путать robots.txt и noindex. Для Google robots.txt управляет доступом краулера, но не является надёжным способом удалить HTML-страницу из поиска. При этом правило noindex должно быть доступно роботу: если URL одновременно закрыт через robots.txt, Googlebot не сможет прочитать noindex на самой странице.
Именно поэтому комбинация «закрыли URL в robots.txt и поставили noindex для надёжности» может работать не так, как ожидает владелец сайта.
Как проверить реальный краулинг, а не гадать по позициям
Для одного URL полезнее всего начинать с ответа сервера и информации конкретной поисковой системы.
В Google Search Console инструмент проверки URL показывает дату последнего обхода, возможность crawling, результат получения страницы и разрешение на индексирование. Live Test позволяет отдельно проверить текущую версию URL, поэтому его результат не следует путать с данными о версии, которую Google видел раньше.
Для анализа сайта целиком есть Crawl Stats. Отчёт показывает количество запросов Google, ответы сервера, среднее время ответа, состояние хоста, типы файлов и тип Googlebot. При этом список примеров URL в отчёте не является полным перечнем всех запросов.
В Яндекс Вебмастере раздел «Статистика обхода» позволяет увидеть дату посещения URL и HTTP-код, который получил робот. Для конкретного адреса «Проверка страницы» показывает ответ сервера и содержимое, доступное роботу.
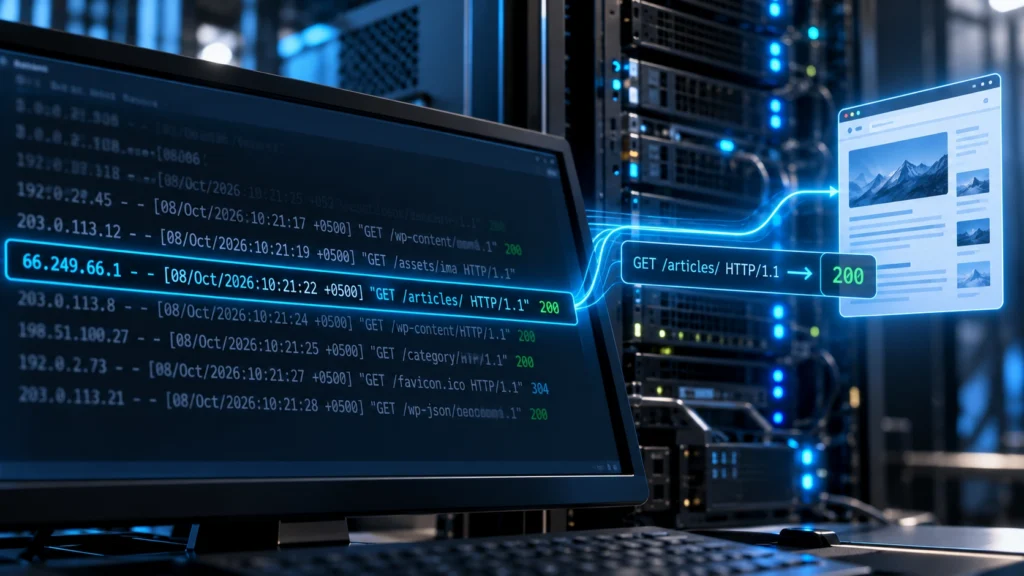
Разбор yandexbot на практике особенно полезно дополнять серверными логами: они дают независимое подтверждение того, что запрос действительно дошёл до вашего сервера.
Пример записи access log может выглядеть так:
66.249.xx.xx - - [08/Oct/2026:12:14:07 +0300]
"GET /articles/example/ HTTP/2.0" 200 48321
"Mozilla/5.0 ... Googlebot/2.1 ..."
Здесь важны не цифры сами по себе, а четыре признака: какой URL запросили, когда это произошло, какой HTTP-код получил робот и кто указан в User-Agent. Для серьёзной диагностики одного User-Agent недостаточно — принадлежность подозрительного бота лучше дополнительно проверять по официальным способам поисковой системы.
Crawl budget нужен не каждому сайту
Краулинговый бюджет — это объём URL, которые поисковая система может и хочет обходить на конкретном сайте. В актуальной документации Google он связан с двумя сторонами: доступной crawl capacity и фактическим crawl demand.
Но превращать crawl budget в обязательную SEO-метрику для любого сайта не стоит. Google адресует расширенные рекомендации прежде всего проектам примерно от миллиона уникальных URL с регулярными изменениями, сайтам от примерно 10 000 URL при очень частом обновлении и проектам с заметным количеством страниц в состоянии «Discovered — currently not indexed». Google отдельно подчёркивает, что эти числа приблизительные, а не жёсткие пороги.
Для сайта на несколько сотен или тысяч нормальных страниц обычно важнее другое: чтобы полезные URL были доступны, быстро отвечали, имели внутренние ссылки, присутствовали в актуальном Sitemap, а технические дубли не раздували пространство обхода.
Что исправлять, если робот ходит не туда
Начинать стоит не с попытки «заставить поисковик обходить быстрее», а с инвентаря URL.
Если каталог создаёт тысячи комбинаций вроде:
/catalog/?color=black
/catalog/?color=black&sort=price
/catalog/?sort=price&color=black
/catalog/?page=1&sort=price&color=black
нужно определить, какие комбинации действительно должны существовать как самостоятельные поисковые страницы. Остальные адреса желательно не генерировать без необходимости, не подмешивать массово во внутреннюю перелинковку и не включать в Sitemap.
Дальше проверяются цепочки редиректов, 404 и 5xx, доступность robots.txt, скорость ответа сервера и реальная структура внутренних ссылок. Google рекомендует сокращать ненужный URL-инвентарь и длинные цепочки редиректов, а Яндекс при повышенной нагрузке также советует анализировать логи и искать технические страницы и URL с GET-параметрами.
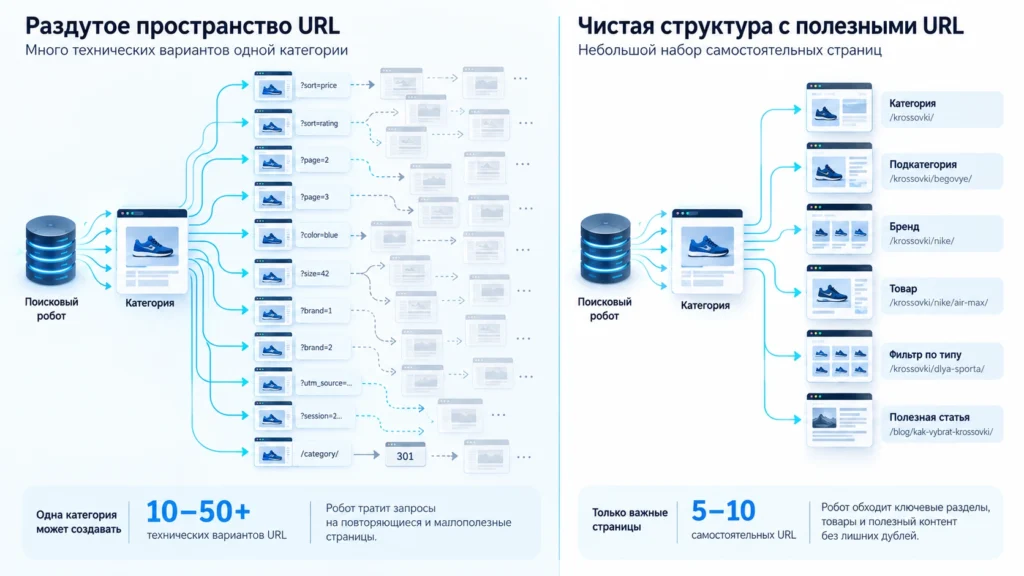
Практический сценарий: робот обходит тысячи страниц, а важные обновляются редко
Представим интернет-магазин с 5 000 товарных и категорийных страниц. Из-за фильтров, сортировок и параметров аналитики сервер фактически отдаёт десятки тысяч доступных URL.
В статистике обхода видно множество обращений к параметрическим адресам. В логах картина подтверждается: робот регулярно запрашивает комбинации фильтров, тогда как часть важных категорий переобходится заметно реже.
Ошибка в такой ситуации — сразу ограничивать общую скорость робота. Сначала нужно выяснить источник лишних URL: ссылки в шаблоне, фильтры, параметры, Sitemap или старые редиректы. Затем убрать ненужную генерацию и внутренние ссылки, проверить канонические версии, очистить Sitemap и только для тех адресов, которые вообще не должны обходиться, применять соответствующие ограничения.
После изменений критерий результата — не мгновенный рост позиций. Нужно увидеть, что робот перестал массово запрашивать бесполезные варианты, основные URL продолжают отвечать корректно, а важные разделы остаются доступными для обнаружения и повторного обхода.
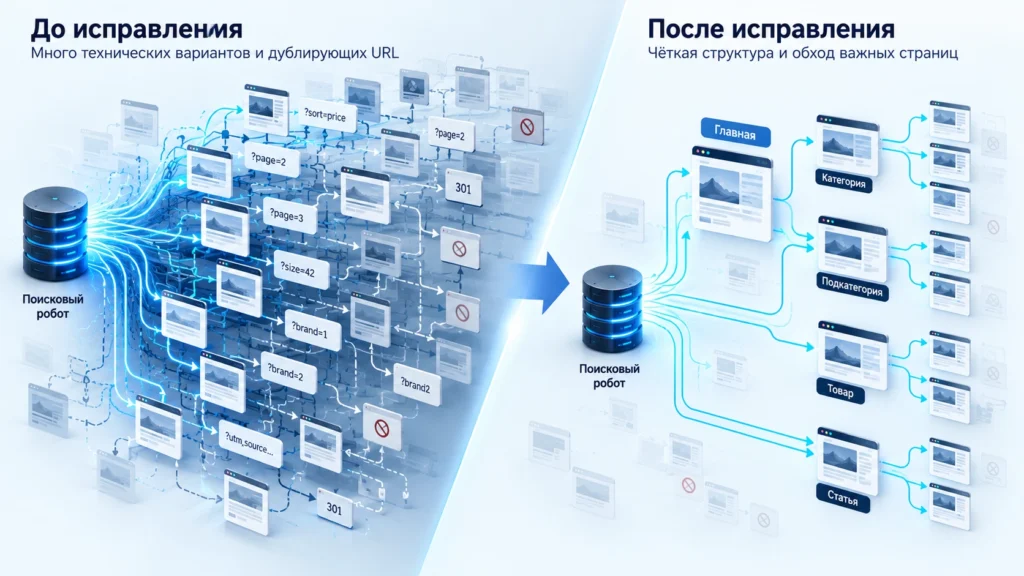
Что считать нормальным результатом проверки
Хороший технический результат выглядит довольно прозаично: поисковик способен обнаружить важные URL, robots.txt не блокирует их случайно, сервер стабильно отдаёт ожидаемый код, редиректы не образуют лишних цепочек, а Sitemap содержит канонические страницы, которые действительно должны участвовать в поиске.
При этом обход страницы ещё не гарантирует её индексирование. Яндекс отдельно предупреждает, что страница может быть посещена роботом, но отсутствовать в поиске; Google также рассматривает crawling и indexing как разные стадии.
Поэтому диагностику стоит завершать двумя отдельными вопросами: «может ли робот нормально получить нужную страницу?» и «что произошло с ней после получения?». Такое разделение быстро отсеивает ложные гипотезы и показывает, где действительно находится техническая проблема.
FAQ
Где заканчивается проблема краулинга и начинается проблема индексации
Это обход сайта поисковым роботом. Робот узнаёт об URL, запрашивает его у сервера и получает страницу или другой ресурс. После этого поисковая система уже отдельно решает, как обработать полученные данные и стоит ли включать страницу в индекс.
Само увеличение числа обходов не является гарантией роста позиций. Но если важная страница недоступна роботу или долго не переобходится, поисковая система не сможет нормально обработать её актуальную версию. Поэтому краулинг — необходимая техническая стадия, а не самостоятельный способ повысить ранжирование.
Проверяйте дату и результат последнего обхода в инструментах поисковой системы и подтверждайте данные серверными логами. В логах можно увидеть URL, время запроса, HTTP-код и User-Agent. Для важной страницы полезно также проверить её текущую доступность отдельным тестом URL.
Обычно это не первая задача. Google прямо относит детальную работу с crawl budget прежде всего к крупным, быстро обновляемым сайтам и проектам с большим количеством обнаруженных, но не проиндексированных URL. Для обычного сайта важнее исправить дубли, ошибки сервера, лишние параметры, внутреннюю навигацию и Sitemap.
Сначала определите, откуда эти адреса появляются: фильтры, GET-параметры, календарные страницы, внутренние ссылки, старые редиректы или Sitemap. После этого устраните источник лишних URL, корректно настройте каноникализацию и правила обхода там, где они действительно нужны. Результат проверяйте повторно по статистике обхода и логам.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.