Представим, что у Googlebot есть кошелёк. Утром поисковик кладёт туда условные 10 000 рублей и отправляет робота гулять по вашему сайту. Один рубль он тратит на карточку товара, ещё один — на категорию, потом случайно заходит в фильтр «белые холодильники Bosch шириной до 60 см», оттуда проваливается в сортировку по цене, затем во внутренний поиск и ещё несколько тысяч комбинаций параметров. К вечеру деньги заканчиваются, робот закрывает ноутбук и возвращается завтра.
Удобная картинка. Именно поэтому термин crawl budget, или краулинговый бюджет, так легко прижился в SEO.
Проблема только одна: в реальности никакого такого кошелька нет.
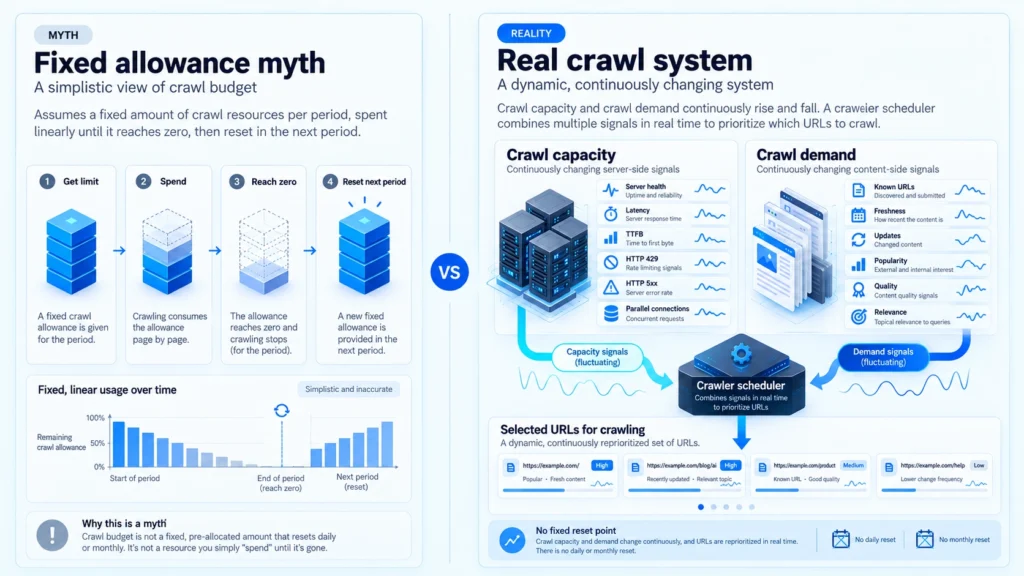
Google не назначает сайту фиксированные 10 000 страниц на сутки. Бюджет не обнуляется в полночь, остаток не переносится на следующий месяц, а закрытие тысячи ненужных URL не означает, что поисковик тут же потратит освободившиеся тысячу запросов на нужные страницы.
У Google модель значительно сложнее. А Яндекс вообще описывает обход сайта другой терминологией.
Тем не менее сама идея ограниченности ресурсов совершенно правильная. Интернет практически бесконечен, вычислительные мощности поисковых систем — нет. Сервер вашего сайта тоже способен обработать конечное количество запросов. Поэтому поисковикам всё время приходится решать две задачи: сколько страниц они могут получить, не перегрузив сайт, и какие страницы вообще имеет смысл получать сейчас.
Вот это и есть хорошая отправная точка для разговора о crawl budget.
Что поисковый робот вообще делает с сайтом
Прежде чем считать какие-либо «бюджеты», важно разделить сканирование и индексирование.
Поисковый робот сначала должен узнать, что URL существует. Адрес может быть найден во внутренней ссылке, Sitemap, на другом сайте или через другие известные поисковой системе сигналы. Затем робот запрашивает URL у сервера, получает HTTP-ответ и содержимое документа. При необходимости страница обрабатывается и рендерится. И только потом поисковая система решает, стоит ли вообще сохранять этот документ в индексе.
Подробно сам процесс я разбирал отдельно в материале «Сканирование сайта: как поисковые роботы обходят URL и где искать проблемы».
Главное здесь — не перепутать два события:
страница была просканирована и страница была проиндексирована — не одно и то же.
Google прямо указывает, что далеко не каждая просканированная страница попадает в индекс: после обхода документ ещё должен быть обработан, а затем поисковая система решает, имеет ли смысл включать его в поиск.
Поэтому утверждение «Google выделяет мне бюджет на индексирование 500 страниц в день» технически неверно уже в самой формулировке. Робот расходует ресурсы на обход, а не покупает вашему URL место в поисковой базе.
Откуда вообще взялся термин crawl budget
Термин появился не потому, что внутри Google существует таблица вида:
| Сайт | Лимит |
|---|---|
| site-a.ru | 500 страниц в день |
| site-b.ru | 3 000 страниц в день |
| site-c.ru | 50 000 страниц в день |
Публичная модель Google устроена иначе: есть ресурсы, которые Googlebot может использовать для сайта, и есть желание поисковой системы конкретные URL обойти.
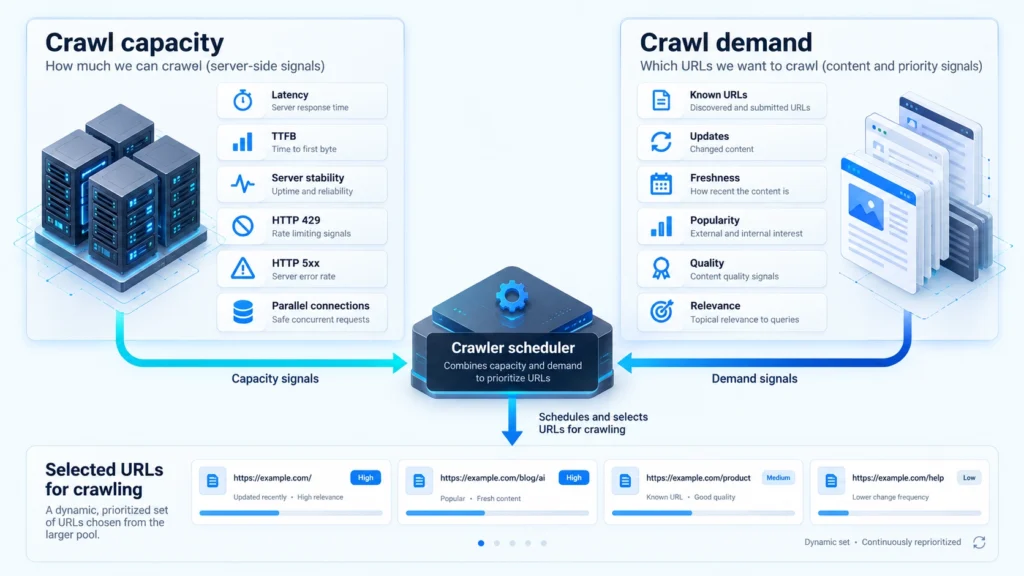
Сегодня Google описывает crawl budget через две основные составляющие:
crawl capacity limit — сколько ресурсов Google технически может потратить на обход сайта;
crawl demand — насколько Google сейчас заинтересован в обходе известных ему URL.
Если перевести это с инженерного языка на бытовой, становится значительно понятнее.
Допустим, вы пришли в кафе. У кухни есть ограниченная производительность: она физически может приготовить только определённое количество блюд в час. Это capacity.
Но даже если кухня способна приготовить 300 блюд, никто не станет готовить их просто потому, что мощности свободны. Нужны заказы от посетителей. Это demand.
Так же и с обходом сайта. Сервер может выдерживать огромную нагрузку, но если поисковая система не видит необходимости повторно запрашивать ещё 50 000 URL, свободная техническая возможность сама по себе не создаст дополнительный crawl.
Crawl capacity limit: сколько сайт и Google способны переварить
Google не хочет положить ваш сервер только потому, что решил обновить поисковый индекс. Поэтому интенсивность обхода автоматически ограничивается.
Если сайт стабильно отвечает быстро, доступная ёмкость может расти. Если сервер замедляется, растёт время ответа или появляются систематические 5xx и 429, поисковая система может снизить интенсивность обращений.
Это важное отличие от популярного совета:
Добейтесь PageSpeed 100 — и получите больше crawl budget.
Такой прямой формулы нет.
Для обхода важнее реальная способность инфраструктуры обслуживать запросы: стабильность сервера, задержки, backend, база данных и отсутствие систематических ошибок.
Например, интернет-магазин может выглядеть быстрым для посетителя благодаря кешу и CDN, но каждая страница фильтра при запросе поискового робота вызывает тяжёлый SQL-запрос и генерируется две секунды. Внешне сайт красивый и современный, а с точки зрения краулера кухня работает так, будто один повар одновременно принимает заказы, чистит картошку и отвечает по телефону.
Что происходит при 429 и 5xx
Код:
429 Too Many Requestsбуквально сообщает, что сервер не хочет принимать запросы с такой интенсивностью.
При длительных проблемах с доступностью поисковой системе логично уменьшать нагрузку на хост, а не продолжать увеличивать её.
Похожая ситуация возникает с 5xx.
Если поисковый робот регулярно получает:
500 Internal Server Error
503 Service Unavailable
вместо нормального документа, сервер сам сообщает, что в данный момент обслуживать такой объём запросов не может.
Поэтому ответ на вопрос «может ли плохой сервер уменьшить crawl capacity?» — да.
Но обратное утверждение уже неверно:
мощный сервер автоматически заставит поисковик обходить больше страниц.
Для этого нужна вторая половина системы.
Crawl demand: зачем поисковику снова заходить на страницу
Представим старую страницу контактов небольшой компании. Телефон не менялся пять лет, адрес тот же, текст тот же.
Рядом опубликована новостная страница, где информация обновляется несколько раз в день.
Было бы довольно расточительно проверять обе каждые пятнадцать минут.
На спрос на повторный обход влияют свойства самого набора URL: насколько страницы известны поисковику, как часто они меняются, насколько востребованы и насколько вообще есть причина возвращаться к документу.
Поэтому URL посещаются с разной частотой.
Главная страница крупного новостного проекта может обновляться постоянно.
Карточка популярного товара меняет цену и наличие.
Старая статья может не меняться год.
Удалённый URL после нескольких проверок постепенно становится менее интересным.
Именно поэтому бессмысленно спрашивать:
Как сделать так, чтобы Googlebot заходил на каждую страницу каждый день?
В большинстве случаев правильный встречный вопрос звучит иначе:
А зачем поисковику ежедневно скачивать документ, который не меняется месяцами?
Так сколько же страниц составляет crawl budget
Универсальной цифры нет.
Даже если технический лимит сервера не достигнут, при низком crawl demand поисковик не обязан продолжать запрашивать страницы просто ради использования доступной мощности.
То есть фактические 20 000 запросов Googlebot за вчера — это не доказательство, что:
crawl budget сайта = 20 000.
Это только факт:
вчера Google выполнил около 20 000 запросов.
Сегодня их может быть 8 000, завтра — 35 000. Часть запросов придётся на HTML, часть — на ресурсы, часть — на редиректы или другие типы URL.
И даже свободный ресурс не обязан быть использован полностью.
Здесь аналогия с кошельком окончательно ломается. Если вам выдали банковскую карту с лимитом 100 000 ₽, лимит существует независимо от того, собираетесь вы что-нибудь покупать или нет.
В crawling отдельного фиксированного остатка, который можно открыть в Search Console и посмотреть как баланс счёта, нет.
Обнуляется ли crawl budget каждый день или месяц
Нет.
Никакого расчётного дня, последнего числа месяца или момента, когда Google говорит:
Поздравляем, ваш пакет сканирования снова пополнен.
в этой модели нет.
Capacity и demand постоянно меняются.
Сегодня сервер отвечает быстро.
Завтра база перегружена.
Сегодня опубликовано 30 000 новых товаров.
Через месяц каталог почти не меняется.
Сегодня поисковик обнаружил большой переезд раздела.
Через несколько дней основные URL уже обработаны.
Поэтому crawl activity постоянно адаптируется к текущей ситуации.
Термин «бюджет» здесь обозначает ограниченность ресурсов, а не бухгалтерский период.
А что происходит у Яндекса
С Яндексом полезно не пытаться механически переносить терминологию Google.
В Яндекс Вебмастере используется отдельное понятие скорости обхода. Это количество запросов в секунду, которое робот отправляет сайту.
По умолчанию работает автоматическая оптимизация: Яндекс рассчитывает скорость так, чтобы получить максимальное количество страниц без чрезмерной нагрузки на сервер. Пользователь может задать значение вручную, но сам Яндекс предупреждает, что это лишь рекомендуемая скорость, а фактическая может отличаться.
То есть если поставить ползунок на максимум, YandexBot не превращается в обязательного курьера, которому приказали забирать по сто страниц в секунду.
Яндекс отдельно советует перед изменением скорости выяснить, какие страницы робот запрашивает чаще, посмотреть Crawl statistics и серверные логи и проверить, нет ли среди запросов служебных страниц или дублей с GET-параметрами.
И это, пожалуй, самый полезный совет во всей истории с crawl budget:
не пытайтесь сначала сделать робота быстрее. Сначала выясните, куда он уже бегает.
Сайт на 80 страниц и магазин на 500 000 URL — две разные реальности
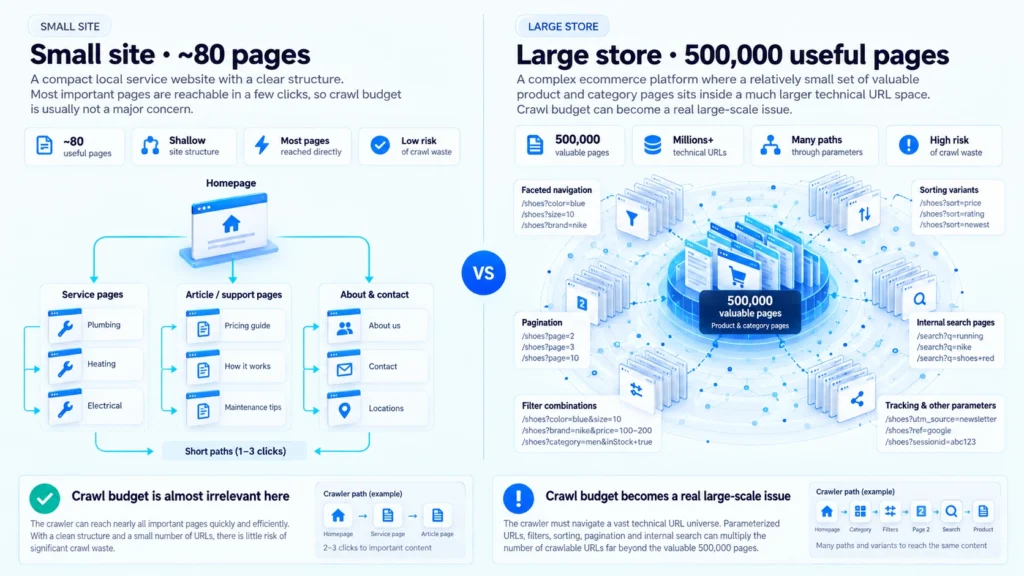
Возьмём небольшой сайт электрика.
На нём есть главная страница, контакты, около 30 услуг, несколько страниц районов и 40 статей. Всего получилось 80–100 полезных URL.
Структура нормальная. На услуги ведут ссылки из меню и тематических материалов. Карта сайта актуальная. Сервер стабильно отвечает. Новые публикации постепенно обнаруживаются.
И вот владелец читает SEO-блог и узнаёт, что ему срочно надо «оптимизировать краулинговый бюджет».
В большинстве случаев ему стоит закрыть эту статью и заняться чем-нибудь полезнее.
Теперь возьмём интернет-магазин.
У него 500 000 реальных товаров и категорий. Уже немало.
Но покупатель может выбрать:
- бренд;
- цвет;
- ширину;
- высоту;
- цену;
- тип компрессора;
- класс энергопотребления;
- наличие;
- сортировку;
- страницу пагинации.
Допустим, базовая категория холодильников выглядит так:
/holodilniki/Фильтр добавляет:
?brand=boschСледующий:
?brand=bosch&color=whiteСортировка:
?brand=bosch&color=white&sort=priceПотом пагинация:
?brand=bosch&color=white&sort=price&page=2Количество реальных товаров осталось тем же. Но пространство потенциальных URL начинает расти комбинаторно.
Если ещё добавить параметры аналитики, идентификаторы сессий, внутренний поиск и альтернативные способы сортировки, полмиллиона полезных URL легко оказываются окружены миллионами технических вариантов.
Вот здесь разговор о crawl budget перестаёт быть теоретическим.
Google отдельно относит фасетную навигацию, сортировки, фильтры и календарные структуры к типичным источникам резкого роста числа URL и crawl-нагрузки.
Куда на больших сайтах действительно уходит обход
Проблема крупного проекта обычно не выглядит как «Google дал мало денег».
Она выглядит как плохо управляемый инвентарь URL.
Фильтры и фасетная навигация
Интернет-магазину фильтры нужны пользователю. Это не делает автоматически каждый результат фильтра полезной посадочной страницей для поиска.
Например:
/divany/?color=beigeможет быть нормальной поисковой страницей, если люди действительно ищут бежевые диваны, она содержит подходящий ассортимент, уникальные элементы и встроена в SEO-структуру.
А комбинация:
/divany/?color=beige&sort=rating&items=96&view=gridможет описывать практически тот же набор товаров, только в другом порядке.
Для человека обе страницы функциональны. Для поисковой системы второй URL может оказаться просто ещё одной вариацией того же документа.
GET-параметры
Особенно неприятны параметры, которые вообще не меняют основной контент:
?utm_source=telegram
?session_id=123
?ref=partner
Если такие варианты размножаются и становятся доступными по ссылкам, поисковик получает большой набор разных адресов, ведущих фактически к одному содержимому.
Внутренний поиск
Представьте, что сайт позволяет сформировать поисковую страницу практически по любой строке:
/search/?q=iphone
/search/?q=iphone+15
/search/?q=iphone+15+black
Если каждая такая комбинация доступна роботу через ссылки, получается ещё один потенциально почти бесконечный генератор URL.
Календарные страницы
Особенно неприятны механизмы, которые позволяют роботам уходить далеко в будущее или прошлое:
/events/2035/06/
/events/2035/07/
/events/2035/08/
Человеку такой маршрут обычно не нужен. Краулер, видящий стабильную ссылочную цепочку «следующий месяц», способен идти значительно дальше, чем разработчик предполагал.
Дубли
Одна страница может существовать в нескольких вариантах:
/product/123/
/product/123/?sort=popular
/product/123/?utm_source=mail
/catalog/product/123/
/product/123/index.php
Само наличие дублей не означает автоматическую санкцию. Но на крупном сайте обслуживание тысяч или миллионов подобных вариантов действительно расходует вычислительные ресурсы.
Почему canonical не является шлагбаумом для робота
На этом месте часто появляется простое решение:
Поставим canonical — и Google перестанет ходить по фильтрам.
Не совсем.
rel="canonical" помогает поисковой системе понять, какую версию среди похожих URL владелец считает основной. Но canonical является сигналом о предпочтительной версии документа, а не запретом на HTTP-запрос.
Чтобы увидеть canonical, робот обычно сначала должен получить сам документ.
Поэтому canonical решает задачу консолидации версий, а не превращается в невидимый бетонный забор вокруг страницы.
robots.txt: можно ли просто всё закрыть
robots.txt уже действительно управляет доступом роботов к URL. Подробно директивы и типичные ошибки я разбирал в статье «Robots.txt для SEO: директивы, настройка и частые ошибки».
Если поисковому роботу вообще не нужно запрашивать определённые технические пространства, закрытие обхода может быть оправдано.
Но здесь есть важный нюанс.
Допустим, робот раньше тратил 50 000 запросов на мусорные фильтры. Вы закрыли их в robots.txt.
Возникает соблазн записать:
значит завтра получим дополнительные 50 000 запросов к карточкам товаров.
Так это не работает.
Вы уменьшили бессмысленную работу робота, но не купили у Google пакет из дополнительных 50 000 обязательных запросов.
Если к остальным документам нет достаточного crawl demand, дополнительный объём обхода просто не обязан появляться.
Почему noindex не экономит сам запрос
Ещё одна распространённая конструкция:
<meta name="robots" content="noindex">Она сообщает поддерживающему это правило поисковику, что страницу не нужно включать в индекс.
Но возникает простой технический вопрос:
как робот узнает, что на странице стоит noindex?
Он должен её получить.
Поэтому noindex — хороший инструмент управления индексацией, но не средство запретить сам HTTP-запрос.
Это одна из причин, почему в crawl budget нельзя смешивать сканирование, индексирование, canonical и robots.txt в одну большую кнопку «не показывать страницу Google».
Sitemap помогает, но ничего не приказывает
У больших сайтов ещё одна любимая крайность:
Если URL есть в Sitemap, Google обязан его обойти.
Нет.
Sitemap сообщает поисковой системе, какие URL существуют и какие владелец сайта хочет сделать удобнее для обнаружения. Особенно полезна карта для крупных, новых или сложных проектов.
Но Sitemap не является приказом:
просканировать этот URL сегодня и обязательно поместить его в индекс.
Корректный Sitemap.xml нужен, но превращать его в список обязательных команд Googlebot не стоит.
Для часто обновляемого сайта особенно полезно корректное поле <lastmod>. Но оно должно отражать реальное существенное изменение страницы, а не сегодняшнюю дату только потому, что Sitemap заново сгенерировал cron.
Если каждую ночь сообщать поисковику, что все 500 000 товаров только что изменились, хотя содержимое осталось прежним, вы не помогаете системе приоритизации. Вы просто делаете собственный сигнал менее информативным.
Внутренняя перелинковка — самый недооценённый маршрут робота
Поисковик не обязан строить карту сайта по нашим мыслям. Ему нужны реальные связи между документами.
Если новая статья существует, находится в Sitemap, но ни одна нормальная страница сайта на неё не ссылается, технически URL может быть известен. Но архитектурно вы сами сообщаете, что документ почти никак не связан с остальным проектом.
Нормальные HTML-ссылки решают сразу несколько задач: помогают обнаруживать URL, показывают структуру сайта и дают пользователю реальный путь к следующему материалу.
Поэтому работа с crawl efficiency начинается не с экзотических серверных настроек, а часто с гораздо более скучного вопроса:
Может ли робот вообще дойти до нужной страницы по нормальной структуре внутренних ссылок?
Скучно, зато работает.
Что происходит с 404 и 410
Страх перед 404 породил огромное количество странных сайтов.
Товар удалён — редиректим на категорию.
Статья удалена — отправляем на главную.
URL был опечаткой — тоже на главную.
Получается поисковый аналог здания, где любую неверную дверь посетителю открывает охранник и молча отправляет его на центральный вход.
Если документ реально удалён и релевантной замены нет, нормальный 404 Not Found является корректным техническим ответом.
Если ресурс удалён намеренно и навсегда, можно использовать 410 Gone.
Подробно логику выбора я разбирал в материале «404 ошибка: как правильно настроить страницу и не навредить SEO».
Важно другое: 404 — это не автоматически «потраченный впустую бюджет».
Интернет постоянно меняется. Страницы удаляются. Ссылки устаревают. Робот обязан иногда проверить известный URL, чтобы понять его состояние.
Проблема появляется, когда сайт сам генерирует миллионы заведомо бесполезных несуществующих адресов или продолжает активно ссылаться на уже удалённые страницы.
Soft 404 хуже нормального 404
Гораздо интереснее ситуация, когда страница выглядит как ошибка:
Товар не найден.
Но сервер отвечает:
HTTP/1.1 200 OKДля HTTP всё прекрасно. Документ существует.
Для пользователя товара нет.
Для поисковой системы приходится отдельно разбираться, что это за странная страница.
Такой случай называют soft 404.
Если содержимого действительно больше нет, серверу лучше честно сообщить об этом корректным HTTP-статусом.
Иногда честная ошибка полезнее страницы, которая улыбается посетителю и врёт протоколу HTTP.
Длинные цепочки редиректов тоже стоят запросов
Допустим, старый адрес ведёт так:
/old-product/
↓
/catalog-old/product/
↓
/catalog/product/
↓
/products/product-name/
Для пользователя переход может произойти почти незаметно.
Но для поискового робота это несколько отдельных HTTP-запросов.
Один подобный маршрут не разрушит SEO.
Десятки тысяч системных цепочек после нескольких переездов уже превращаются в архитектурный долг.
Если известна конечная релевантная страница, обычно разумнее сразу отправлять старый URL туда.
Можно ли реально «потратить весь crawl budget»
Если под этим подразумевать:
сегодня Google использовал ровно 100% фиксированной месячной квоты и больше не придёт до первого числа,
то нет.
Но есть более полезная интерпретация.
Большой сайт способен создать настолько много малоценных и технических URL, что значительная часть доступного времени и серверных ресурсов будет уходить на них. В результате новые или важные документы могут обнаруживаться и обновляться медленнее.
То есть «потратить бюджет» можно не как деньги на банковской карте, а как занять ограниченное внимание системы бесполезной работой.
Представьте склад, где у вас работает десять комплектовщиков.
На складе нет правила:
сегодня можно сделать только 10 000 шагов.
Но если половину смены сотрудники ищут коробки, которых не существует, перекладывают один и тот же товар между полками и три раза проходят через промежуточные помещения, полезная производительность всё равно падает.
Никто не «потратил лимит ходьбы». Просто процессы устроены плохо.
С crawl budget происходит примерно то же.
Почему малому сайту чаще нужно искать другую проблему
Вернёмся к сайту электрика на 80 страниц.
Владелец видит:
- мало показов;
- мало страниц в индексе;
- новые статьи почти не получают трафика.
И делает вывод:
Google не хватает crawl budget.
На таком масштабе значительно вероятнее другие причины:
- поисковик ещё не обнаружил часть URL;
- внутренние ссылки слабые;
- страницы слишком похожи;
- canonical указывает не туда;
- есть
noindex; - robots.txt закрывает раздел;
- сервер возвращает неправильный статус;
- материал просканирован, но не выбран для индексации;
- спрос по теме очень низкий;
- страница проиндексирована, но не имеет достаточной видимости.
Именно поэтому проблема «почему страницу не видно в поиске» должна диагностироваться отдельно. Более подробно это разобрано в статье «Почему сайт не индексируется в Google и Яндексе».
Crawl — только один этап цепочки.
Если сантехник приехал в квартиру, это ещё не означает, что кран починен. Но если сантехник вообще не знает адреса, обсуждать качество ремонта действительно рано.
Как понять, достаточно ли Google обходит сайт
Не нужно искать мифическое поле:
Ваш crawl budget: 18 342 страницы.
Нужно смотреть реальные данные.
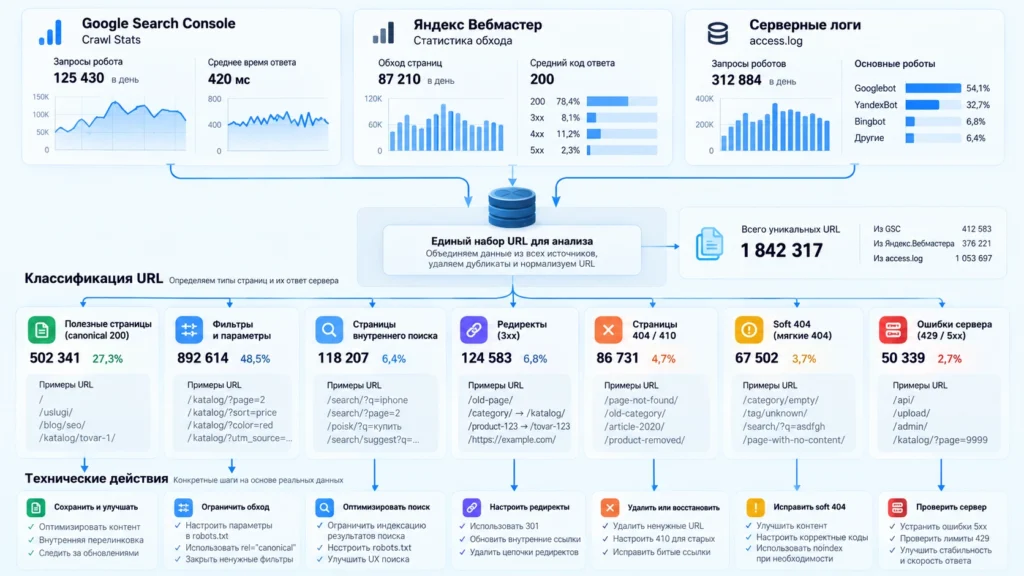
Crawl Stats в Google Search Console
Там можно анализировать:
- количество запросов;
- объём загруженных данных;
- среднее время ответа;
- состояние хоста;
- HTTP-коды;
- типы запросов;
- назначение обхода.
Но число Total crawl requests — это история фактических запросов, а не размер выданного лимита.
Яндекс Вебмастер
В разделе:
Индексирование → Статистика обхода
можно посмотреть страницы, которые YandexBot действительно посещал, и ответы сервера. Яндекс также показывает URL, которые робот не смог получить из-за проблем сервера или самого документа.
На крупном сайте полезно смотреть не только общий график, а конкретные URL.
Если в списке постоянно встречаются:
?sort=
?session=
?view=
?utm_
/search/
это значительно полезнее абстрактного спора, хороший у вас crawl budget или плохой.
Серверные логи показывают то, чего не видно в интерфейсах
Для серьёзной диагностики крупных сайтов я бы вообще не ограничивался Search Console и Вебмастером.
У веб-сервера есть access.log.
Например, одна запись может выглядеть примерно так:
66.249.xxx.xxx - - [15/Oct/2026:10:21:31 +0300]
"GET /catalog/fridges/?brand=bosch HTTP/1.1"
200 48231
Из таких записей можно получить фактическую картину:
- какой робот приходил;
- когда;
- к какому URL;
- с каким User-Agent;
- какой HTTP-код получил;
- сколько данных скачал;
- сколько заняла обработка запроса, если формат логов сохраняет время ответа.
После этого большой массив можно сгруппировать по типам URL.
Допустим, за 30 дней зафиксировано 300 000 запросов Googlebot.
| Тип URL | Запросы |
|---|---|
| полезные canonical HTML | 95 000 |
| фильтры и параметры | 110 000 |
| внутренний поиск и сортировки | 35 000 |
| редиректы | 20 000 |
| удалённые URL | 25 000 |
| прочее | 15 000 |
| Всего | 300 000 |
Можно рассчитать рабочую диагностическую долю:
95 000 / 300 000 × 100 = 31,7%Получается, около 32% наблюдаемой crawl activity пришлось на полезные canonical HTML-страницы.
Но это принципиально важно назвать правильно.
Это не официальный показатель Google.
Не существует правила:
32% плохо, 70% хорошо.
Мы просто построили собственную аналитическую метрику, чтобы сравнивать ситуацию до и после технических изменений.
Например, через два месяца полезная доля выросла с 32 до 61%, новые карточки стали впервые обходиться быстрее, а число запросов к фильтрам сократилось.
Вот это уже нормальный измеримый результат.
Не доверяйте User-Agent вслепую
В логах может встретиться:
Googlebot/2.1Но любой скрипт способен написать себе такой User-Agent.
Если анализ действительно важен, подлинность роботов нужно проверять, а не доверять только названию клиента.
Иначе можно несколько часов оптимизировать crawl budget под чей-нибудь парсер из соседнего дата-центра, который просто представился Googlebot. Отличная работа, если целью было улучшить чужой скрейпер.
Какие метрики полезнее «размера бюджета»
Для бизнеса я бы следил минимум за тремя практическими вещами.
Сколько времени проходит до первого обхода нового URL
Публикуем группу новых страниц и фиксируем:
дата публикации → первый подтверждённый запрос GooglebotНе нужно судить по одной статье.
Смотрите распределение.
Например:
- медиана — 2 дня;
- 75% URL — до 4 дней;
- 95% URL — до 11 дней.
Через несколько месяцев:
- медиана — 12 часов;
- 75% — до 1,5 суток;
- 95% — до 4 дней.
Такое изменение понятно и владельцу бизнеса, и разработчику.
Как быстро переобходятся реально изменённые страницы
Не нужно каждый день менять дату статьи, чтобы проверять робота.
Берём страницы с существенными изменениями:
- новая цена;
- изменённый ассортимент;
- большой пересмотр текста;
- новый раздел;
- изменённые характеристики.
И смотрим задержку повторного crawl.
На что приходится crawl activity
Сколько запросов уходит на:
- полезные страницы;
- параметры;
- фильтры;
- дубли;
- редиректы;
- ошибочные URL;
- внутренний поиск.
Именно здесь можно увидеть, что техническая архитектура съедает ресурсы проекта.
Что делать, если роботы действительно обходят сайт плохо
Здесь важно не начинать с универсального рецепта.
Проблема может находиться в совершенно разных местах.
1. Сначала подтвердите сам симптом
Новая страница не появилась в поиске — ещё не значит, что робот её не обходил.
Проверьте:
- URL Inspection;
- Search Console;
- Яндекс Вебмастер;
- серверные логи.
Если Googlebot уже запрашивал документ, проблема могла перейти из crawling в indexing.
2. Проверьте обнаружение URL
Есть ли на страницу нормальные внутренние ссылки?
Есть ли она в Sitemap?
Не находится ли она на пятнадцатом уровне вложенности, куда можно попасть только через JavaScript-фильтр?
3. Сравните полезные URL с фактическими запросами роботов
Если магазин содержит 200 000 индексируемых страниц, а бот большую часть времени проводит на миллионах комбинаций:
?sort=
?view=
?session=
у вас уже появился конкретный технический объект для работы.
4. Разберите фасеты и параметры
Не нужно автоматически запрещать все фильтры.
Часть фильтров может быть полноценными SEO-посадочными страницами.
Например:
купить белый холодильник
может иметь самостоятельный спрос.
А:
белые холодильники, отсортированные по внутреннему рейтингу, по 96 товаров на странице
вряд ли требует отдельного поискового URL.
Задача состоит не в «закрыть параметры», а в классификации URL.
5. Исправьте дубли и цепочки редиректов
Не заставляйте робота проходить три промежуточных адреса там, где известна конечная цель.
Не поддерживайте десять доступных вариантов одного документа без необходимости.
6. Проверьте HTTP-статусы
Удалённая страница должна честно возвращать 404 или 410.
Переехавшая — вести постоянным редиректом на релевантную замену.
Рабочая — не отдавать случайный 5xx.
Пустой результат поиска — не притворяться полноценной страницей 200, если по сути это ошибка.
7. Проверьте сервер
Посмотрите:
- response time;
- TTFB;
- CPU;
- RAM;
- database load;
- PHP workers;
- очередь запросов;
429;5xx.
Если робот действительно упирается в возможности сервера, дополнительная инфраструктурная производительность уже может иметь прямой смысл.
8. После исправлений измерьте изменения
Не заканчивайте на:
robots.txt обновили, задача закрыта.
Через несколько недель сравните:
- структуру crawl requests;
- количество обращений к техническим URL;
- время первого обхода новых страниц;
- частоту возврата к важным страницам;
- серверную нагрузку.
Только после этого можно говорить, что оптимизация реально что-то изменила.
Что делает каждый SEO-инструмент
| Инструмент | Помогает обнаружить URL | Может ограничить crawl | Управляет индексацией | Работает с дублями |
|---|---|---|---|---|
| внутренняя ссылка | да | нет | косвенно | косвенно |
| Sitemap | да | нет | не гарантирует | косвенно |
| robots.txt | нет | да | не является надёжным способом удалить уже известный URL из поиска | косвенно |
| noindex | нет | нет: страницу сначала нужно получить | да | нет |
| canonical | нет | со временем может снизить повторный обход дублей | помогает выбрать основную версию | да |
| 301/308 | через новую цель | косвенно | переносит пользователя и робота на новый URL | помогает при переезде |
| 404/410 | нет | со временем снижает интерес к удалённому URL | сообщает об отсутствии документа | нет |
Именно поэтому попытка решить всё одним noindex или canonical обычно заканчивается плохо. Инструменты отвечают за разные этапы.
Миф: чем чаще Googlebot приходит, тем выше позиции
Нет.
Crawl — это получение документа, а не начисление баллов ранжирования.
Это логично.
Если ресторанный инспектор стал заходить в кафе четыре раза в неделю вместо одного, еда от этого автоматически вкуснее не стала.
Частый crawl может быстрее донести до поисковой системы изменения. Но после получения страницы поисковику всё ещё предстоит оценить сам документ.
Миф: чем больше запросов робота, тем лучше
Тоже нет.
Представьте два магазина.
У первого Googlebot выполняет миллион запросов в месяц:
- 700 000 фильтров;
- 150 000 параметров;
- 80 000 редиректов;
- 50 000 soft 404;
- 20 000 полезных страниц.
У второго только 200 000 запросов:
- 170 000 полезных страниц;
- 20 000 обновлённых категорий;
- 10 000 технических адресов.
У какого сайта «crawl budget лучше»?
Само количество HTTP-запросов не отвечает на этот вопрос.
Цель — не заставить робота больше работать.
Цель — сделать его работу эффективнее.
Миф: можно закрыть мусор и перенести весь бюджет на важные страницы
Не гарантируется.
Вы всё равно:
- уменьшаете нагрузку;
- делаете URL inventory понятнее;
- сокращаете обход технических пространств;
- упрощаете диагностику;
- снижаете риск задержки обнаружения полезного контента.
Но не нужно продавать результат как:
мы высвободили ровно 17 843 единицы crawl budget.
Такой счёт красиво выглядит в отчёте, но поисковая система его не ведёт.
Миф: нужно любой ценой заставить робота приходить чаще
Иногда владельцу проекта действительно хочется более быстрого обхода. Например, большой каталог ежедневно получает тысячи новых товаров.
Но сначала нужно понять причину задержки.
Если проблема в серверной мощности — можно работать с инфраструктурой.
Если поисковик не знает о URL — нужна архитектура обнаружения.
Если робот ходит по миллионам фильтров — нужно управлять URL inventory.
Если документ уже регулярно обходится, но не индексируется, дальнейшее ускорение робота проблему вообще не решает.
Это уже вопрос другого этапа обработки.
Где проходит граница между crawl-проблемой и проблемой индексации
Полезно представить цепочку:
URL создан → URL обнаружен → URL просканирован → контент обработан → выбрана canonical-версия → принято решение об индексировании → страница участвует в поиске → получает показы.
На каждом этапе может возникнуть отдельная проблема.
Если робот не знает URL — работаем с обнаружением.
Если знает, но почти не запрашивает — смотрим crawl demand, архитектуру и масштаб URL inventory.
Если пытается запросить, но получает 5xx — смотрим сервер.
Если успешно получает 200, но документ не индексируется — crawl budget может быть вообще ни при чём.
Если страница индексируется, но имеет ноль показов — это уже не вопрос краулинга.
Поэтому фразу:
Статья не получает трафик, надо увеличить crawl budget.
можно сравнить с:
Магазин плохо продаёт холодильники, давайте расширим парковку.
Иногда парковка действительно тесная. Но сначала неплохо бы проверить цены, ассортимент и то, знают ли покупатели вообще о существовании магазина.
Когда crawl budget становится настоящей SEO-задачей
Я бы начинал серьёзно смотреть в эту сторону, когда одновременно присутствует несколько признаков.
Проект действительно большой или быстро меняется.
Полезных URL десятки или сотни тысяч.
Техническая архитектура позволяет создавать гораздо больше адресов, чем реального контента.
Новые страницы долго остаются необойдёнными.
В логах заметна высокая доля бесполезных URL.
Сервер испытывает заметную crawler-нагрузку.
Только тогда разговор о crawl budget превращается из SEO-термина в инженерную задачу.
Когда проблема почти наверняка не в crawl budget
Небольшой сайт услуг на 80 страниц.
Все страницы периодически обходятся.
Сервер отвечает нормально.
В Sitemap правильные URL.
Нет миллионов параметров.
Индекс пустой или видимость слабая.
Здесь гораздо полезнее проверить:
- качество и уникальность страниц;
- поисковый спрос;
- архитектуру сайта;
- каноникализацию;
- внутреннюю перелинковку;
- соответствие страниц интенту;
- техническую индексацию.
Ускорять робота, который и без того уже прочитал все 80 страниц, примерно так же полезно, как нанимать второго официанта в кафе без посетителей.
Что считать хорошей оптимизацией crawl budget
Не максимум запросов.
Не красивый график, который каждый месяц растёт вверх.
Не условные «50 000 страниц в день».
Хороший результат выглядит так:
поисковики знают важные URL;
новые и существенно обновлённые документы обнаруживаются в приемлемый для проекта срок;
сервер стабильно их отдаёт;
технические URL не создают бесконечное пространство;
значительная часть crawl activity приходится на документы, которые действительно имеют смысл обрабатывать;
в логах нет системных 429, 5xx и бессмысленных redirect chains.
Вот это можно измерять.
Нужен ли бизнесу отдельный проект по crawl budget
Для небольшого корпоративного сайта — практически никогда.
Для каталога на несколько миллионов URL — иногда это одна из ключевых технических задач.
Причём сама работа обычно называется не «увеличить бюджет Googlebot», а значительно прозаичнее:
- исправить архитектуру фильтров;
- нормализовать URL;
- убрать генераторы дублей;
- настроить canonical;
- переработать robots.txt;
- сократить редиректы;
- ускорить backend;
- исправить HTTP-коды;
- улучшить внутренние связи;
- анализировать server logs.
То есть crawl budget оказывается не отдельной магией, а следствием нормальной технической архитектуры сайта.
На крупных проектах подобный анализ обычно входит в системное SEO-продвижение сайтов: сначала определяется, на каком этапе поисковая система теряет или медленно обрабатывает нужные URL, а уже потом выбирается техническое решение.
Сам по себе отчёт:
Googlebot сделал на 15% больше запросов
ценности для бизнеса не имеет, если новые товары всё равно обнаруживаются через три недели.
Что проверять при разных симптомах
| Симптом | Где смотреть | Вероятные причины |
|---|---|---|
| новый URL вообще не обходится | внутренние ссылки, Sitemap, access.log | URL плохо обнаруживается |
| новые URL обходятся очень медленно | Crawl Stats, access.log | низкий demand, огромное URL-пространство |
| много запросов к фильтрам | access.log, Яндекс Вебмастер | фасеты, GET-параметры |
| робот получает 429 | серверные метрики | ограничение запросов, нехватка ресурсов |
| много 5xx | логи приложения и сервера | backend, база, PHP, инфраструктура |
| URL обходится, но не индексируется | Page Indexing, URL Inspection | уже не crawl-проблема |
| много redirect requests | access.log, Crawl Stats | цепочки редиректов |
| страницы ошибок возвращают 200 | curl, access.log | soft 404 |
| робот редко возвращается к старой странице | лог обхода | документ редко меняется или имеет низкий demand |
Эта таблица полезнее любой попытки определить универсальное «нормальное количество обходов».
Главное
Crawl budget действительно можно представить как деньги — но только чтобы сделать первый шаг.
У поисковой системы есть конечные вычислительные ресурсы. У вашего сервера есть конечная производительность. Поэтому бессмысленно заставлять робота тратить время на миллионы параметров, дублей, бесконечных календарей и технических фильтров.
Но после этого аналогию с кошельком лучше выбросить.
У Googlebot нет фиксированной суммы страниц до конца месяца.
Объём обхода динамически зависит от того, сколько сайт способен нормально отдать и насколько поисковой системе вообще нужны дополнительные запросы к его URL.
У Яндекса тоже нет банковского счёта с количеством страниц: его Вебмастер оперирует скоростью запросов, причём даже вручную заданное значение считается рекомендованным и может отличаться от фактического.
Поэтому правильная SEO-задача звучит не так:
Как получить больше crawl budget?
А так:
Достаточно ли быстро поисковые роботы находят и обновляют важные страницы сайта, и не заставляем ли мы их тратить ресурсы на URL, которые вообще не должны существовать в поисковой архитектуре?
Если у вас сайт электрика на 80 страниц — не покупайте новый сервер ради crawl budget.
Если у вас интернет-магазин на 500 000 полезных страниц, который благодаря фильтрам создал ещё двадцать миллионов URL, — тогда пора открывать access.log.
Практика
Как проверить crawl budget сайта на практике
Определите реальное количество полезных URL
Составьте список страниц, которые действительно должны участвовать в поиске: категории, карточки, статьи, услуги и другие canonical URL. Не смешивайте их с сортировками, параметрами и служебными страницами.
Откройте Crawl Stats в Google Search Console
Изучите статистику сканирования: количество запросов, среднее время ответа, состояние хоста, HTTP-коды и назначение обхода.
Проверьте Статистику обхода в Яндекс Вебмастере
Посмотрите, какие URL YandexBot реально запрашивает и нет ли среди них большого количества дублей, параметров и технических страниц.
Выгрузите access.log
Получите данные минимум за несколько недель и отфильтруйте запросы подтверждённых Googlebot и YandexBot.
Классифицируйте URL
Разделите запросы на полезные canonical-страницы, параметры, фильтры, поиск, редиректы, 404/410, soft 404 и серверные ошибки.
Найдите системный источник лишних URL
Не исправляйте отдельные адреса вручную, если их генерирует общий механизм. Найдите правило маршрутизации, фильтра, параметра или шаблона, которое создаёт весь класс URL.
Исправьте архитектуру
Используйте подходящий инструмент: нормальные внутренние ссылки, canonical, robots.txt, корректные HTTP-коды, прямые редиректы или изменение логики генерации URL.
Сравните данные после изменений
Через несколько недель повторите анализ и проверьте, стали ли нужные URL обнаруживаться быстрее, сократился ли обход технического пространства и снизилась ли нагрузка на сервер.
FAQ
Частые вопросы о crawl budget и обходе сайта
Универсальной цифры нет. Для одного сайта 5 000 запросов в сутки могут полностью покрывать все изменения, а для другого 100 000 запросов будут в основном уходить на параметры и фильтры. Оценивать лучше скорость обнаружения важных URL, структуру запросов роботов, состояние сервера и долю технического crawl.
Search Console показывает статистику фактического обхода: количество запросов, ответы сервера, время отклика и другие данные. Но отдельного счётчика «вам осталось 18 000 страниц до конца дня» там нет.
Как правило, нет. Если основные страницы нормально обнаруживаются и периодически сканируются, причина слабой индексации или видимости почти наверняка находится в другом месте.
Отдельные корректные 404 являются нормальной частью веба. Проблемой становятся массово генерируемые ненужные адреса, внутренние ссылки на удалённые страницы или soft 404 с ответом 200.
Sitemap помогает поисковику обнаруживать URL, особенно на крупном или сложном сайте, но сам по себе не гарантирует немедленный обход и тем более индексацию.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.