Сканирование сайта начинается раньше индексирования. Сначала поисковая система должна узнать о URL, поставить его в очередь обхода и получить ответ сервера. Затем содержимое может быть обработано, при необходимости отрендерено и передано на этап индексирования. Google прямо разделяет crawling, indexing и показ в результатах поиска и не гарантирует, что каждый просканированный документ попадёт в индекс.
Для SEO это различие принципиально. Если робот не может получить нужную страницу, поисковая система не увидит её актуальную версию. Но обратное неверно: большое число обходов не означает автоматически ни индексирования, ни роста позиций. Поэтому диагностика должна отвечать не на вопрос «как заставить робота ходить чаще», а на вопрос «может ли поисковик стабильно находить и получать именно те URL, которые важны сайту».
Что происходит во время сканирования сайта
У поисковой системы нет готового полного списка всех страниц интернета. Новые адреса обнаруживаются, в частности, через уже известные ссылки и Sitemap. Для Google обычная внутренняя ссылка должна быть доступной для разбора как элемент <a> с href; ссылки, существующие только как нестандартные JavaScript-события, могут быть ненадёжным способом обнаружения URL.
Упрощённо цепочка выглядит так:
| Этап | Что происходит | Что может пойти не так |
|---|---|---|
| Обнаружение | поисковик узнаёт адрес URL | на страницу никто не ссылается, URL отсутствует в Sitemap |
| Проверка доступа | учитываются ограничения для робота | нужный путь закрыт в robots.txt |
| Запрос | робот обращается к серверу | 5xx, 429, таймаут, длинная цепочка редиректов |
| Получение и рендеринг | обрабатываются HTML и необходимые ресурсы | контент появляется только после действия пользователя или не рендерится |
| Индексирование | поисковик оценивает полученный документ | URL может быть признан дублем или не выбран для индекса |
Это объясняет частую ситуацию: страница существует и прекрасно открывается владельцу сайта, но поисковый робот либо ещё не знает её адреса, либо получает другой ответ, либо не видит существенную часть содержимого после рендеринга.
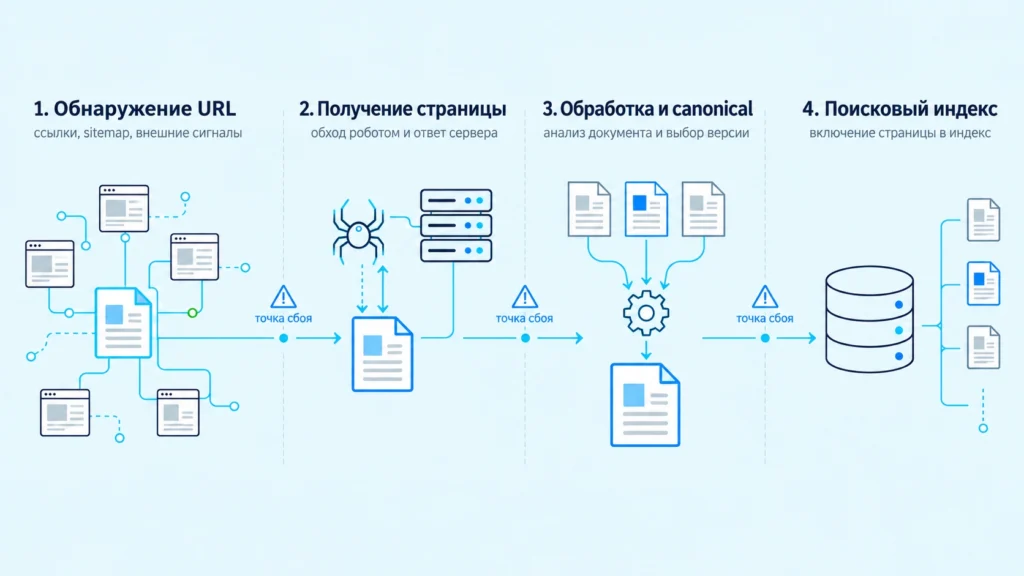
Где URL теряются между обнаружением и обходом
Первая группа проблем относится не к серверу, а к архитектуре. Если важная страница существует только в XML Sitemap, но на неё нет обычных внутренних ссылок, поисковик получает более слабый сигнал о её месте в структуре. В SEO под «глубиной сканирования» часто понимают количество переходов от сильных разделов сайта до конкретного URL. Это не отдельный официальный показатель Google, который нужно доводить до магического значения, но слишком глубокая вложенность действительно усложняет обнаружение страниц. Яндекс также отмечает зависимость скорости обнаружения от глубины вложенности.
Вторая группа — ограничения обхода. robots.txt управляет доступом crawler к URL, но его нельзя воспринимать как универсальный инструмент удаления страниц из поиска. Google прямо предупреждает: адрес, запрещённый к обходу, всё ещё может быть известен поисковой системе по внешним или внутренним ссылкам. Если задача состоит именно в исключении индексируемой страницы, механизм следует выбирать по цели, а не просто добавлять Disallow.
Третья группа — ответы сервера. Нестабильные 5xx, ограничение частоты запросов через 429, высокая задержка и длинные цепочки редиректов могут ухудшать эффективность обхода. Google учитывает состояние хоста и его способность обслуживать запросы, чтобы не создавать избыточную нагрузку.
Googlebot Smartphone и мобильная версия
Для Google Search ориентироваться нужно прежде всего на мобильную версию. Google завершил переход на mobile-first crawling: основной обход и индексирование для поиска выполняются Googlebot Smartphone, хотя отдельные обращения Googlebot Desktop всё ещё могут встречаться для других поисковых функций.
Практическое следствие простое: скрытый на мобильной версии основной текст, отличающиеся robots-директивы, недоступные CSS/JS-ресурсы или контент, появляющийся только после клика, нельзя считать безобидным отличием адаптивной версии. Google рекомендует обеспечивать роботу доступ к мобильному контенту и важным ресурсам и не загружать основной контент только после пользовательского действия.
Как проверить сканирование сайта, а не гадать по индексу
Для отдельного URL в Google удобнее начинать с URL Inspection. Инструмент показывает сведения о версии страницы, известной Google, и позволяет проверить текущий доступный вариант. Важно различать сохранённые данные об индексированной версии и live test: это ответы на разные вопросы.
Для сайта целиком нужен Crawl Stats в Search Console. Там можно увидеть общее количество запросов, объём скачанных данных, среднее время ответа, состояние хоста, распределение ответов, типы файлов, назначение обхода и тип Googlebot. Это помогает отличить проблему конкретной страницы от системной ошибки сервера или всплеска технических URL.
На стороне Яндекса аналогичную диагностику дают разделы индексирования и статистики обхода. Если отдельно изучаете, как работает робот яндекса, полезно сопоставлять дату последнего посещения и HTTP-код страницы с тем, что реально отдаёт сервер сейчас. Яндекс Вебмастер показывает посещённые роботом URL и ошибки загрузки.
Для сложных случаев добавляйте access-логи сервера. Именно они позволяют проверить факт конкретного HTTP-запроса, адрес, время и код ответа. При этом одного значения User-Agent: Googlebot недостаточно для доказательства происхождения запроса: Google рекомендует при необходимости верифицировать робота по IP или reverse DNS.
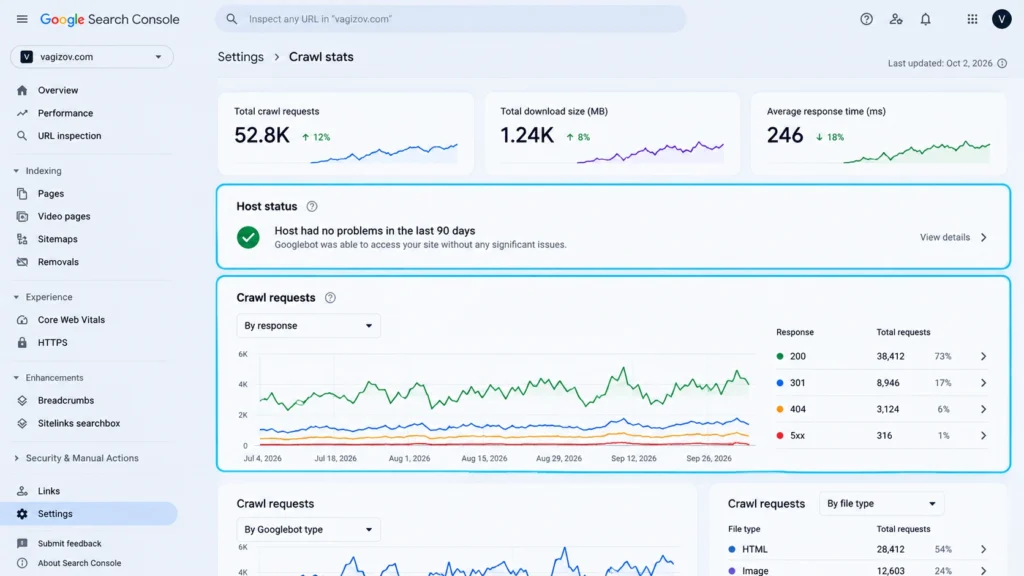
Что исправлять после диагностики
Исправление зависит от того, на каком этапе рвётся цепочка.
| Симптом | Что проверить | Нормальный результат |
|---|---|---|
| Новый URL не обнаруживается | внутренние <a href>-ссылки, Sitemap | URL доступен из структуры и указан среди нужных канонических адресов |
| URL запрещён роботу | robots.txt и область действия правила | нужная поисковая страница разрешена к обходу |
Много 5xx или 429 | сервер, CDN, WAF, лимиты | бот стабильно получает ожидаемый ответ |
| Контент не виден после загрузки | rendered HTML, JS, заблокированные ресурсы | основной контент присутствует в отрендеренной версии |
| Робот ходит по множеству дублей | параметры, фильтры, календарные и служебные URL | число бесполезных вариантов сокращается, важные URL остаются доступными |
| Частые длинные редиректы | цепочки 3xx | ссылка ведёт максимально близко к конечному каноническому URL |
Для быстрой проверки ответа сервера полезен обычный запрос заголовков:
curl -I https://example.com/page/Он позволяет увидеть HTTP-код, редирект и основные заголовки, но не заменяет проверку поисковым инструментом и не показывает, как Google отрендерит JavaScript.
Отдельно стоит относиться к «crawl budget». Google определяет его через доступную ёмкость обхода и спрос на повторное сканирование. При этом собственное руководство Google адресовано прежде всего очень крупным или быстро меняющимся сайтам и ресурсам с большим числом URL в состоянии Discovered — currently not indexed. Для обычного корпоративного сайта попытка «увеличить краулинговый бюджет» часто менее полезна, чем исправление архитектуры, Sitemap, дублей и серверных ошибок.

Практический сценарий: новые страницы существуют, но робот редко до них доходит
Представим раздел, куда массово добавили новые материалы. Они присутствуют в Sitemap, но находятся в нескольких переходах от основных страниц, часть ссылок строится JavaScript-компонентом без обычного href, а фильтр раздела создаёт множество параметрических URL.
Смотреть только на число страниц в индексе в такой ситуации недостаточно. Сначала проверяют несколько новых URL через URL Inspection, затем Crawl Stats и серверные логи: приходил ли робот, какой код получил и какие группы адресов он обходит вместо новых материалов. После этого анализируют фактические внутренние ссылки и URL, создаваемые фильтром.
Если выясняется, что Googlebot регулярно запрашивает параметрические варианты, а до новых материалов почти не доходит, корректируют не «частоту робота», а источник проблемы: дают важным страницам обычные HTML-ссылки, актуализируют Sitemap, сокращают бессмысленные URL-варианты и устраняют ошибки ответа.
Ожидаемый результат такого исправления — не гарантированный рост позиций, а технически проверяемое изменение: нужные URL обнаруживаются, сервер стабильно их отдаёт, робот начинает появляться в логах, а инструменты поисковой системы фиксируют новый обход. Уже после этого отдельно оценивается индексирование и поисковая эффективность страниц.
Когда проверку сканирования можно считать завершённой
У исправленной страницы должен сходиться весь маршрут: поисковик может обнаружить URL, robots.txt не запрещает необходимый обход, сервер отдаёт ожидаемый статус без ненужной цепочки переходов, важное содержимое доступно в мобильной отрендеренной версии, а внутренние ссылки ведут на правильный адрес.
Для небольшого и среднего сайта этого обычно важнее, чем попытка добиться как можно большего числа обращений робота. Сканирование сайта — инфраструктурная часть SEO: она создаёт условия, при которых поисковая система может вовремя получить документ. Индексирование, релевантность и позиции решаются уже на следующих этапах.
Если робот регулярно упирается в 5xx или 429, дубли, JavaScript-навигацию либо не находит важные URL, разовая проверка уже не решает задачу. Услуги SEO-продвижения с технической диагностикой сайта в таком случае нужны для связки данных Search Console, серверных логов, краула и реальной структуры: найти источник потерь, исправить его и затем проверить новый обход и индексирование.
FAQ
Если робот не обходит нужные URL: как определить причину
Это процесс, при котором поисковый робот приходит на известный ему URL и запрашивает страницу или другой ресурс у сервера. После обхода поисковая система может обработать содержимое и решить, включать ли его в индекс. Поэтому сканирование и индексирование — связанные, но разные процессы.
Без доступного обхода поисковой системе сложнее получить актуальное содержимое страницы, поэтому краулинг необходим для нормальной работы поиска. Но большее число запросов робота само по себе не является гарантией более высоких позиций. Google отдельно указывает, что успешно просканированная страница не обязательно будет индексирована.
Для отдельного URL используйте URL Inspection в Google Search Console: там можно посмотреть данные о версии страницы, известной Google, и выполнить проверку текущей версии. Для картины по сайту используйте Crawl Stats, а для наиболее точного анализа фактических обращений робота — серверные access-логи.
На практике часто встречаются запрет нужных URL в robots.txt, ошибки 5xx и 429, длинные цепочки редиректов, отсутствие обычных HTML-ссылок на важные страницы и критичный контент, доступный только после пользовательского действия в JavaScript. Отдельная проблема крупных сайтов — генерация большого количества дублирующих и технических URL.
Сначала убедитесь, что проблема действительно устранена на конечном URL и сервер стабильно отвечает без ошибок. Затем проверьте внутренние ссылки и Sitemap, а для отдельной страницы можно выполнить live-проверку и запросить индексирование в Search Console. Отсутствие немедленного повторного обхода само по себе не означает, что исправление не сработало: частоту посещений поисковая система определяет самостоятельно.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.