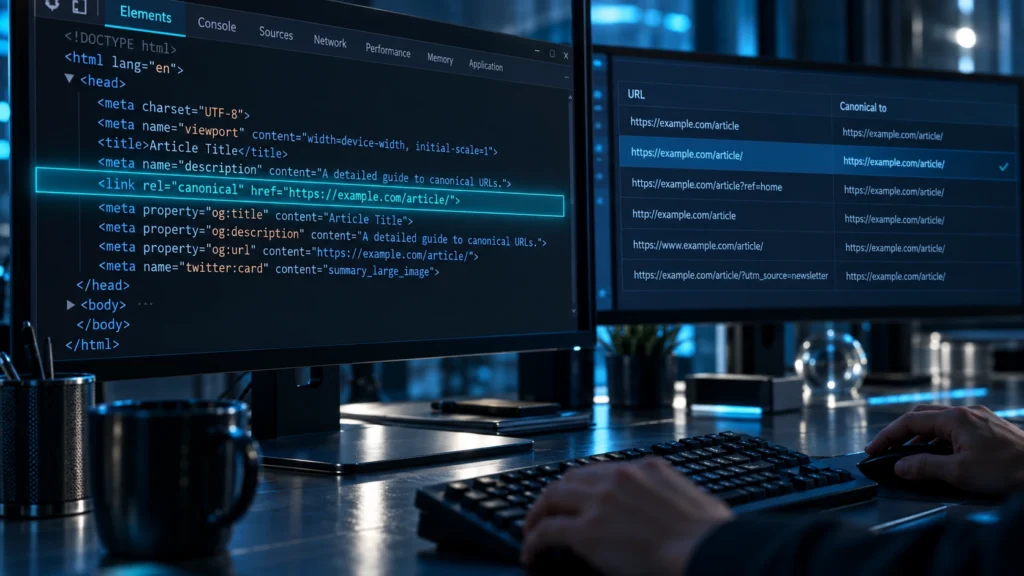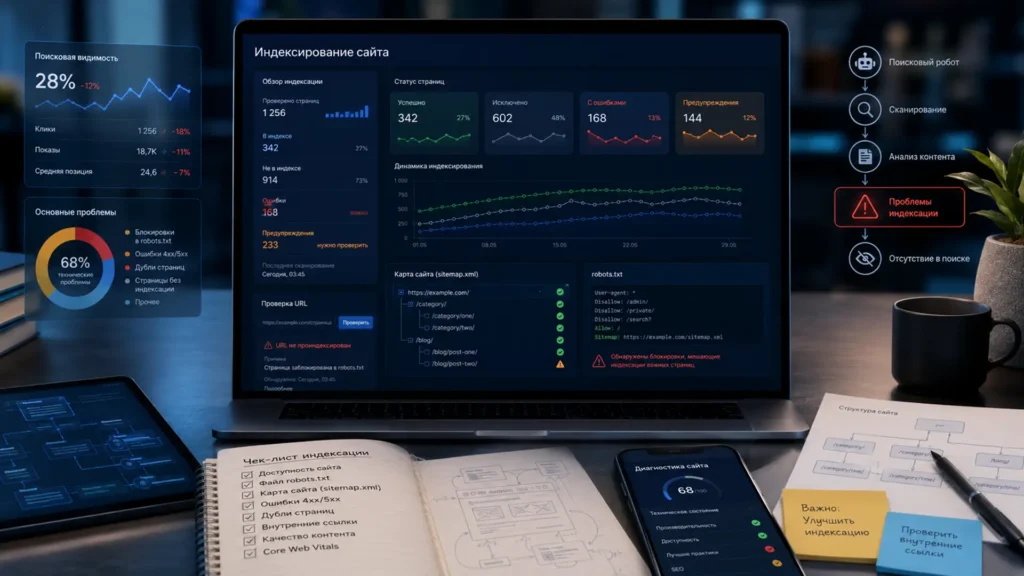
Канонический URL нужен тогда, когда один и тот же или почти одинаковый контент доступен по нескольким адресам. Типичные примеры — параметры сортировки и аналитики, HTTP- и HTTPS-версии, варианты со слешем, страницы одного товара по разным маршрутам CMS или случайно доступная копия материала.
Важно понимать границу механизма: владелец сайта указывает предпочтительный адрес, но не назначает его поисковой системе безусловно. Google рассматривает canonical вместе с редиректами, Sitemap, внутренними ссылками и другими сигналами, а Яндекс также может не принять указанную страницу, если конфигурация или содержимое URL противоречат этому выбору.
Канонический URL: что именно выбирает поисковик
Когда поисковая система находит несколько одинаковых или близких по содержанию страниц, она может объединить их в одну группу и выбрать URL, который будет представлять этот контент в поиске. Такой адрес и становится каноническим.
Например, интернет-магазин может отдавать одну категорию по адресам:
https://example.com/catalog/phones/
https://example.com/catalog/phones/?utm_source=newsletter
https://example.com/catalog/phones/?sort=price
Если две версии с параметрами не создают самостоятельной поисковой ценности, логичным представителем группы будет:
https://example.com/catalog/phones/На альтернативных HTML-страницах можно указать:
<link rel="canonical" href="https://example.com/catalog/phones/">На самой основной странице self-canonical с тем же адресом делает выбор явным:
<link rel="canonical" href="https://example.com/catalog/phones/">Canonical не удаляет альтернативный URL, не перенаправляет посетителя и сам по себе не запрещает обход страницы. Пользователь по-прежнему может открыть URL с параметром, а поисковик — повторно его просканировать.
Сначала решите, какой URL действительно должен быть главным
Главная ошибка возникает ещё до установки тега: canonical выбирают автоматически, не определив, какую страницу сайт хочет сохранить в поиске.
Хороший кандидат на основной URL обычно отвечает нескольким условиям одновременно:
- возвращает нормальный HTTP-ответ
200 OK; - доступен поисковому роботу;
- не закрыт от индексирования;
- содержит полную версию нужного контента;
- не перенаправляет на другой адрес;
- используется во внутренних ссылках;
- указан в Sitemap, если страница должна индексироваться;
- не является технической вариацией с ненужными параметрами.
Если две страницы решают разные поисковые задачи, объединять их canonical только из-за частичного совпадения текста опасно. Страница «смартфоны до 30 000 рублей» может быть самостоятельным посадочным URL, тогда как ?sort=price лишь меняет порядок тех же товаров.
То есть сначала нужно определить смысл дубля, и только затем его техническую обработку.
Canonical, редирект или другой способ: выбирайте по задаче
rel="canonical" подходит не для любого повторяющегося URL. Если альтернативная страница больше не должна существовать для пользователя, обычно проще убрать сам дубль.
| Ситуация | Что применять |
|---|---|
| Старый URL полностью заменён новым | постоянный redirect |
| Две доступные страницы содержат одинаковый или очень похожий материал | rel="canonical" |
| Один PDF доступен по нескольким адресам | HTTP-заголовок Link с rel="canonical" |
| Нужно подсказать основной набор индексируемых URL | включать канонические версии в Sitemap |
| URL отличается только ненужными параметрами | исправить генерацию и внутренние ссылки, затем использовать подходящий механизм консолидации |
| Страницы отличаются по интенту и содержанию | не объединять их только ради устранения «дубля» |
Для не-HTML-документа canonical можно передать через HTTP:
Link: <https://example.com/files/catalog.pdf>; rel="canonical"При этом разные способы не должны противоречить друг другу. Плохая конфигурация выглядит так: HTML объявляет URL A каноническим, Sitemap содержит URL B, внутренние ссылки ведут преимущественно на B, а A ещё и перенаправляет на C.
Такая система заставляет поисковик самостоятельно разбираться, какой сигнал считать корректным.
На сайтах с клиентской отрисовкой отдельно проверяйте canonical, который задаётся через JavaScript. Исходный HTML и итоговый DOM не должны в результате сообщать поисковой системе два разных предпочтительных адреса.
Как проверить канонический URL, а не только наличие тега
Проверка исходного HTML отвечает лишь на вопрос, какой URL объявил сам сайт. Для SEO важен второй вопрос: какой адрес в итоге выбрала поисковая система.
Начните с самого URL. Проверьте код ответа, доступность для робота, robots-директивы и canonical в <head>:
<head>
    <link rel="canonical" href="https://example.com/catalog/phones/">
</head>
Затем проверьте альтернативную страницу. Если она объявляет основной URL, посмотрите, действительно ли их основной контент достаточно близок.
В Google Search Console инструмент проверки URL показывает два важных значения:
- canonical, объявленный владельцем сайта;
- canonical, выбранный Google.
Их совпадение — хороший признак, но не единственный критерий. Нужно также посмотреть, индексируется ли ожидаемый URL и не появились ли неожиданные версии страницы.
В Яндекс Вебмастере полезно проверять исключённые страницы и статусы дублей. Если нужная страница неожиданно считается неканонической, проверьте не только тег, но и доступность указанного основного URL.
Где canonical чаще всего ломается
Каноническая страница сама перенаправляет пользователя
Если дубль указывает canonical на URL A, а A отвечает редиректом на B, возникает лишняя цепочка сигналов. Лучше указывать конечный пригодный для индексирования адрес.
На странице присутствует несколько canonical
Такое бывает из-за конфликта темы WordPress, SEO-плагина и собственного кода. Поэтому при аудите нужно смотреть итоговый HTML и HTTP-заголовки, а не только настройки одного плагина.
Sitemap и внутренние ссылки ведут на дубль
Canonical говорит, что основной URL — один, но навигация сайта постоянно продвигает другой. В результате архитектура сама создаёт неоднозначность.
Canonical ведёт на заметно другую страницу
Этот механизм предназначен для одинаковых или очень похожих документов. Нельзя превращать его в универсальный способ «передать вес» с любой страницы на нужную посадочную.
Дубль закрыт в robots.txt до проверки canonical
Для Google robots.txt не является способом каноникализации. Если робот не может получить страницу, он также не сможет нормально использовать находящийся в её HTML canonical.
У Яндекса есть дополнительные инструменты для работы с техническими GET-параметрами, включая Clean-param, но это не повод смешивать в одной задаче все способы удаления дублей одновременно.
Canonical конфликтует с noindex
noindex решает другую задачу: запрещает включать конкретный URL в поиск. Если задача состоит именно в консолидации похожих страниц вокруг основной версии, сначала определите одну стратегию, а не отправляйте поисковой системе одновременно противоречивые указания.
Практический сценарий: категория магазина с параметрами
Представим категорию:
https://example.com/catalog/notebooks/CMS создаёт дополнительные URL:
https://example.com/catalog/notebooks/?sort=price
https://example.com/catalog/notebooks/?utm_source=email
https://example.com/catalog/notebooks/?view=list
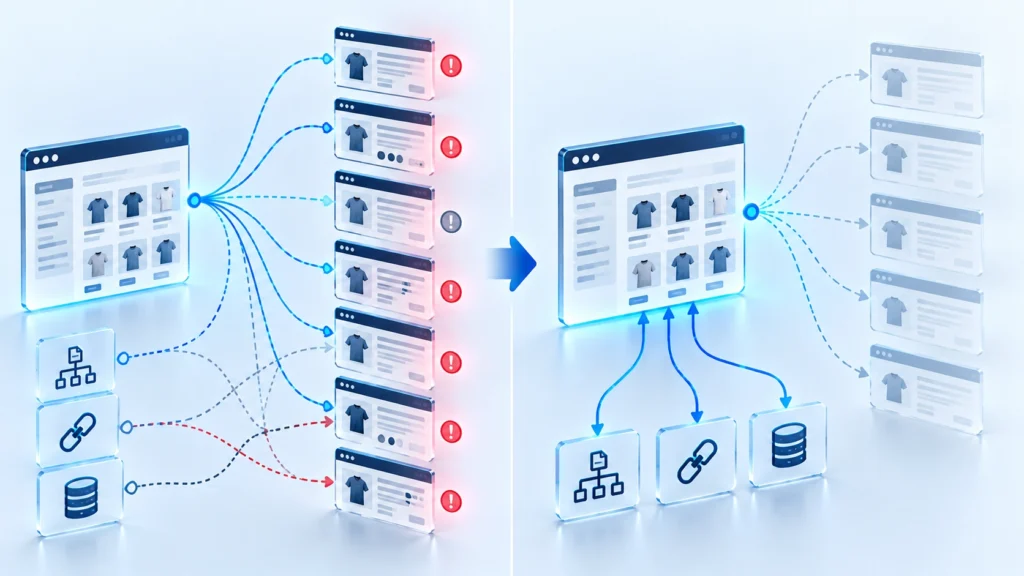
Исходная задача — сохранить индексируемой основную категорию и не размножать технические версии без отдельного поискового интента.
Первый этап — проверить, действительно ли параметры не меняют смысл страницы. utm_source обычно используется только для аналитики, а view=list может менять представление тех же объектов. С фильтрами ситуация сложнее: если параметр формирует полезную посадочную страницу с отдельным спросом, автоматически отправлять её canonical на общую категорию уже нельзя.
Для настоящих дублей конфигурация может выглядеть так:
<link rel="canonical" href="https://example.com/catalog/notebooks/">Далее нужно заменить внутренние ссылки на параметризованные адреса там, где параметры не нужны, оставить в Sitemap только основной индексируемый URL и проверить, не создаёт ли CMS новые варианты через навигацию.
После переобхода сравнивают ожидаемый canonical с выбором поисковой системы.
Как понять, что настройка действительно исправлена
Не стоит считать задачу закрытой сразу после появления правильного <link rel="canonical"> в коде.
Финальная проверка состоит из нескольких уровней:
- основной URL открывается без лишнего редиректа и возвращает корректный ответ;
- его содержимое соответствует версии, которую требуется сохранить в поиске;
- дубли указывают на ожидаемую основную страницу;
- внутренние ссылки не продолжают массово вести на технические версии;
- Sitemap содержит нужный URL, а не его альтернативу;
- поисковая система после переобхода выбирает ожидаемый canonical.
Если Google или Яндекс продолжают предпочитать другой URL, это не означает автоматически, что «canonical не работает». Сначала найдите конфликт: отличия контента, ошибочный редирект, закрытую основную страницу, несколько тегов, неправильную генерацию URL или внутренние ссылки на другую версию.
Canonical лучше воспринимать не как команду для исправления дублей постфактум, а как один из элементов нормальной архитектуры сайта. Чем меньше сайт сам создаёт конкурирующих адресов и чем согласованнее его технические сигналы, тем меньше работы приходится перекладывать на алгоритмы поисковой системы.
Практика
Как настроить и проверить канонический URL
Соберите варианты страницы
Найдите основной URL и его дубли: версии с параметрами, другим слешем, протоколом, сортировкой или альтернативным маршрутом CMS.
Выберите основной адрес
Определите один индексируемый URL с полноценным содержимым, кодом 200 OK и без перенаправления на другую страницу.
Согласуйте технические сигналы
Укажите предпочтительный URL через rel="canonical" либо редирект и убедитесь, что Sitemap и внутренние ссылки ведут на ту же версию.
Проверьте исходный код
Убедитесь, что на странице присутствует один корректный canonical и он не меняется на другой URL после выполнения JavaScript.
Проверьте поисковые системы
В Search Console сравните объявленный и выбранный Google canonical, а в Яндекс Вебмастере проверьте статус страницы и наличие дублей.
Контролируйте переобход
После внедрения дождитесь повторного обхода и проверьте, что основная версия остаётся индексируемой, а альтернативные URL обрабатываются именно так, как было задумано.
FAQ
Когда canonical работает не так, как ожидается
Это адрес, который должен представлять основную версию контента среди нескольких одинаковых или очень похожих URL. Владелец сайта может указать предпочтительный вариант, но поисковая система сопоставляет его с другими сигналами и принимает окончательное решение самостоятельно.
Сам по себе rel="canonical" не является гарантированным способом повысить позиции. Его задача — помочь поисковой системе сгруппировать дубли и консолидировать сигналы вокруг предпочтительного URL. Улучшение видимости возможно как следствие исправления технической структуры, но гарантировать рост нельзя.
Значит, другие сигналы противоречат вашему выбору или Google считает другой URL более подходящим представителем группы. Нужно сравнить содержимое страниц, редиректы, внутренние ссылки, Sitemap, статус индексирования и объявленный canonical. В Search Console для этого доступны поля User-declared canonical и Google-selected canonical.
Для Google self-referencing canonical является рекомендуемой практикой. Это делает предпочтение явным и помогает избежать неоднозначности при появлении параметров или альтернативных вариантов URL. Важно, чтобы остальные сигналы сайта не противоречили этому адресу.
Если альтернативный URL больше не нужен пользователям, обычно логичнее перенаправить его на основной адрес. Если обе версии должны оставаться доступными, но представляют одинаковый или очень похожий контент, подходит rel="canonical". Выбор зависит от того, должен ли пользователь продолжать открывать оба URL.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.