Краулер — это программа, которая автоматически обнаруживает URL и запрашивает их содержимое. В поисковых системах такие программы называют также роботами, ботами или crawlers: Google использует Googlebot, Яндекс — собственных индексирующих роботов.
Для владельца сайта важен не сам факт визита робота, а вся цепочка: поисковая система должна узнать об URL, получить к нему доступ, загрузить корректный документ и только затем решить, подходит ли он для индексирования. Поэтому ситуация «робот был на странице» ещё не означает, что она обязательно появится в поиске.
Краулер: что происходит между найденной ссылкой и индексом
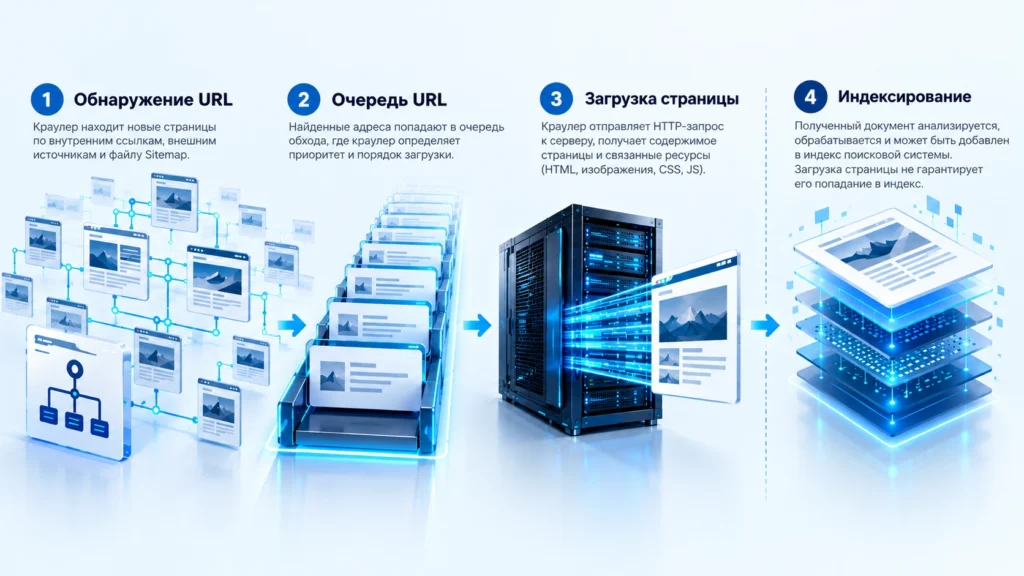
Обход начинается с уже известных поисковой системе адресов. Новые URL могут обнаруживаться через ссылки на ранее загруженных страницах и через Sitemap. После обнаружения адрес попадает в очередь, однако это не означает немедленный запрос страницы.
Когда очередь доходит до URL, краулер обращается к серверу. На этом этапе имеют значение как минимум четыре вещи:
- разрешён ли доступ правилами
robots.txt; - доступен ли хост и способен ли он нормально отвечать на запросы;
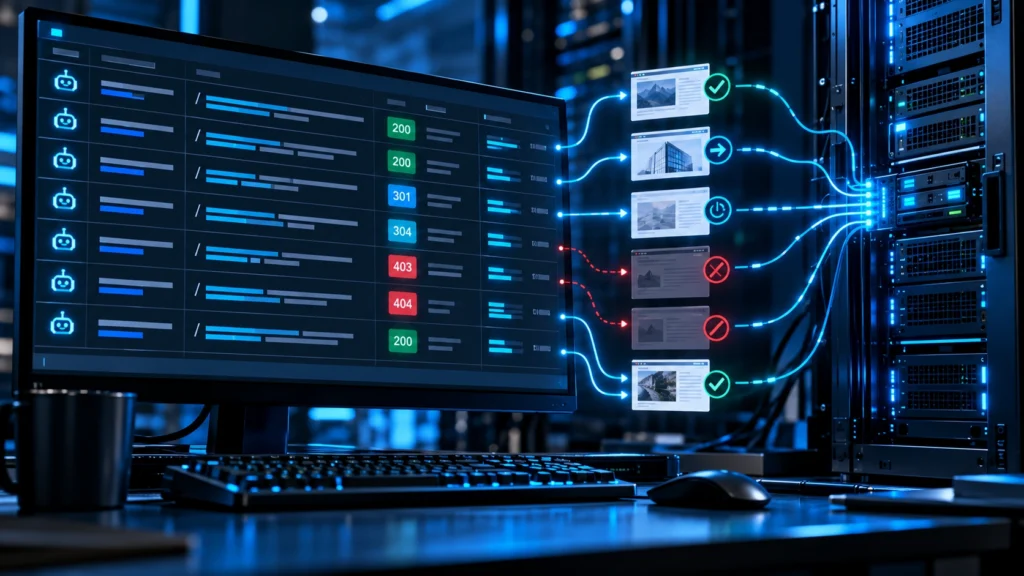
- какой HTTP-статус возвращает URL;
- какое содержимое реально получает робот.
Для Google технический минимум для возможности индексирования включает доступ Googlebot, успешный HTTP-ответ и индексируемое содержимое. Но даже соблюдение этих условий не является гарантией попадания документа в индекс.
Дальше начинается отдельный этап — обработка и индексирование. Поэтому краулинг и индексирование нельзя использовать как взаимозаменяемые термины. Если требуется глубже разобрать работу конкретной поисковой системы, полезно отдельно рассматривать, как робот Яндекса обходит сайт.
Откуда краулер узнаёт о страницах
Один из основных источников обнаружения — обычные ссылки между документами. Если важная страница существует технически, но до неё нельзя дойти по нормальным внутренним ссылкам, поисковому роботу сложнее понять её место в структуре сайта.
Sitemap дополняет эту систему. Файл сообщает поисковику о URL, которые владелец сайта считает значимыми, и особенно полезен для крупных проектов, новых сайтов, глубоко вложенных документов и страниц, которые трудно обнаружить через навигацию.
Но Sitemap не является списком обязательных заданий для робота. Наличие URL в файле не гарантирует его обход, индексирование или показ в результатах поиска.
Поэтому при техническом аудите полезно мыслить не отдельным Sitemap, а маршрутом:
внутренняя ссылка → обнаружение URL → разрешение на обход → HTTP-ответ → содержимое страницы
Эта логика помогает не смешивать сам поисковый робот с более широким процессом индексирования и формирования поисковой выдачи.
Как проверить работу краулера на сайте
Проверка должна отвечать не на вопрос «видит ли поисковик сайт вообще», а на вопрос «что происходит с конкретными важными URL».
Для одного документа удобно последовательно проверить:
| Проверка | Что хотим увидеть | Что требует внимания |
|---|---|---|
robots.txt | нужный URL разрешён | случайный Disallow |
| HTTP-ответ | ожидаемый 200 OK для рабочей страницы | 4xx, 5xx, ошибочный редирект |
| Sitemap | канонический важный URL присутствует | старые, закрытые или ошибочные адреса |
| Внутренние ссылки | до страницы можно дойти с других документов | URL фактически изолирован |
| Данные поисковика | робот знает страницу и может её загрузить | ошибка доступа или давно отсутствующий обход |
| Логи сервера | есть реальные запросы нужного бота | запросов нет либо сервер отвечает ошибкой |
Для Google отдельный URL можно исследовать через URL Inspection в Search Console, а общую картину запросов Googlebot — через Crawl Stats. В отчёте видны количество запросов, ответы сервера, время отклика и состояние хоста.
В Яндекс Вебмастере есть статистика обхода, проверка страницы и проверка ответа сервера. Это позволяет сопоставить последнее посещение робота, HTTP-код и доступность документа.
Серверные access-логи дают ещё один уровень проверки: они показывают сам HTTP-запрос. При этом один только User-Agent не всегда достаточен для идентификации настоящего поискового бота, поскольку его можно подделать.
Почему robots.txt не заменяет управление индексированием
Одна из наиболее частых ошибок — пытаться решить через robots.txt любую проблему появления URL в поиске.
Disallow управляет обходом: он говорит поддерживающему правило краулеру не запрашивать указанный путь. Это отличается от инструкции не включать документ в поисковый индекс.
Например, задача может быть такой:
User-agent: *
Disallow: /private-filter/
Здесь робот получает ограничение на обход пути /private-filter/.
Если же индексируемую HTML-страницу требуется исключить из Google, используется доступная самому роботу директива:
<meta name="robots" content="noindex">Критическая деталь: если одновременно запретить Googlebot доступ к URL через robots.txt, он может не загрузить документ и, соответственно, не увидеть noindex.
Для Яндекса также важно разделять запрет обхода и удаление документа из поиска. Поэтому перед редактированием robots.txt сначала определяют, что именно требуется: сократить ненужный обход, исключить страницу из индекса или исправить доступ к полезному документу.
Практический сценарий: новая страница существует, но робот её почти не посещает
Представим сайт с несколькими тысячами URL. Новая посадочная страница опубликована, открывается с кодом 200, но спустя время в инструментах поисковых систем видно, что робот посещает её редко.
Начинать с попытки «ускорить робота» преждевременно.
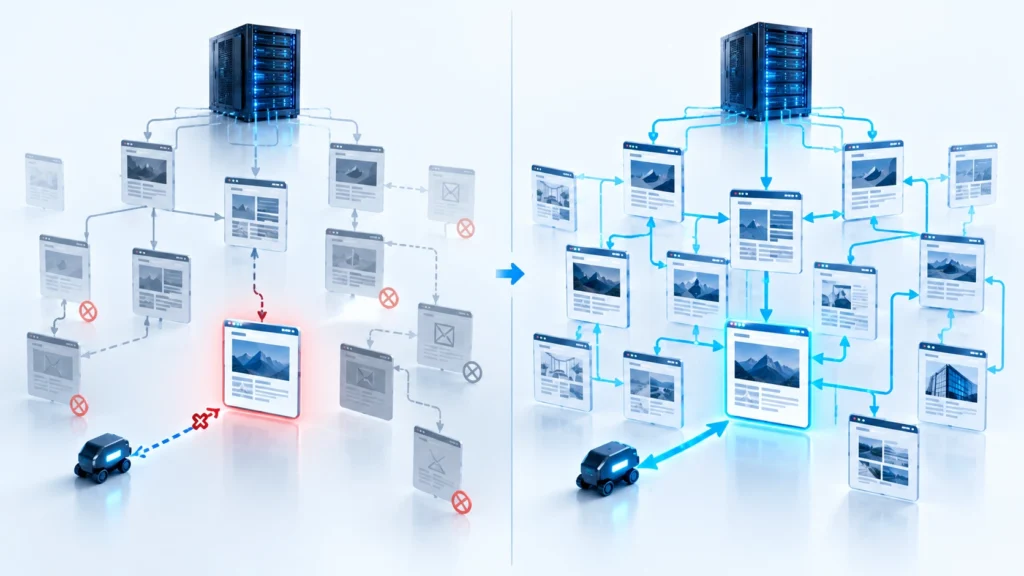
Сначала проверяем обнаружение. Если ссылка на страницу есть только в Sitemap, а в реальной структуре сайта документ ниоткуда не связан, стоит добавить релевантные внутренние переходы. Для поискового робота это одновременно дополнительный маршрут обнаружения и элемент структуры сайта.
Затем проверяем, не создаёт ли CMS большое количество параметрических URL, архивов, фильтров или других адресов без самостоятельной поисковой ценности. На крупных проектах такие пространства способны расходовать ресурсы обхода. Именно здесь становится уместным анализ того, как расходуется crawl budget сайта, а не попытка добиться максимального числа запросов робота любой ценой.
После этого проверяем сервер. Если при обходе значимой части сайта появляются 5xx, длительные ответы или длинные цепочки редиректов, поисковому краулеру приходится работать в менее стабильных условиях.
Ожидаемый результат исправления — не «робот стал приходить каждый день», а более практичная картина: важный URL нормально обнаруживается, разрешён для обхода, стабильно отдаёт корректный ответ и периодически появляется в данных обхода поисковой системы.
Что считать реальной проблемой краулинга
Не каждая редко посещаемая страница требует вмешательства. Поисковые системы самостоятельно определяют, какие URL и с какой частотой обходить, а на крупных сайтах распределяют ограниченные ресурсы между документами.
Повод для диагностики появляется, когда важные страницы системно не обнаруживаются или не загружаются, поисковик получает ошибки сервера, полезные разделы случайно закрыты в robots.txt, внутренние ссылки ведут через ненужные цепочки редиректов либо значительная часть обхода приходится на бесполезные комбинации URL.
И наоборот, увеличение количества запросов краулера само по себе не является SEO-результатом. Цель технической настройки — дать поисковой системе стабильный доступ к тем документам, которые действительно должны обнаруживаться и обрабатываться.
Если проблемы обхода являются частью более широкой картины — вместе с архитектурой сайта, технической индексацией, семантикой и посадочными страницами — их имеет смысл рассматривать внутри услуг SEO-продвижения сайта, а не оптимизировать частоту визитов робота как изолированный показатель.
Главный критерий простой: значимые URL должны быть обнаруживаемыми, доступными и технически понятными поисковой системе. Всё остальное — частота визитов конкретного бота, число запросов в сутки или размер очереди — имеет смысл оценивать только в контексте этой задачи.
FAQ
Когда обход страницы не приводит к появлению в поиске
Это автоматическая программа, которая переходит по известным поисковой системе URL и загружает их содержимое. Найденные данные затем могут быть обработаны поисковой системой для индексирования. Краулер также называют роботом, ботом или crawler.
Прямого правила «чаще обход — выше позиции» нет. Возможность своевременно обходить важные страницы необходима для обнаружения изменений, но ранжирование происходит на другом этапе. Поэтому частоту визитов робота нельзя использовать как самостоятельный показатель качества SEO.
Для отдельного URL используйте проверку URL в Google Search Console и проверку страницы или ответа сервера в Яндекс Вебмастере. Для общей картины полезны статистика сканирования поисковых систем и серверные access-логи, где видны запросы роботов и HTTP-коды ответов.
Sitemap помогает поисковой системе обнаружить URL, но не является приказом немедленно его скачать или проиндексировать. Нужно дополнительно проверить robots.txt, HTTP-ответ, внутренние ссылки, доступность сервера и отсутствие большого количества бесполезных или дублирующихся URL.
Такая комбинация может помешать поисковому роботу увидеть noindex. Для Google страница с noindex должна оставаться доступной краулеру, чтобы правило было прочитано. Поэтому сначала определите цель: запретить обход или исключить документ из поиска.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.