Поисковый робот не «просматривает сайт целиком» за один проход. Он работает с отдельными URL: узнаёт о них из ссылок, Sitemap и уже известных поисковой системе адресов, решает, что стоит запросить, обращается к серверу и получает ответ. Дальше загруженные данные могут пройти дополнительные этапы обработки — это уже не сам обход.
Для SEO здесь важна граница: обнаружение URL, загрузка страницы и её индексирование — разные события. Страница может быть известна поисковику, но ещё не загружена; может быть загружена, но не выбрана для индекса; может уже находиться в индексе и при этом переобходиться с разной частотой. Поэтому фраза «робот видит страницу» сама по себе мало что говорит о причине проблемы.
Как поисковый робот проходит от ссылки до содержимого страницы
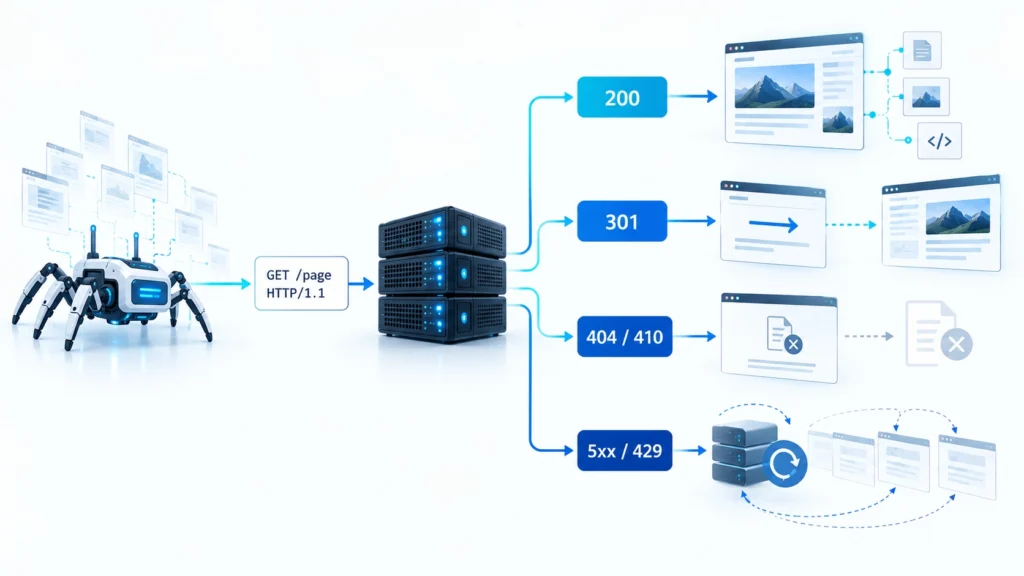
Обычно путь начинается с URL, который поисковая система уже знает или обнаружила в документе, Sitemap либо другой доступной ей структуре. Перед получением ресурса crawler учитывает правила обхода, затем отправляет HTTP-запрос серверу. Ответ сервера определяет, что произойдёт дальше.
200 OK позволяет получить содержимое. Постоянный редирект направляет запрос на другой адрес. 404 или 410 сообщает, что ресурса нет. Серверные 5xx и ограничения вроде 429 означают уже другую ситуацию: поисковая система видит проблемы с доступностью или нагрузкой.
Полученный HTML тоже не является финалом. Современная страница может зависеть от CSS, JavaScript и других ресурсов, а после получения или рендеринга поисковой системе ещё предстоит решить, какую версию документа считать основной и подходит ли страница для индекса.
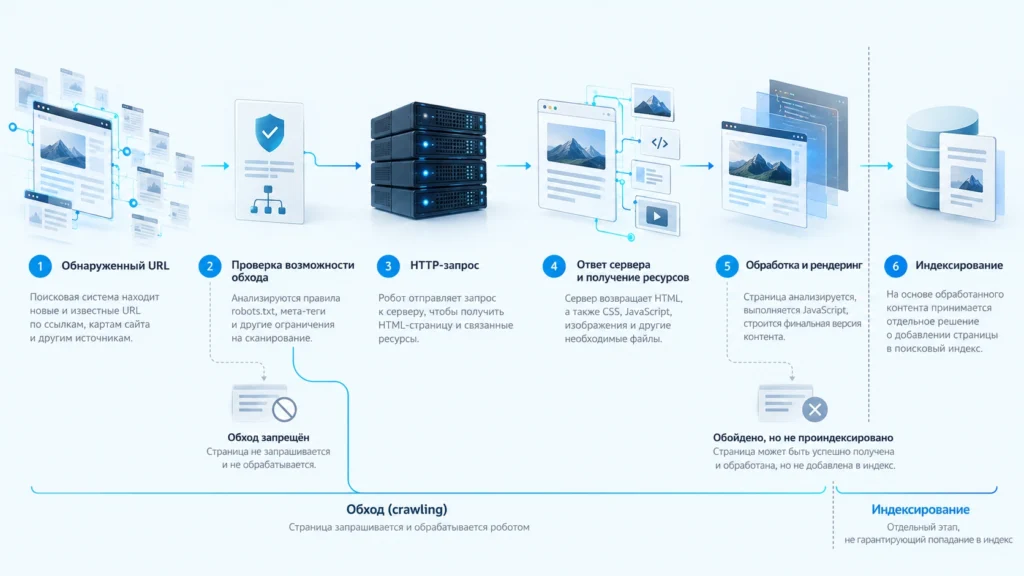
Для Google эта логика особенно заметна в документации по crawl budget: система учитывает как способность сервера выдерживать обход, так и потребность повторно получать конкретные URL. При замедлении сервера, 5xx или сигналах ограничения нагрузки интенсивность сканирования может уменьшаться. При этом Google отдельно подчёркивает, что не каждая просканированная страница обязательно индексируется.
На небольшом корпоративном сайте начинать диагностику с «не хватает crawl budget» обычно не стоит. Google относит отдельное управление бюджетом обхода прежде всего к очень крупным, быстро меняющимся сайтам и проектам с большим количеством обнаруженных, но не проиндексированных URL. Сначала полезнее проверить доступность конкретных страниц и структуру сайта.
Что проверять, если робот редко заходит на важные страницы
Надёжнее идти не от предположения «поисковик меня не любит», а по цепочке технических фактов.
| Проверка | Что она показывает | На что смотреть |
|---|---|---|
| Внутренние ссылки | Может ли робот естественно обнаружить URL | ссылка доступна в обычном HTML, нет тупиковой страницы |
| Sitemap | Передаётся ли URL поисковой системе явно | актуальный URL, корректный ответ сервера, правдивый lastmod |
robots.txt | Разрешён ли обход | нет случайного Disallow для нужного пути |
| HTTP-ответ | Что реально получает crawler | 200, корректный редирект либо ожидаемый 404/410 |
| Search Console / Вебмастер | Что зафиксировала сама поисковая система | дата обхода, ошибки получения, состояние URL |
| Access-log сервера | Были ли фактические запросы | время, URL, код ответа, user-agent, частота |
Начинать имеет смысл с одной конкретной страницы, а не со всего домена. Если URL отсутствует во внутренней навигации, не попал в Sitemap и нигде не упоминается, проблема обнаружения гораздо вероятнее, чем загадочная «блокировка робота».
Отдельно для Яндекса полезен разбор Краулинг и Яндекс: диагностировать нужно именно результат обхода конкретных адресов, а не ориентироваться только на количество страниц в выдаче. Для Google тема googlebot smartphone важна там, где мобильная версия сайта отличается по содержимому или доступности ресурсов.
Robots.txt управляет обходом, но не заменяет удаление из поиска
Одна из самых частых ошибок — воспринимать robots.txt как универсальный запрет индексации.
Правило Disallow запрещает соответствующему роботу запрашивать URL. Но если адрес уже известен поисковой системе из ссылок или других источников, одной блокировки обхода недостаточно, чтобы считать вопрос появления URL в поиске решённым. Google прямо предупреждает, что заблокированный URL в отдельных случаях всё равно может отображаться без содержательного сниппета. Яндекс также указывает, что запрещённые в robots.txt страницы могут участвовать в поиске.
Если задача состоит именно в исключении доступной страницы из индекса, поисковой системе обычно необходимо иметь возможность получить документ и увидеть noindex. Закрывать такой URL одновременно через robots.txt — значит мешать роботу прочитать эту директиву.
Условно безопасная минимальная конфигурация для разрешения обхода выглядит так:
User-agent: *
Disallow:

Sitemap: https://example.com/sitemap.xml
Это не готовый robots.txt для любого проекта. На реальном сайте правила зависят от структуры URL, фильтров, технических разделов, поиска, параметров и используемой CMS.
Краулинг на практике стоит рассматривать шире одного файла: робот работает с целой системой URL, ссылок, ответов сервера и ресурсов страницы.
Практический сценарий: новая страница существует, но робот до неё почти не доходит
Представим новый материал WordPress. Он опубликован, возвращает 200 OK и открыт в robots.txt, но спустя время по данным поисковой системы его обход либо не зафиксирован, либо происходит заметно позже других материалов.
Первое, что я проверяю, — не дату публикации, а путь обнаружения. Есть ли обычная внутренняя ссылка на материал со страницы, которую поисковый робот регулярно посещает? Попал ли URL в актуальный Sitemap? Нет ли ошибочного canonical на другой документ?
Затем проверяется сам запрос. Если страница отдаёт цепочку из нескольких перенаправлений, периодические 5xx, защитную заглушку или иной ответ для crawler, наличие корректной HTML-страницы в браузере владельца ещё ничего не доказывает.
После этого уже имеет смысл смотреть данные поисковых систем. В Google Search Console статистика сканирования показывает количество запросов, ответы сервера и проблемы доступности на уровне сайта. В Яндекс Вебмастере статистика обхода содержит посещённые роботом URL, дату посещения и полученный HTTP-код.
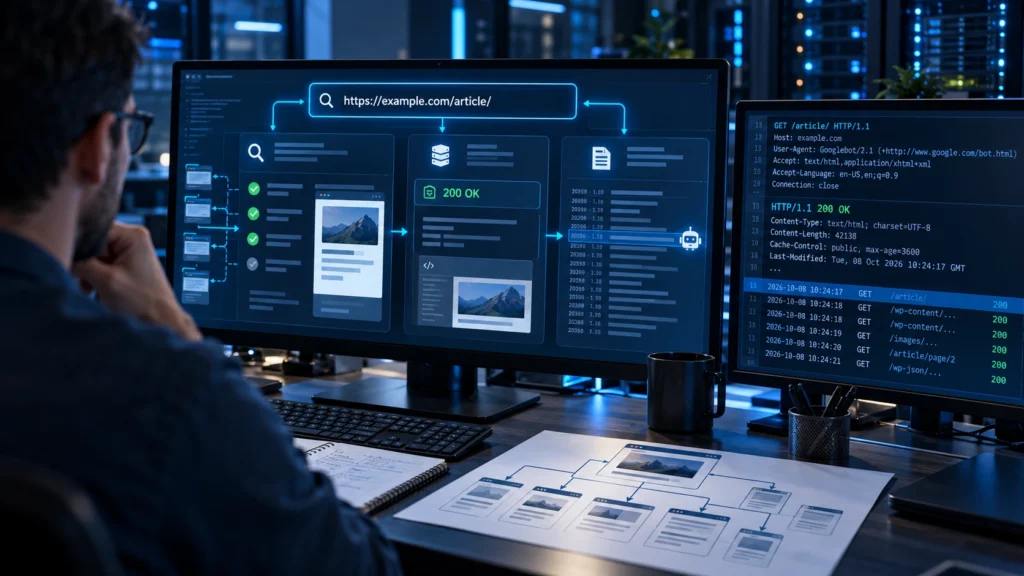
Если все три уровня сходятся — URL обнаружен, разрешён, стабильно отвечает и робот действительно его получает — техническая часть обхода в основном подтверждена. Отсутствие страницы в индексе после этого уже нельзя автоматически списывать на crawler: нужно переходить к диагностике индексирования, canonical, дублей и качества самого документа.
Ошибки, которые создают лишнюю работу поисковым роботам
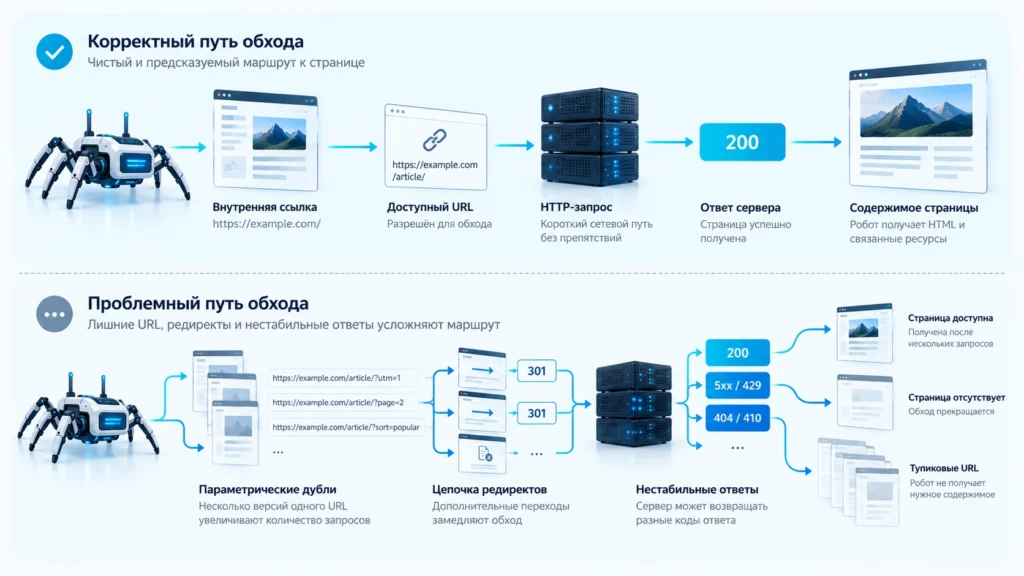
Одна типичная группа проблем — бесконечное размножение адресов: фильтры, сортировки, календари, внутренний поиск, параметры и разные URL одного содержимого. Поисковой системе приходится обнаруживать и переоценивать множество адресов, которые владельцу сайта фактически не нужны как самостоятельные страницы.
Вторая группа — нестабильный сервер. Если сайт периодически отвечает 5xx, резко замедляется или ограничивает запросы через 429, робот получает сигнал, что интенсивность обращений стоит уменьшить. Поэтому «заставить робота заходить чаще» при перегруженном сервере — противоположность правильной диагностики.
Третья — удалённые страницы, которые продолжают вести себя как существующие. Для действительно удалённого URL корректный 404 или 410 информативнее страницы-заглушки с ответом 200. Ещё хуже, когда ненужный URL продолжает генерироваться во внутренних ссылках: робот снова и снова получает сигнал, что адрес стоит проверить.
Если страницы не обходятся 2026, искать одну универсальную причину не стоит. Один URL может быть закрыт правилом, второй потерян из структуры, третий падать на серверной ошибке, а четвёртый — просто иметь низкую потребность в повторном обходе.
Как понять, что проблема действительно исправлена
Проверка заканчивается не после изменения настройки, а после подтверждения результата. Для отдельного URL нужны три простых факта: он доступен роботу, сервер отвечает ожидаемым статусом, а поисковая система после изменения смогла получить страницу.
Для группы страниц дополнительно смотрят динамику: исчезли ли массовые ошибки, перестали ли генерироваться ненужные URL, не осталось ли внутренних ссылок на удалённые адреса и не создаёт ли сайт новые дубли вместо исправленных.
При этом частота обхода сама по себе не является показателем позиции. Яндекс прямо отмечает, что рост или снижение количества посещённых роботом страниц не означает автоматически изменение индексирования или ранжирования. Google также рассчитывает частоту обхода динамически, исходя из доступной мощности сайта и собственной потребности повторно получать контент.
Поэтому задача SEO-специалиста — не добиваться максимального числа запросов от робота. Нормальное состояние проще: важные URL легко обнаруживаются, не закрыты случайными правилами, стабильно отдаются сервером и не теряются среди тысяч технических дублей. Тогда поисковая система получает возможность обходить сайт без искусственных препятствий, а вопросы индексирования и позиций можно анализировать уже отдельно.
Если проблемы обхода повторяются сразу на десятках или сотнях URL, разовой проверкой страницы уже не обойтись: SEO-продвижение сайта с контролем обхода должно связывать внутренние ссылки, Sitemap, robots.txt, HTTP-ответы и серверные логи в одну систему диагностики.
FAQ
Когда робот видит URL, но страница всё равно не появляется в поиске
Это автоматическая программа поисковой системы, которая переходит по известным ей URL и загружает доступные ресурсы сайта. Сам факт посещения страницы роботом ещё не означает, что она обязательно попадёт в поисковый индекс.
Доступность для обхода — техническое условие, необходимое для получения поисковой системой содержимого страницы, но не гарантия высоких позиций. Если робот не может получить страницу, возможности поисковой системы обработать её ограничиваются; после успешного обхода остаются отдельные этапы обработки, индексирования и ранжирования.
Для Google используйте проверку URL и статистику сканирования Search Console, а для Яндекса — данные об обходе и проверку страницы в Яндекс Вебмастере. На собственном сервере наиболее прямое подтверждение дают access-логи, если в них сохраняются запросы роботов.
Robots.txt определяет возможность обхода, но не заставляет поисковую систему немедленно посетить URL. Проверьте обнаружение страницы через внутренние ссылки и Sitemap, стабильность сервера, редиректы, дубли и то, известен ли URL поисковой системе.
Сначала исключите техническую блокировку и ошибки ответа сервера, затем проверьте внутренние ссылки и Sitemap. После исправления можно запросить повторный обход доступным инструментом поисковой системы, но точное время посещения и включение страницы в индекс не гарантируются.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.