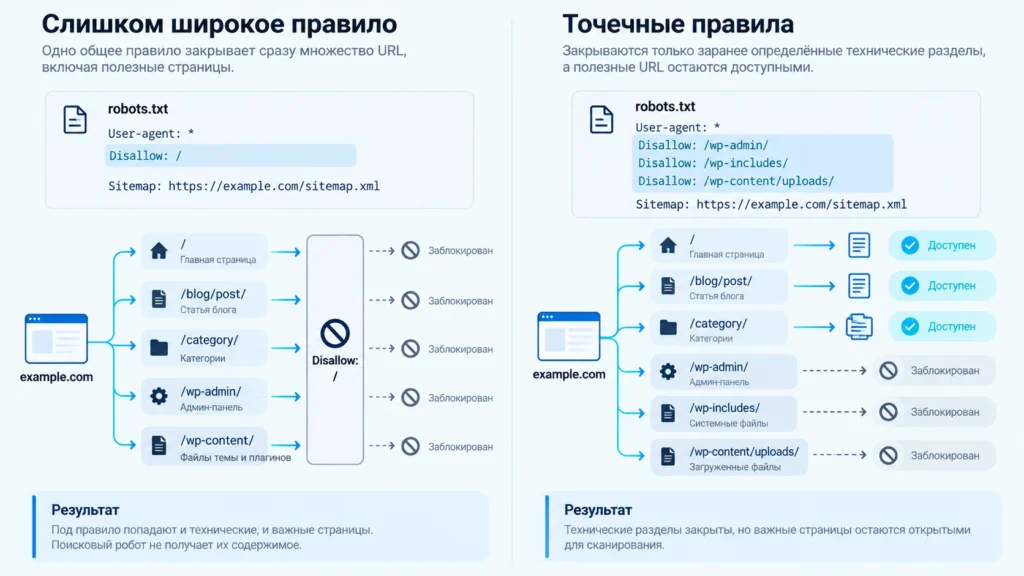
В WordPress robots.txt нужен не для «улучшения SEO одной директивой», а для конкретной технической задачи: сообщить поисковым роботам, какие URL им не следует сканировать. Это позволяет отсечь заведомо ненужные маршруты, но ошибка в одном слишком широком Disallow способна одновременно закрыть целый раздел сайта.
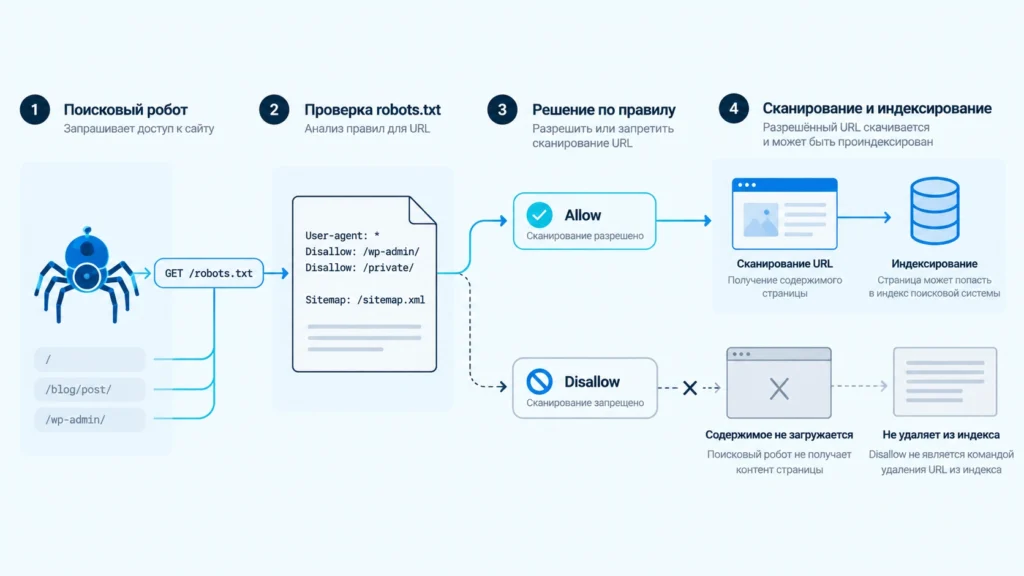
Главное различие здесь — между обходом и индексированием. Google прямо указывает, что содержимое запрещённой к сканированию страницы он прочитать не сможет, но сам URL всё равно может попасть в результаты поиска без сниппета. Яндекс также предупреждает, что закрытая через robots.txt страница способна участвовать в поиске. Поэтому использовать Disallow как замену noindex нельзя.
Как WordPress robots.txt формируется на реальном сайте
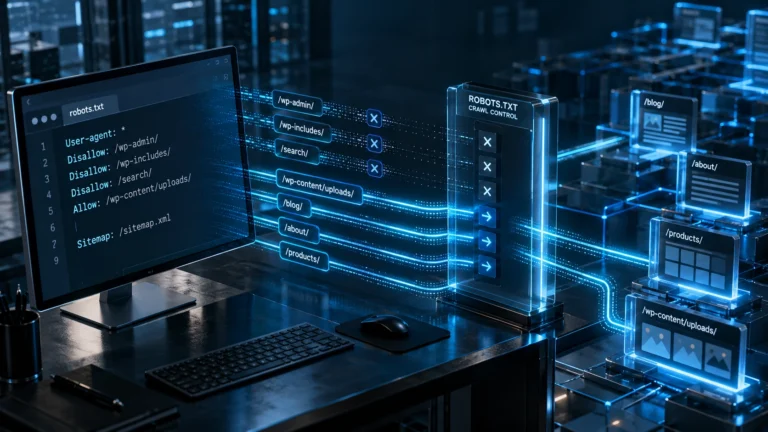
WordPress умеет отдавать /robots.txt динамически. В актуальном ядре базовый ответ содержит группу User-agent: *, запрет административного каталога и разрешение для wp-admin/admin-ajax.php. Содержимое проходит через фильтр robots_txt, поэтому плагины, тема или собственный код могут его изменить.
Если встроенные XML Sitemap WordPress включены и сайт считается публичным, ядро также добавляет адрес индекса Sitemap в robots.txt. Поэтому бессмысленно начинать настройку с копирования «идеального файла» из чужого проекта: сначала нужно посмотреть, что фактически отдаёт именно ваш сайт.
Базовый ответ может выглядеть так:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/wp-sitemap.xml
Конкретный адрес Sitemap может отличаться, например если его формирует SEO-плагин.
Отдельно проверьте настройку Настройки → Чтение → Попросить поисковые системы не индексировать сайт. Начиная с WordPress 5.3 ядро не закрывает весь сайт через Disallow: /, а использует robots meta для ограничения индексирования. Это ещё одна причина не путать /robots.txt и метатег robots: они решают разные задачи.
Что стоит закрывать, а что лучше оставить доступным
Рабочий принцип простой: закрывайте только те URL, сканирование которых действительно не даёт поисковой системе полезного результата.
Для WordPress кандидатами могут быть отдельные технические маршруты, бесконечные комбинации параметров, внутренний поиск или служебные страницы — но только после анализа структуры конкретного проекта. Не существует универсального списка из двадцати Disallow, который одинаково полезен всем сайтам.
Особенно осторожно нужно относиться к CSS, JavaScript, изображениям и другим ресурсам, участвующим в отображении страницы. Запрет ресурса оправдан только тогда, когда вы понимаете, зачем он закрывается и не требуется ли поисковому роботу для корректной обработки публичной страницы.
Если нужно глубже разобрать сами директивы robots.txt, настройку и типовые ошибки, это отдельная задача: здесь важнее понять, какие шаблоны URL можно безопасно исключить именно на WordPress-сайте.
Для Google в robots.txt поддерживаются user-agent, allow, disallow и sitemap; например, поле crawl-delay Google не поддерживает. Яндекс дополнительно документирует Clean-param, предназначенный для работы с определёнными параметрами URL. Это значит, что файл нужно проектировать с учётом конкретных поисковых систем, а не собирать из случайных директив разных ботов.
Когда robots.txt вообще не является правильным инструментом
Есть три особенно частых случая.
Если страницу нужно удалить из результатов поиска, одного Disallow недостаточно. Роботу может потребоваться доступ к странице, чтобы увидеть noindex.
Если раздел содержит конфиденциальные данные, robots.txt тоже не является защитой. Файл публичен, а соблюдение его инструкций зависит от робота. Для закрытых данных нужна аутентификация и реальное ограничение доступа.
Если проблема состоит в том, что страница должна оставаться доступной роботу, но не индексироваться, требуется как настроить meta robots без SEO-ошибок, а не новый запрет в robots.txt.
Как проверить WordPress robots.txt до изменения
Начинайте не с редактирования, а с диагностики.
Откройте:
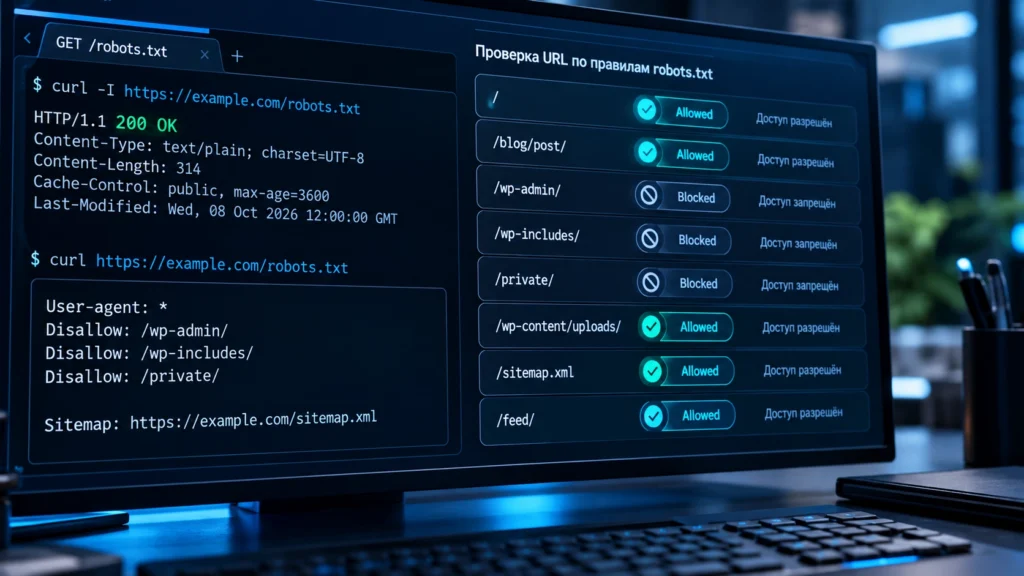
https://example.com/robots.txtПроверьте фактическое содержимое и HTTP-ответ. Для нормально доступного файла ожидается успешный ответ сервера. У Google обработка ошибок имеет отдельную логику: большинство ответов 4xx, кроме 429, трактуются как отсутствие действующего robots.txt и, следовательно, как отсутствие ограничений обхода. Ошибки 5xx обрабатываются иначе и при проблемах с получением файла способны временно повлиять на сканирование сайта.
Дальше не проверяйте правила «на глаз». Возьмите реальные адреса:
/
 /category/example/
 /wp-admin/
 /?s=test
 /product/example/
 /wp-content/example.css
Для каждого определите ожидаемое состояние: разрешён или запрещён. Такой список быстро обнаруживает опасное правило вроде:
Disallow: /product/если /product/ на самом деле содержит посадочные страницы, которые должны сканироваться.
Проверка в Google и Яндексе
В Google Search Console используется отдельный отчёт robots.txt. Он показывает найденные файлы, время последнего получения, предупреждения и ошибки; при необходимости из отчёта можно запросить повторное сканирование файла. Отчёт доступен для свойств соответствующего уровня, а не для URL-prefix property с путём.
В Яндекс Вебмастере инструмент «Анализ robots.txt» позволяет проверить содержимое файла и отдельно протестировать конкретный URL. Там же хранится история версий: Яндекс указывает срок истории до шести месяцев и максимум 100 сохранённых версий.
Важно проверить не только, принимает ли сервис синтаксис. Главный вопрос другой: совпадает ли результат проверки каждого шаблона URL с вашей задачей.
| Проверка | Нормальный результат | Повод разбираться |
|---|---|---|
/robots.txt | файл доступен и отдаёт ожидаемые правила | 5xx, неожиданный редирект, чужая версия файла |
| Основные статьи и услуги | обход разрешён | попали под широкий Disallow |
| Технические URL | совпадают с вашим планом ограничения | робот получает тысячи ненужных комбинаций |
| CSS/JS важных страниц | необходимые ресурсы доступны | страница не может нормально обрабатываться |
| Sitemap | указан актуальный адрес, если он нужен | ссылка ведёт на старую или несуществующую карту |
Практический сценарий: закрыли лишнее вместе с полезным
Представим магазин на WordPress, где решили сократить обход URL с параметрами и добавили:
User-agent: *
Disallow: /*?
На первый взгляд решение кажется логичным: все адреса с ? закрыты.
Проблема появляется, когда параметры используются не только для мусорных комбинаций. Через них могут работать полезные страницы, элементы пагинации, фильтры, языковые варианты или другие маршруты, которые проект сознательно отдаёт поисковику.
Безопаснее сначала разбить URL с параметрами на группы:
?utm_source=
?s=
?orderby=
?filter=
После этого нужно определить судьбу каждой группы: должна ли она сканироваться, индексироваться, канонизироваться, редиректить или вообще перестать генерироваться.
То есть robots.txt используется в конце диагностики, а не вместо неё.
На проектах, где одновременно накопились проблемы с индексированием, дублями, техническими шаблонами и архитектурой, одна правка robots.txt обычно не решает задачу целиком. В таком случае услуги по SEO-продвижению сайта уместны как комплексная работа: правила обхода проверяются вместе с индексированием, внутренней структурой и фактическими шаблонами URL, а не изолированно.
Как менять robots.txt без риска для важных страниц
Хорошая настройка обычно короче плохой. Каждая директива должна отвечать на вопрос: какую конкретную группу URL мы исключаем из обхода и почему?
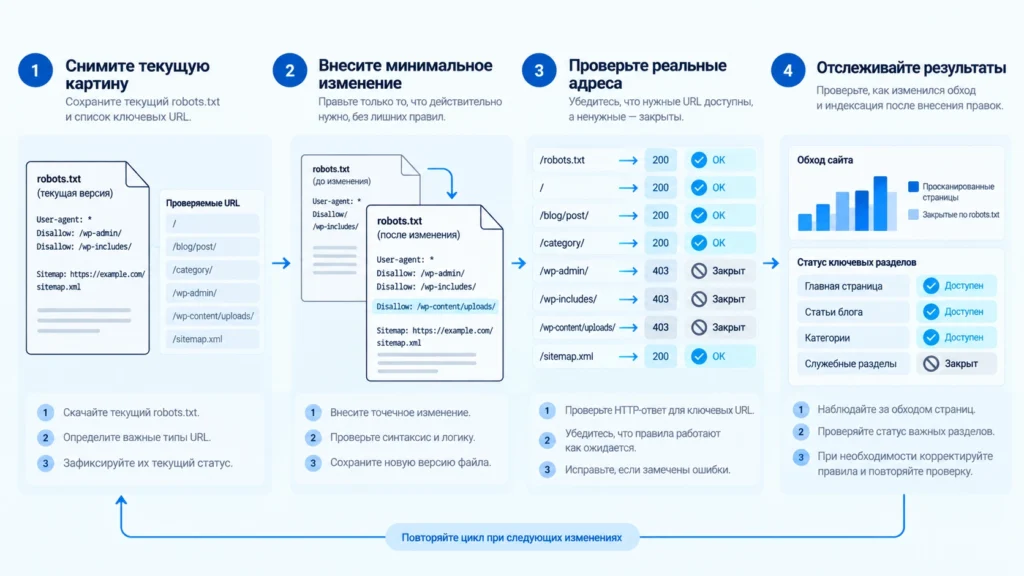
Сначала зафиксируйте текущую версию файла. Затем соберите список типовых URL и данные краула. Проверьте, какие разделы действительно создают бесполезные запросы поисковых роботов. Только после этого меняйте правила.
Если robots.txt формируется самим WordPress, его можно модифицировать через фильтр robots_txt:
add_filter( 'robots_txt', function ( $output, $public ) {
    if ( ! $public ) {
        return $output;
    }

    $output .= "Disallow: /internal-search/\n";

    return $output;
}, 20, 2 );
Такой код — только пример механизма. Путь /internal-search/ нельзя переносить на реальный сайт без проверки его структуры.
Если файл формируется SEO-плагином или физическим файлом на сервере, редактировать нужно тот источник, который действительно определяет ответ /robots.txt. Поэтому после любого изменения снова откройте публичный URL файла: наличие правильной строки в настройках плагина ещё не доказывает, что робот получает именно её.
Чек-лист перед сохранением
Перед публикацией новой версии robots.txt достаточно ответить на несколько вопросов:
- Доступен ли сам
/robots.txtбез серверной ошибки? - Понятна ли задача каждого
Disallow? - Проверены ли реальные URL, попадающие под правило?
- Не закрыты ли важные страницы и необходимые для них ресурсы?
- Не пытаетесь ли вы использовать robots.txt вместо
noindex? - Актуален ли указанный Sitemap?
- Совпадает ли результат проверки в Google и Яндексе с ожидаемой логикой?
Не оценивайте robots.txt по количеству директив. Хороший файл может состоять из нескольких строк. Его качество определяется тем, насколько точно правила соответствуют структуре сайта и не мешают обходу страниц, которые должны находиться в поиске.
После изменения контролируйте не только сам файл, но и последствия: доступность ключевых URL, статистику обхода, состояние индексирования и серверные логи при необходимости. robots.txt — это технический регулятор доступа поисковых роботов, а не самостоятельный фактор, который гарантирует рост позиций.
Практика
Как безопасно проверить и настроить robots.txt в WordPress
Сохраните текущий robots.txt
Откройте /robots.txt, сохраните его содержимое и зафиксируйте HTTP-статус, чтобы при ошибке можно было восстановить исходное состояние.
Разберите шаблоны URL
Выделите индексируемые страницы, технические разделы, внутренний поиск, параметры и другие группы URL и определите, какие из них действительно не нужно сканировать.
Проверьте существующие запреты
Для каждого Disallow протестируйте реальные URL и убедитесь, что правило не перекрывает страницы, CSS, JavaScript или другие ресурсы, необходимые для корректного обхода и отображения сайта.
Внесите минимальное изменение
Изменяйте только те правила, для которых есть понятная задача; не добавляйте массовые запреты каталогов и параметров «на всякий случай».
Проверьте поисковыми инструментами
Проверьте файл и выбранные URL через отчёт robots.txt Google Search Console и инструмент анализа robots.txt Яндекс Вебмастера.
Проконтролируйте результат
После внедрения следите за обходом и индексированием важных шаблонов URL и убедитесь, что новые правила не создали нежелательных блокировок.
FAQ
Где robots.txt действительно помогает, а где создаёт проблему
Нет, Disallow запрещает сканирование URL, но сам по себе не гарантирует исключение адреса из результатов поиска. Поисковик может знать URL по внешним или внутренним ссылкам и показывать его без содержимого страницы. Для исключения из индекса робот обычно должен получить страницу и увидеть noindex, либо URL должен быть удалён или защищён другим подходящим способом.
Не обязательно. WordPress умеет формировать ответ для /robots.txt программно, а его содержимое можно изменять через фильтр robots_txt. Поэтому сначала нужно открыть фактический /robots.txt сайта и определить, что именно сейчас получает поисковый робот.
WordPress по умолчанию добавляет запрет для административного каталога и отдельно разрешает admin-ajax.php. Самостоятельно усиливать это правило без причины не требуется: сначала проверьте текущий ответ /robots.txt и убедитесь, что дополнительные запреты не затрагивают ресурсы, необходимые публичной части сайта.
Это допустимый и полезный способ сообщить поисковым системам адрес карты сайта. Ядро WordPress при включённых встроенных XML Sitemap добавляет ссылку на индекс Sitemap в генерируемый robots.txt; Google и Яндекс также поддерживают директиву Sitemap.
Проверьте HTTP-ответ /robots.txt, несколько важных и запрещённых URL, отчёт robots.txt в Google Search Console и анализатор в Яндекс Вебмастере. После этого контролируйте обход и индексирование: отсутствие синтаксической ошибки ещё не означает, что логика правил верна.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.