Самая частая ошибка в работе с meta robots начинается с неверного вопроса: «Как закрыть эту страницу от робота?». Для HTML-страницы тег решает другую задачу — сообщает поисковой системе, можно ли включать документ в индекс, обрабатывать ссылки и использовать его содержимое при формировании поискового результата.
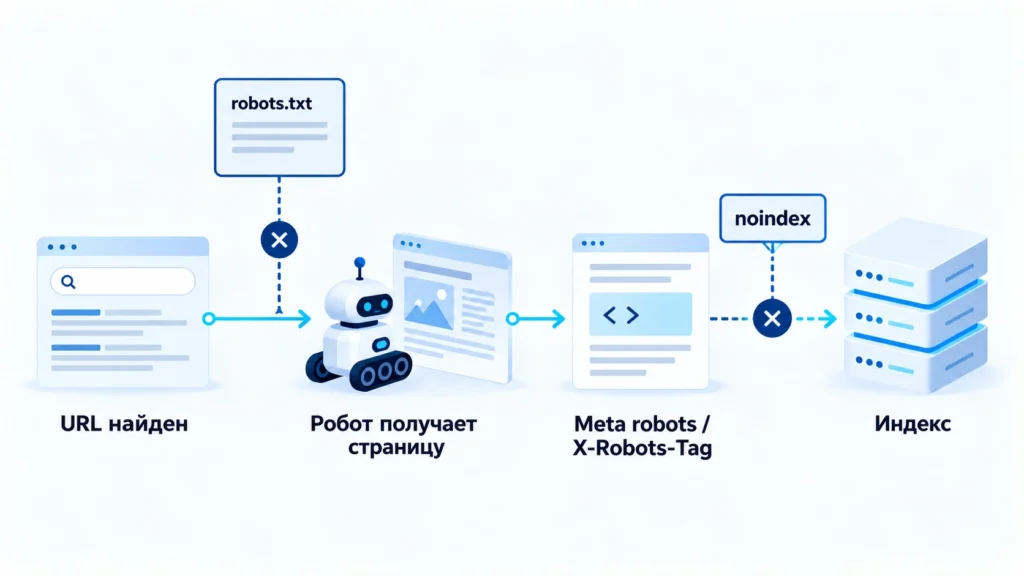
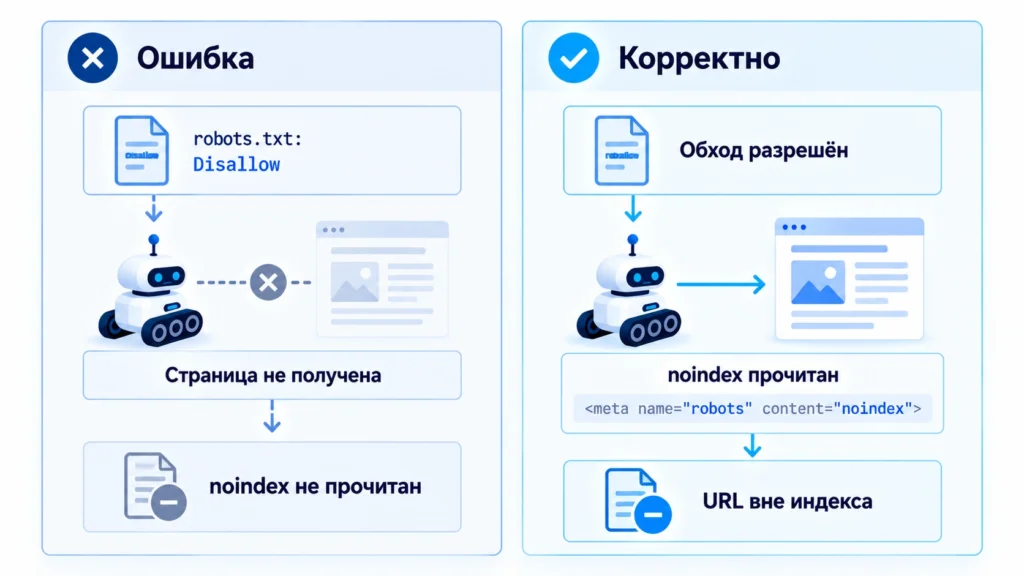
Поэтому noindex и запрет в robots.txt нельзя считать взаимозаменяемыми. Если нужно убрать страницу из результатов поиска, робот должен иметь возможность получить URL и прочитать запрет индексации. Если сначала запретить ему запрос страницы через robots.txt, директива внутри HTML может остаться для него невидимой.
Именно это различие нужно проверять первым, когда после запуска сайта страница неожиданно выпадает из индекса или, наоборот, продолжает появляться в поиске.
Где заканчивается Meta robots и начинается robots.txt
В обычной HTML-странице директива выглядит так:
<meta name="robots" content="noindex">Она сообщает поддерживающему её поисковику, что страницу не следует показывать в результатах поиска. При этом URL остаётся технически доступным: браузер, пользователь и поисковый робот по-прежнему могут его запросить.
Для ограничения самого сканирования используется другой механизм — robots.txt. Поэтому полезно разделять три разные задачи:
| Задача | Основной механизм |
|---|---|
| Не показывать страницу в поиске | noindex |
| Ограничить обращения поискового робота к URL | robots.txt |
| Закрыть конфиденциальный документ от посторонних | авторизация или контроль доступа |
| Перенести старый URL на новый | HTTP-редирект |
| Объединить сигналы похожих URL | rel="canonical" |
Если задача связана именно с ограничением сканирования разделов, отдельно нужно рассматривать robots txt seo. Meta robots начинает работать только тогда, когда поисковик смог получить документ или его HTTP-заголовок.
Какие директивы Meta robots действительно нужны
Для большинства сайтов достаточно понимать несколько значений.
noindex запрещает показывать страницу в поисковой выдаче после обработки директивы поисковиком.
<meta name="robots" content="noindex">nofollow сообщает роботу не переходить по ссылкам этой страницы:
<meta name="robots" content="nofollow">Их можно объединить:
<meta name="robots" content="noindex, nofollow">Значение none эквивалентно комбинации noindex, nofollow.
Обратные директивы index и follow обычно указывать не требуется: разрешающее поведение используется по умолчанию. Поэтому такой код:
<meta name="robots" content="index, follow">чаще служит явным указанием настройки, чем необходимым техническим условием индексирования.
У Google есть и более узкие правила управления представлением страницы: nosnippet, max-snippet, max-image-preview, max-video-preview, notranslate, unavailable_after. Они относятся не к повышению позиций, а к тому, какую часть контента поисковая система может показывать в результатах.
Отдельный нюанс — noarchive. Google больше не использует эту директиву для управления ссылкой на сохранённую копию, поскольку соответствующая функция поиска удалена. Яндекс по-прежнему перечисляет noarchive среди поддерживаемых директив. Поэтому нельзя автоматически считать набор поддерживаемых значений одинаковым у всех поисковых систем.
Meta robots и X-Robots-Tag решают одну задачу разными способами
Для HTML обычно удобен тег в <head>:
<head>
    <meta name="robots" content="noindex">
</head>
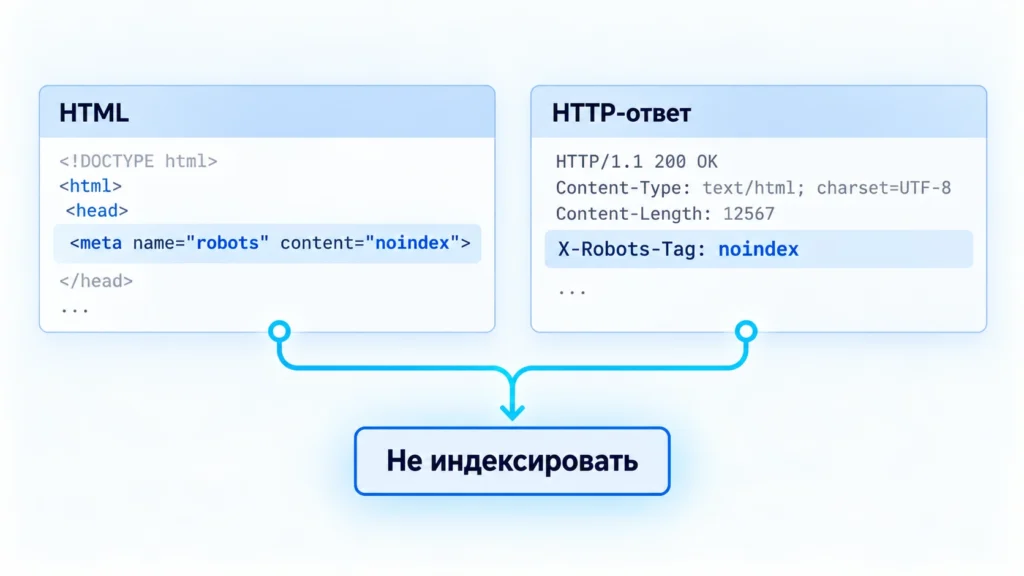
Но директиву можно вернуть и непосредственно в HTTP-ответе:
HTTP/1.1 200 OK
Content-Type: text/html
X-Robots-Tag: noindex
Поисковый робот может получить запрет индексирования в обоих местах. Поэтому при диагностике недостаточно открыть исходный код и убедиться, что там нет noindex.
Например, HTML может выглядеть совершенно нормально:
<meta name="robots" content="index, follow">а сервер одновременно возвращать:
X-Robots-Tag: noindexВ такой ситуации проблема находится не в шаблоне страницы, а в конфигурации сервера, прокси, приложения или другого слоя, который формирует заголовки.
X-Robots-Tag особенно полезен для ресурсов, в которых HTML-тега вообще нет: например PDF или изображения.
Как проверить Meta robots без ложных выводов
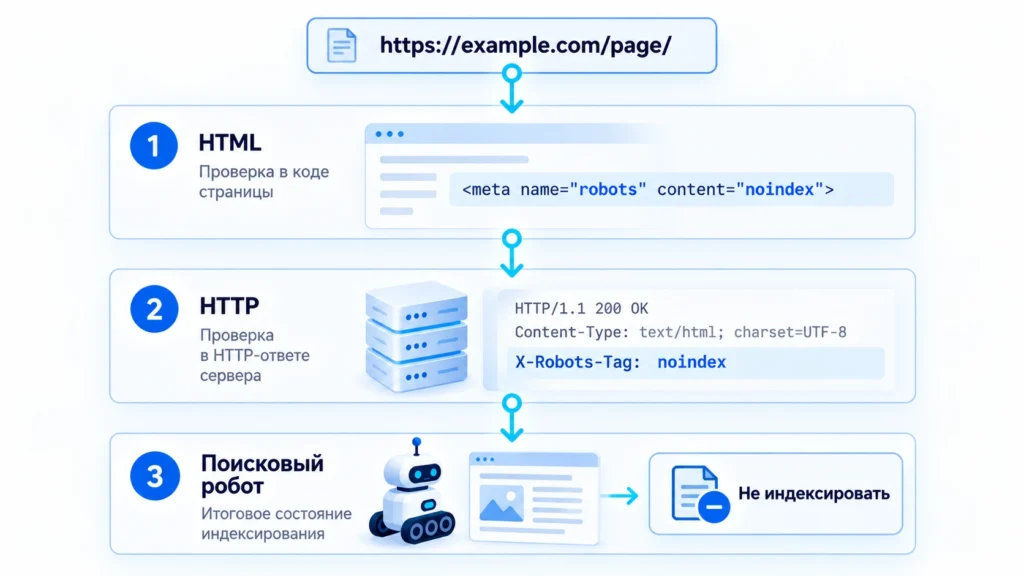
Проверка начинается не с поисковой выдачи, а с самого URL.
Сначала нужно открыть исходный HTML и найти:
name="robots"Затем отдельно проверить специализированные теги вроде:
<meta name="googlebot" content="noindex">или:
<meta name="yandex" content="noindex">После HTML нужно проверить HTTP-ответ. На сервере это удобно сделать, например, так:
curl -I https://example.com/page/В ответе ищут X-Robots-Tag и одновременно контролируют HTTP-код, редиректы и конечный URL.
Следующий уровень — краулер. Он позволяет увидеть проблему не на одной странице, а сразу на всём шаблоне: например, noindex может случайно появиться на сотнях записей одного типа.
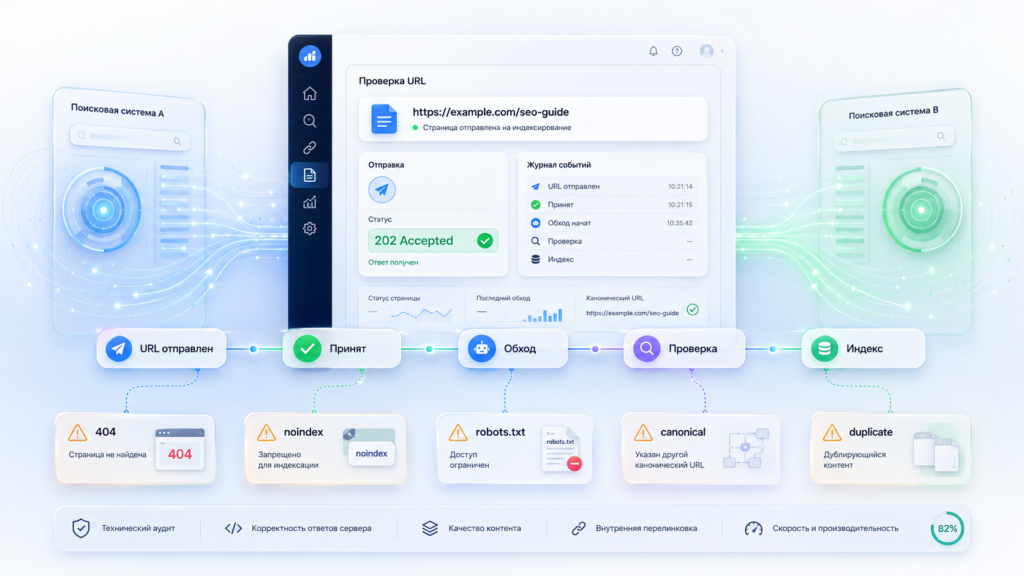
Только после технической проверки стоит смотреть состояние URL в поисковой системе. Google Search Console показывает, какую версию страницы знает Google, позволяет провести live-проверку доступности и увидеть проблемы индексирования. В Яндекс Вебмастере для аналогичной диагностики используется проверка страницы.
Важно сравнивать данные поисковой системы с текущим состоянием сайта. Если noindex снят сегодня, сохранённые данные о последнем обходе ещё могут показывать старую конфигурацию.
Как исправлять Meta robots и не создавать новый конфликт
Перед изменением нужно определить цель конкретного URL.
Если страница должна участвовать в поиске, с неё убирают нежелательный noindex, но одновременно проверяют, что она доступна для обхода, возвращает корректный ответ и не содержит другого запрета в X-Robots-Tag.
Если страница должна оставаться доступной пользователю, но не должна попадать в выдачу, обычно оставляют возможность её обхода и используют:
<meta name="robots" content="noindex">Если нужно закрыть от сканирования технический раздел, задача уже относится к robots txt.
Если URL окончательно переехал на другую страницу, noindex обычно не заменяет 301 редирект: это разные механизмы с разной задачей.
Для дублей также не стоит автоматически использовать noindex. Если требуется показать поисковой системе предпочтительную версию похожих страниц и консолидировать сигналы, для этого существует rel="canonical". Google отдельно не рекомендует использовать noindex только для того, чтобы заставить систему выбрать другой canonical URL.
Отдельно проверьте WordPress
На WordPress источник директивы не всегда находится непосредственно в шаблоне.
Настройка «Попросить поисковые системы не индексировать сайт» в разделе чтения влияет на robots meta сайта. В актуальном WordPress генерация директив также реализована через механизм wp_robots.
Поэтому после переноса staging-сайта в production недостаточно проверить один SEO-плагин. Нужно убедиться, что глобальная настройка публичности сайта возвращена в рабочее состояние, а итоговый HTML действительно не содержит неожиданного noindex.
Практический сценарий: сайт открыт, а страницы остаются noindex
Представим типовую ситуацию: проект разрабатывался на публичном тестовом домене, где индексирование было отключено. После запуска страницы доступны пользователям, sitemap работает, ссылки открываются, но новые URL не появляются в поиске.
Первый шаг — посмотреть исходный код одной проблемной страницы. Если там присутствует:
<meta name="robots" content="noindex, nofollow">нужно определить источник директивы: глобальная настройка CMS, SEO-модуль, тема или пользовательский код.
После исправления проверяется не только эта страница, но и несколько URL разных типов: главная, обычная запись, статическая страница, рубрика или другой индексируемый шаблон проекта.
Далее проверяются HTTP-заголовки. Это исключает ситуацию, когда HTML уже исправлен, но сервер продолжает передавать:
X-Robots-Tag: noindexПосле этого нужно проверить, не закрыт ли тот же URL в robots.txt. Для снятия noindex это особенно важно: поисковик должен снова получить страницу и увидеть обновлённое состояние.
Последний этап — live-проверка URL в инструментах поисковых систем и контроль после повторного обхода. Само удаление noindex не означает немедленного появления страницы в выдаче и тем более не гарантирует конкретную позицию. Оно лишь устраняет технический запрет на индексирование.
Ошибки, из-за которых Meta robots работает не так, как ожидалось
Одновременно Disallow и noindex. Роботу запрещают получать URL, а затем ожидают, что он обработает тег внутри этого URL.
Проверка только HTML. noindex может приходить через X-Robots-Tag, поэтому просмотр исходного кода не всегда завершает диагностику.
Глобальный noindex после переноса staging. Особенно опасен на CMS, где одна настройка может затронуть большую часть сайта.
Попытка закрыть секретные данные. Robots meta — не механизм безопасности. URL остаётся доступным любому пользователю, который знает адрес. Для приватной информации нужен контроль доступа.
Использование noindex вместо canonical. При похожих или дублирующихся страницах сначала нужно понять, требуется исключить URL из поиска полностью или указать предпочтительную версию.
Ожидание роста позиций после очистки индекса. Удаление технического мусора может улучшить структуру проекта и диагностику индексирования, но из самого факта установки noindex не следует гарантированное повышение позиций других страниц.
Как выбрать правильный механизм для конкретного URL
Перед изменением robots meta полезнее сформулировать ожидаемый результат, чем выбирать директиву по названию.
| Что должно произойти | Что использовать |
|---|---|
| Страница доступна пользователям, но не должна показываться в поиске | noindex |
| Робот не должен тратить обход на определённые URL | robots.txt |
| Документ не должен быть доступен посторонним | авторизация или иной контроль доступа |
| Старый URL окончательно заменён новым | постоянный серверный редирект |
| Есть несколько похожих URL, но один предпочтителен | rel="canonical" |
| Нужно управлять сниппетом Google | nosnippet, max-snippet и другие поддерживаемые правила |
| Нужно исключить из индекса PDF или другой не-HTML ресурс | X-Robots-Tag: noindex |
Такая схема предотвращает большинство ошибок вокруг meta robots: сначала определяется необходимое поведение URL, затем выбирается технический механизм.
После внедрения результат подтверждается в трёх местах: фактическом HTML, HTTP-ответе и данных поискового робота. Только совпадение этих уровней показывает, что настройка действительно применяется так, как задумано.
Практика
Как проверить и исправить Meta robots
Зафиксировать текущее состояние
Сохранить исходный HTML страницы, HTTP-заголовки и результаты текущего краула, чтобы после изменения можно было сравнить состояние.
Проверить все источники директив
Найти meta name="robots", X-Robots-Tag, ограничения в robots.txt и настройки CMS или SEO-модуля для проверяемого URL.
Найти конфликт правил
Определить, соответствует ли текущая директива задаче страницы и не мешает ли robots.txt поисковику прочитать noindex.
Изменить ограниченную группу URL
Сначала применить исправление на тестовой среде или нескольких однотипных страницах и проверить сформированный HTML и HTTP-ответ.
Проверить глазами робота
Повторить краул и проверить URL через Google Search Console и Яндекс Вебмастер, убедившись, что поисковик получает нужную директиву.
Проконтролировать переобход
После внедрения следить за повторным обходом и состоянием индексирования, отдельно проверяя важные страницы и отсутствие побочных изменений в шаблонах.
FAQ
Когда noindex решает задачу, а когда создаёт новую проблему
Это набор инструкций, которые поисковый робот получает непосредственно со страницы или из HTTP-заголовка. С их помощью можно, например, запретить показ URL в поисковой выдаче через noindex или ограничить обработку ссылок через nofollow. Сам по себе тег не закрывает страницу от посещения пользователями.
Директива не является способом повысить позиции. Но она напрямую влияет на возможность страницы участвовать в поиске: URL с обработанным noindex не должен показываться в результатах. Ошибка в настройке поэтому способна убрать важную страницу из поиска, а правильная настройка — устранить нежелательную индексацию, но не гарантирует рост позиций остальных страниц.
Проверьте исходный HTML, затем HTTP-заголовки ответа и настройки CMS или SEO-модуля, который может формировать директиву автоматически. После этого используйте проверку URL в Google Search Console и инструмент проверки страницы в Яндекс Вебмастере, чтобы убедиться, какое состояние видит поисковый робот.
Чтобы выполнить noindex, поисковому роботу сначала нужно получить страницу или её HTTP-заголовки. Если доступ к URL запрещён через robots.txt, робот может не увидеть директиву. Поэтому для исключения обычной HTML-страницы из поиска URL обычно оставляют доступным для обхода и передают noindex.
Сначала убедитесь, что директива отсутствует и в HTML, и в X-Robots-Tag, а URL не закрыт для обхода и отвечает корректным HTTP-кодом. Затем проверьте URL через инструменты поисковых систем и запросите повторный обход для важной страницы. Отсутствие noindex означает только возможность индексирования, но не гарантирует включение URL в индекс.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.