Индексация сайта начинается не в тот момент, когда страница появилась в WordPress или открылась в браузере. Сначала поисковой системе нужно узнать о URL, затем получить страницу, обработать её содержимое и технические сигналы, определить основную версию среди возможных дублей и решить, следует ли включать документ в индекс.
Поэтому фраза «страница доступна» ещё ничего не говорит о её присутствии в поиске. URL может возвращать 200 OK, находиться в Sitemap и успешно открываться роботом, но при этом оставаться вне индекса. И наоборот, проблема иногда возникает раньше: поисковик вообще не знает о новом адресе или не может получить его с сервера.
Для SEO важно различать эти состояния. Индексация не является отдельным «фактором роста позиций»: она определяет, может ли конкретная страница вообще участвовать в поиске. Уже после этого поисковая система решает, по каким запросам и насколько высоко её показывать.
От URL до индекса: где именно находится проблема
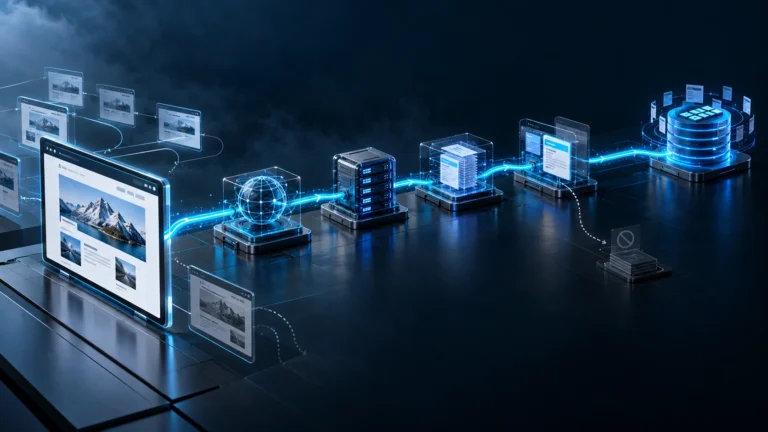
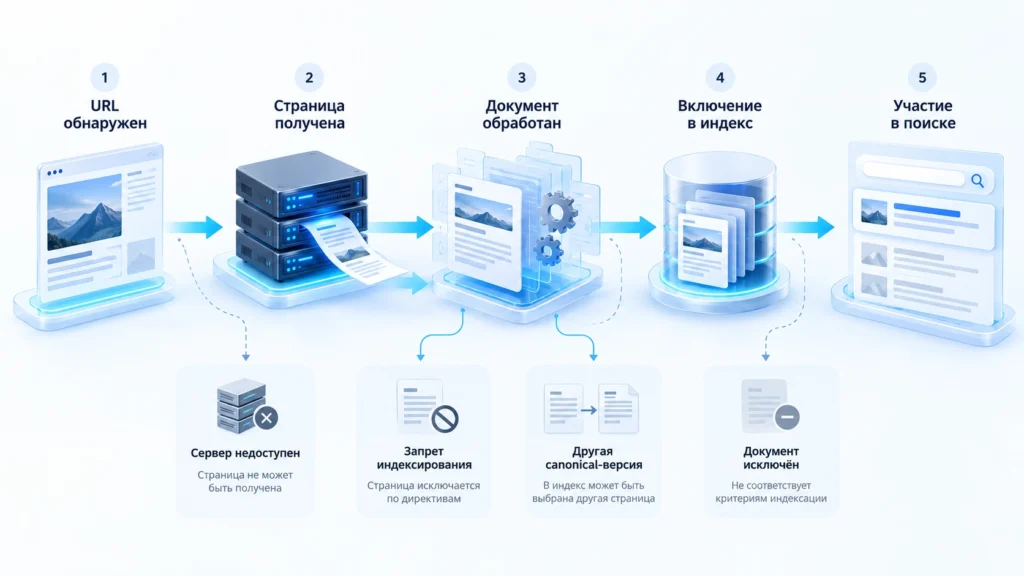
Удобнее рассматривать работу поиска как последовательность, а не как два состояния «проиндексировано / не проиндексировано».
- Обнаружение URL. Поисковик узнаёт адрес из внутренних или внешних ссылок, Sitemap либо других поддерживаемых источников.
- Обход. Робот пытается получить ресурс и видит фактический HTTP-ответ сервера.
- Обработка. Анализируются HTML, текст, изображения, метаданные, директивы для роботов и, при необходимости, отрисованный JavaScript.
- Каноникализация и оценка документа. Поисковик сопоставляет похожие адреса и может выбрать другой URL как основную версию.
- Индексирование. Информация о документе может быть сохранена в поисковом индексе.
- Показ в поиске. Даже проиндексированный документ появляется только там, где поисковая система считает его подходящим результатом.
Последний пункт особенно важен. Отсутствие страницы по желаемому запросу не доказывает отсутствие индексации. Сначала нужно установить именно статус URL, а уже затем разбирать релевантность и позиции.
Попадание в индекс не гарантируется отправкой URL
Sitemap помогает поисковому роботу обнаруживать важные страницы, но это не команда «добавить в индекс». Аналогично работает ручной запрос на переобход: он сообщает поисковой системе, что страницу стоит посетить снова, но не отменяет последующие этапы обработки.
Для автоматической передачи сведений о новых и изменённых URL можно отдельно рассматривать bing indexnow, однако уведомление через протокол также нельзя считать гарантией индексирования.
Почему найденная страница может не попасть в индекс
Не каждый непроиндексированный URL является ошибкой. На нормальном сайте вне индекса могут оставаться технические адреса, дубли, страницы фильтров, промежуточные редиректы и документы, которые сознательно не предназначены для поиска.
Проблема начинается тогда, когда исключена страница, которую вы считаете основной и хотите получать из поиска.
| Состояние | Что проверить в первую очередь | Что это может означать |
|---|---|---|
| URL неизвестен поисковику | внутренние ссылки, Sitemap, обнаружение URL | робот ещё не получил сигнал о странице |
| Обнаружен, но не просканирован | доступность сервера, внутреннюю структуру, количество технических URL | адрес известен, но обход ещё не состоялся |
| Просканирован, но не проиндексирован | содержание, дубли, canonical, noindex, качество документа | страница получена, но не выбрана для индекса |
| Выбран другой canonical | rel="canonical", редиректы, внутренние ссылки, Sitemap | сигналы основной версии противоречат друг другу |
| Ошибка сервера | фактический HTTP-код и стабильность ответа | робот не смог нормально получить документ |
| URL ранее был в поиске и исчез | историю изменений, шаблон, метатеги, canonical, редиректы | изменилось техническое или содержательное состояние страницы |
Исключено из индекса — не всегда значит «сломано»
В отчётах поисковых систем слово «исключено» нужно читать вместе с причиной. Если поисковик обнаружил несколько одинаковых URL и оставил один канонический, отсутствие остальных в индексе может быть правильным результатом.
То же относится к URL, которые вы намеренно закрыли от поиска, удалили или перенаправили. Задача SEO-аудита — не добиться одинакового количества URL в CMS, Sitemap и индексе, а убедиться, что индексируются именно нужные канонические страницы.
Выпадение из индекса требует сравнения «до» и «после»
Если страница долго участвовала в поиске, а затем исчезла, полезно искать изменение, а не просто повторно отправлять URL на обход.
Проверьте, не появился ли noindex, не изменился ли canonical, не начал ли URL перенаправлять на другой адрес, не возвращает ли сервер ошибки, не исчезли ли внутренние ссылки и не изменилось ли содержание настолько, что поисковик стал воспринимать страницу иначе.
Если сайт не индексируется целиком, диагностику следует начинать не с отдельных текстов, а с доступности домена, ответа сервера, глобальных директив для роботов, шаблонов CMS и структуры внутренних ссылок.
Как проверить индексацию сайта без гадания по выдаче
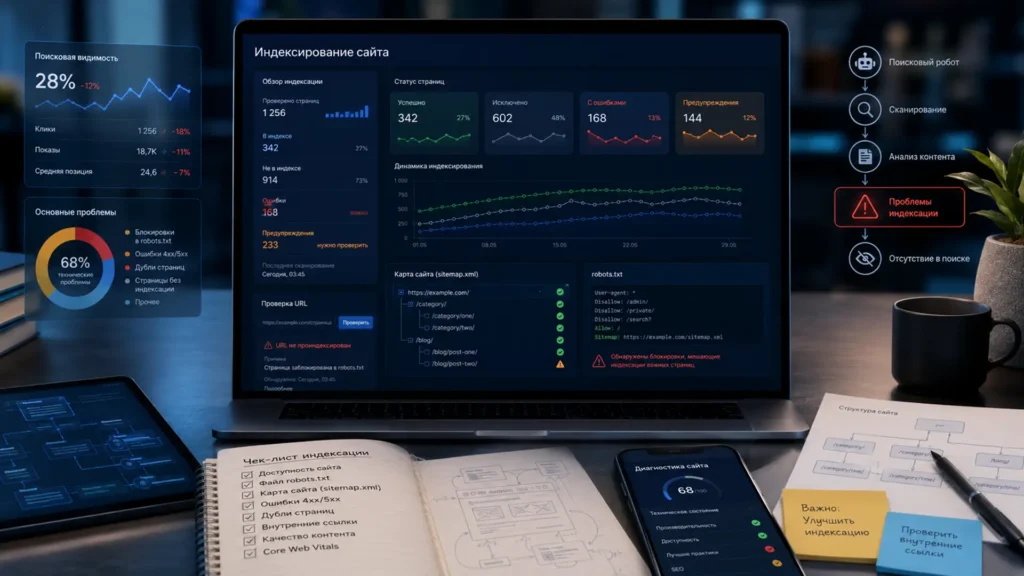
Для отдельного URL лучше использовать инструменты поисковой системы, а не делать вывод только по оператору site:.
В Google Search Console инструмент проверки URL показывает последнюю известную Google версию страницы, дату обхода, возможность сканирования, результат получения документа, разрешение индексирования, заявленный canonical и canonical, выбранный Google. Отдельная проверка опубликованной страницы позволяет увидеть текущее техническое состояние URL.
Эти два режима нельзя смешивать. Страница сегодня может быть уже исправлена и успешно проходить live-проверку, но индекс всё ещё хранит старое состояние. И наоборот, положительная live-проверка не обещает, что URL обязательно будет включён в индекс.
Кроме технических причин стоит отдельно учитывать меры принятые вручную, проблемы безопасности и другие состояния, которые не сводятся к наличию 200 OK.
В Яндекс Вебмастере полезно сопоставлять «Проверку страницы», сведения об обходе и раздел «Страницы в поиске». Если робот может получить документ, это подтверждает доступность, но не равнозначно участию URL в поиске. Для исключённых страниц нужно смотреть указанную Яндексом причину.
Поиск самого URL или оператор site: подходит как дополнительная проверка, но не заменяет диагностические отчёты. Поисковая выдача отвечает на вопрос «показывается ли сейчас результат», тогда как Search Console и Вебмастер дают сведения о том, что произошло с конкретным URL.
Индексация PDF
PDF — не «невидимый» для поиска формат. Google поддерживает индексирование PDF и ряда других текстовых форматов, поэтому документ, доступный по отдельному URL, тоже следует учитывать при техническом аудите.
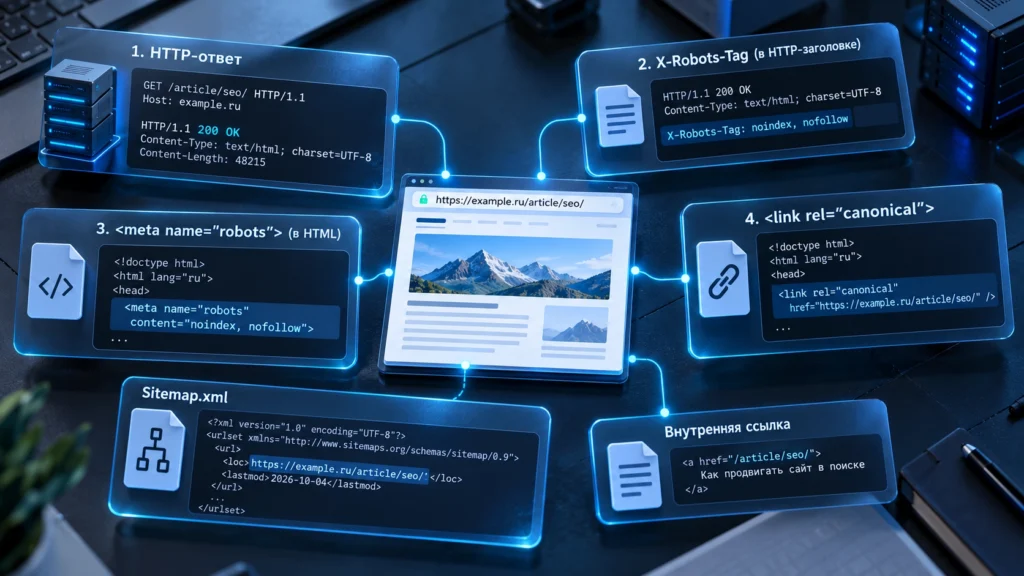
Для PDF нельзя использовать HTML-метатег в <head>, которого у файла нет. Если такой документ не должен индексироваться, для Google управление возможно через HTTP-заголовок X-Robots-Tag.
Например:
HTTP/1.1 200 OK
Content-Type: application/pdf
X-Robots-Tag: noindex
Это особенно важно на сайтах, где PDF дублирует полноценную HTML-страницу: прайс, инструкцию, каталог или документ для скачивания. Решение о том, какая версия должна участвовать в поиске, лучше принимать осознанно, а не оставлять две конкурирующие копии без контроля.
Технические ошибки, которые ломают индексацию
Страница случайно получила noindex
Для HTML распространённый вариант выглядит так:
<meta name="robots" content="noindex">Если индексирование публичной страницы требуется, такая директива противоречит задаче. Особенно опасны массовые ошибки шаблона, когда noindex после разработки или изменения SEO-плагина появляется сразу на группе страниц.
Для Google есть ещё важная особенность: если URL одновременно запрещён в robots.txt, Googlebot может не получить сам HTML и, следовательно, не увидеть размещённый внутри noindex. Поэтому использовать robots.txt как универсальный способ удаления страницы из Google нельзя.
Canonical указывает не туда
Допустим, опубликована страница:
https://example.com/services/seo/но в её HTML стоит:
<link rel="canonical" href="https://example.com/services/">Для поисковика это сигнал, что предпочтительной является другая страница. Сам по себе canonical не следует воспринимать как абсолютную команду, но конфликтовать с собственным намерением бессмысленно.
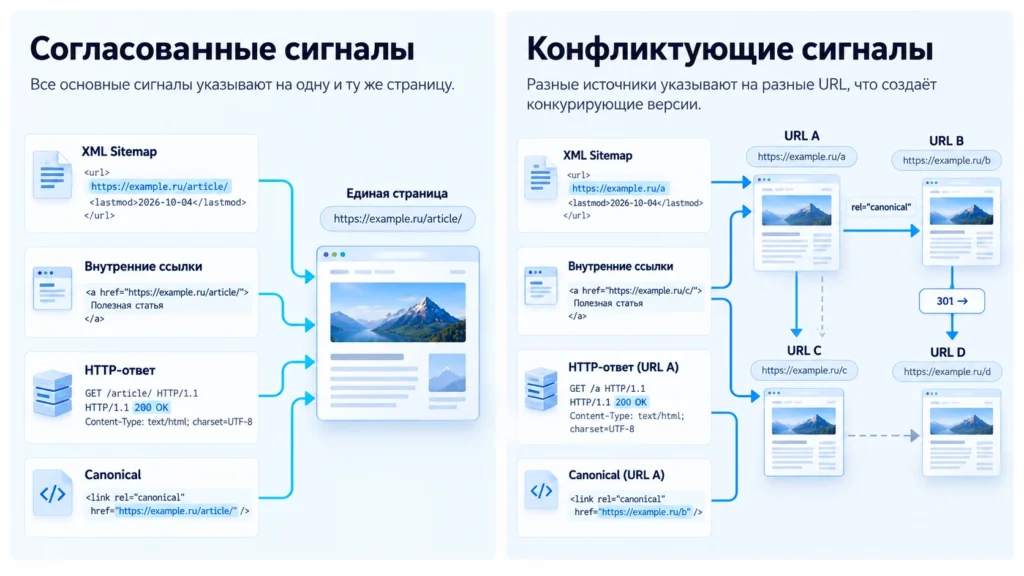
Для индексируемого самостоятельного документа обычно ожидается согласованная картина: внутренние ссылки ведут на нужный URL, он присутствует в Sitemap, отдаёт корректный ответ и указывает подходящий canonical.
Sitemap содержит одно, а сайт сообщает другое
Типичный конфликт: в Sitemap размещён URL A, canonical на нём указывает на B, внутренние ссылки ведут на C, а B дополнительно перенаправляет пользователя на D.
Вместо усиления нужного адреса поисковая система получает несколько несовпадающих сигналов. Исправление заключается не в повторной отправке Sitemap, а в выборе единственной логичной конечной версии и приведении технических сигналов к ней.
Сервер отвечает не так, как кажется браузеру
В браузере страница может «работать» из-за кэша, JavaScript, CDN или промежуточного редиректа. Робот при этом получает 5xx, длинную цепочку перенаправлений или другой ответ.
Поэтому при проблемах с индексированием полезно смотреть именно HTTP-ответ:
curl -I https://example.com/page/Для обычной индексируемой страницы ожидается понятный конечный маршрут без случайных серверных ошибок. Но один 200 OK всё равно не доказывает, что документ уже находится в индексе.
Практический пример: статья опубликована, но Google её не индексирует
Представим обычную ситуацию. Новая статья доступна по постоянному адресу, добавлена в Sitemap и открывается у редактора. Через несколько дней её всё ещё нет в индексе.
Первая ошибка — несколько раз подряд нажимать запрос индексирования и ждать другого результата.
Сначала нужно установить, на каком этапе находится URL.
Допустим, Search Console показывает, что Google страницу уже просканировал. Значит, проблема не в отсутствии обнаружения. Проверка опубликованной версии проходит успешно, сервер возвращает 200 OK, а robots.txt не препятствует обходу.
Следующая проверка обнаруживает:
<link rel="canonical" href="https://example.com/articles/old-page/">Canonical остался от страницы, которую использовали как основу для нового материала. В этом случае Sitemap и внутренняя ссылка сообщают Google об одном URL, а сам документ рекомендует считать основной другую страницу.
Правильное действие — исправить canonical, проверить финальный HTML и только затем запросить повторный обход.
После этого нормальным результатом сначала будет не рост позиции, а изменение технического состояния: поисковик повторно получает документ, видит согласованные сигналы и перестаёт считать неправильный URL предпочтительной версией. Решение о включении страницы в индекс остаётся за поисковой системой.
Такой порядок полезнее попыток «ускорить индексирование», потому что устраняет причину, а не маскирует симптом.
Если такие проблемы повторяются сразу на многих URL, проверкой одной страницы уже не обойтись: SEO-продвижение сайта с технической диагностикой должно разбирать шаблоны CMS, внутренние ссылки, canonical, Sitemap и фактическое состояние страниц в поиске как единую систему.
Чек-лист проверки важной страницы
Проверку удобнее заканчивать не вопросом «есть ли URL в Google или Яндексе», а набором технических условий.
Для страницы, которая должна участвовать в поиске, проверьте:
- URL действительно является нужной канонической версией;
- сервер стабильно отдаёт ожидаемый HTTP-ответ;
- поисковому роботу разрешён обход;
- в HTML или HTTP-заголовках нет случайного
noindex; - canonical не указывает на другой документ без причины;
- URL присутствует в актуальной внутренней структуре сайта;
- Sitemap не противоречит canonical и фактическим ссылкам;
- страница не является почти полной копией другого URL;
- поисковая система уже обнаружила адрес;
- в Search Console или Яндекс Вебмастере проверена конкретная причина текущего статуса.
Только после этого имеет смысл отправлять исправленную страницу на повторный обход.
При массовой проблеме проверяйте не десять URL вручную, а закономерность. Если сотни страниц одного типа одновременно получили одинаковый статус, ищите общий шаблон: настройку WordPress, SEO-плагин, шаблон canonical, правило robots.txt, редирект, заголовок сервера или изменение генерации внутренних ссылок.
Что считать исправленной индексацией
Успешный результат — не максимальное количество страниц в индексе.
Нормальная картина выглядит иначе: важные канонические документы доступны роботу и участвуют в поиске, а ненужные технические URL, дубли и удалённые страницы не создают конкурирующий набор документов.
Для отдельной проблемной страницы последовательность проверки проста по смыслу: поисковик должен знать URL, иметь возможность его получить, увидеть правильные директивы, понять выбранную основную версию и не сталкиваться с техническим конфликтом.
Если все эти условия выполнены, а страница всё равно не индексируется, причина уже не сводится к одной кнопке или одной директиве. Тогда нужно анализировать состояние, которое показывает конкретная поисковая система, качество и самостоятельность документа, дублирование и роль страницы внутри структуры сайта.
Именно поэтому индексация сайта — это не действие «добавить URL в Google или Яндекс», а контролируемая цепочка от обнаружения страницы до решения поисковой системы включить её в свой индекс.
FAQ
Когда отсутствие страницы в индексе действительно является проблемой
Это этап, на котором поисковая система обрабатывает найденную страницу, определяет её содержание и решает, хранить ли данные о ней в поисковом индексе. Обход страницы роботом и её индексация — не одно и то же: URL может быть успешно загружен, но не попасть в индекс.
Для обычной страницы попадание в индекс является необходимым условием участия в поиске, но само по себе не даёт более высоких позиций. После индексирования поисковая система отдельно определяет релевантность и качество страницы для конкретного запроса. Поэтому ускорение обхода нельзя считать способом автоматически повысить позиции.
Для Google основной источник — инструмент проверки URL в Search Console, где видны статус индексирования, последний обход, разрешение сканирования и выбранный canonical. В Яндекс Вебмастере используются «Проверка страницы» и раздел со страницами в поиске. Поисковые операторы полезны как дополнительная быстрая проверка, но для диагностики лучше использовать данные самих поисковых систем.
Возможные причины включают дублирование, выбор другого canonical, низкую самостоятельную ценность страницы, технические ошибки, некорректные директивы индексирования или состояние, при котором URL уже обнаружен, но ещё не обработан для индекса. Положительная проверка доступности означает лишь отсутствие некоторых технических препятствий, а не гарантию включения в индекс.
Сначала сравните текущую страницу с последней известной поисковику версией: HTTP-ответ, robots.txt, noindex, canonical, редиректы, содержание и внутренние ссылки. Затем проверьте причину исключения в Search Console или Яндекс Вебмастере. Запрашивать повторный обход имеет смысл после устранения причины, а не вместо диагностики.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.