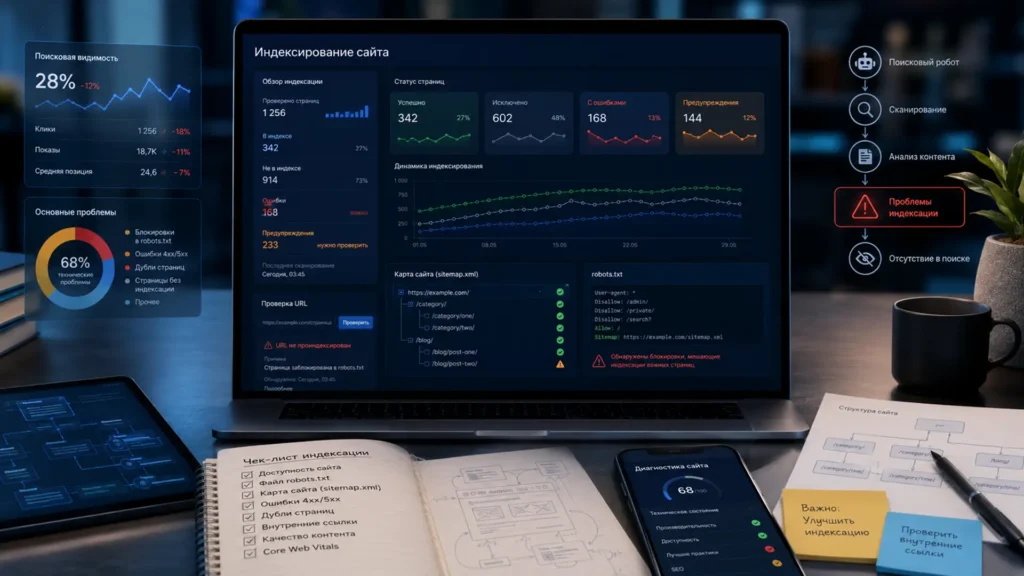
Когда сайт не индексируется, проблема не всегда находится в одном метатеге или настройке WordPress. Поисковая система сначала должна обнаружить URL, затем получить страницу, обработать её содержимое и только после этого решить, будет ли документ храниться в индексе и использоваться в поиске.
Поэтому вопрос «почему страницы сайта не индексируются» лучше превращать в более точный: на каком этапе перестаёт работать конкретный URL? Такой подход сразу отделяет техническую блокировку от ситуации, когда поисковик уже увидел страницу, но пока не выбрал её для индекса.
Сначала определите, на каком этапе пропадает страница
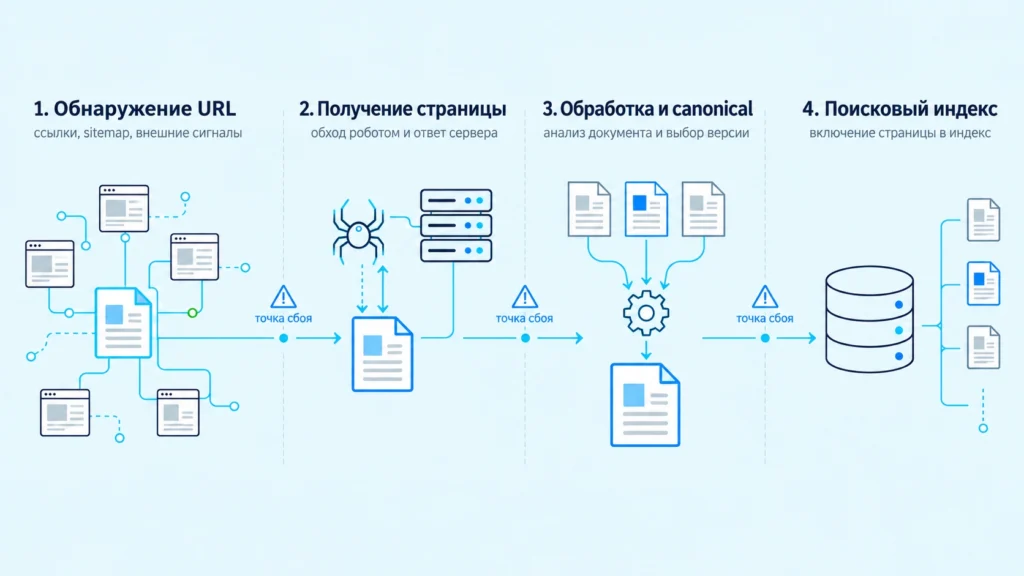
Для Google полезно разделять три процесса: обход, индексирование и показ результатов. Обнаружение URL ещё не означает, что Googlebot его уже скачал, а успешный обход не означает автоматического добавления страницы в индекс.
Практически цепочка выглядит так:
- поисковик узнаёт об URL из ссылок, Sitemap или предыдущих обходов;
- робот пытается получить страницу;
- сервер возвращает документ и HTTP-ответ;
- поисковая система обрабатывает HTML, ресурсы и при необходимости JavaScript;
- анализирует содержимое, дубли и canonical;
- решает, включать ли URL или выбранную каноническую версию в индекс.
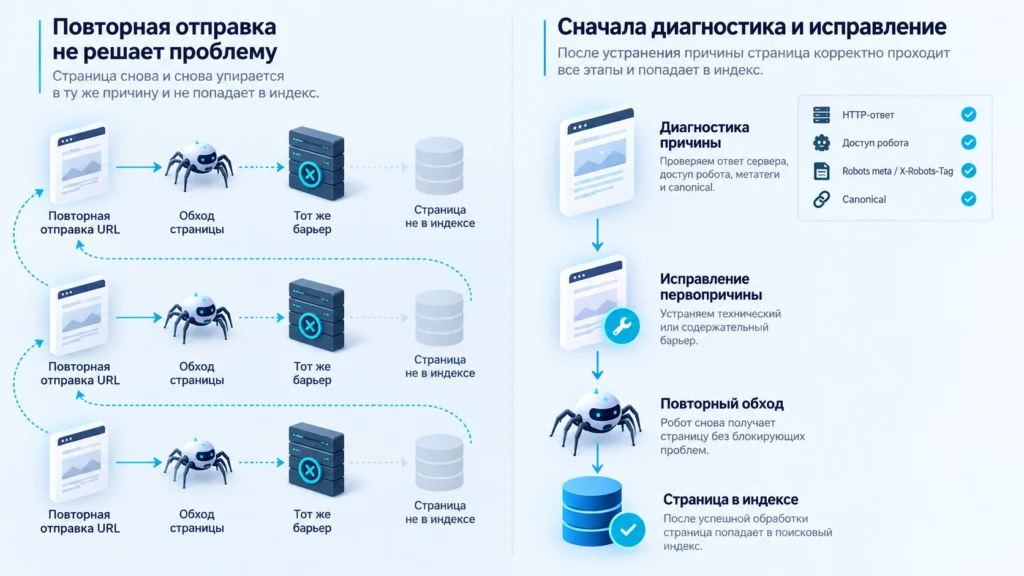
Самый важный вывод: исправление должно соответствовать этапу. Если робот не может получить документ, переписывание текста не решит проблему. Если Google уже регулярно сканирует страницу, бесконечная отправка URL на индексирование также не устраняет причину.
Как проверить, почему сайт не индексируется
Диагностику лучше начинать не со всего домена, а с нескольких URL, которые действительно должны участвовать в поиске: главной страницы, важной услуги или категории и нескольких недавно опубликованных материалов.
Для каждого URL проверьте четыре группы сигналов.
| Что проверить | Нормальное состояние | Что может мешать |
|---|---|---|
| HTTP-ответ | 200 OK для рабочей страницы | 3xx, 4xx, 5xx, ошибки CDN или защиты |
| Доступ робота | URL разрешён для обхода | Disallow, авторизация, блокировка бота |
| Индексирование | нет запрещающего noindex | meta robots noindex, X-Robots-Tag: noindex |
| Canonical | указывает на нужную версию | canonical на другой URL, конфликт дублей |
| Обнаружение | есть внутренние ссылки и Sitemap | URL-сирота, отсутствует в структуре |
| Контент | основной материал доступен роботу | пустой HTML, ошибка рендеринга, слабый дубль |
Быструю серверную проверку можно сделать по заголовкам ответа:
curl -I https://example.com/page/Для обычной индексируемой HTML-страницы прежде всего интересуют реальный HTTP-код, редиректы и отсутствие неожиданного заголовка:
X-Robots-Tag: noindexПосле этого проверьте исходный HTML. Запрещающий метатег выглядит так:
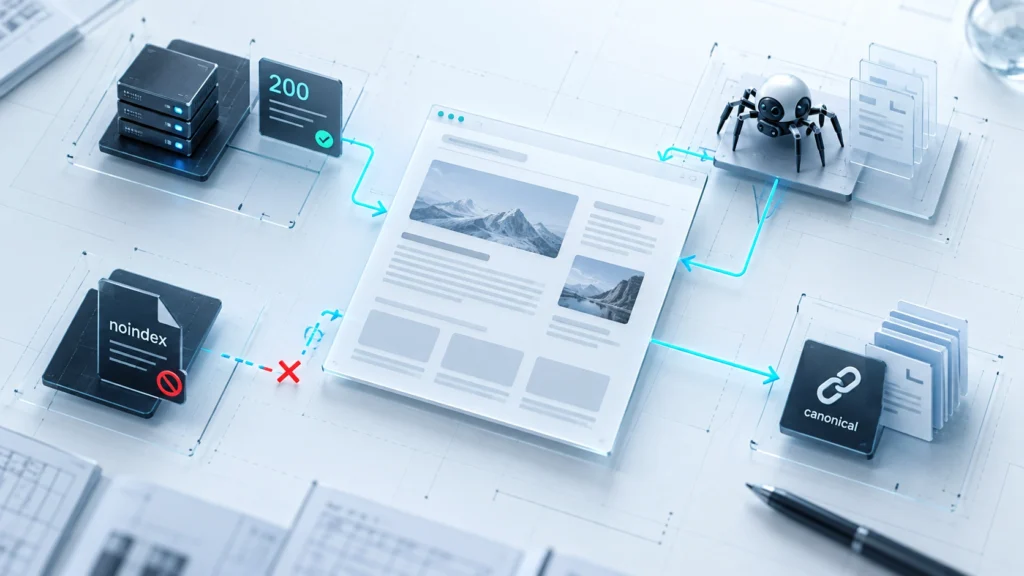
<meta name="robots" content="noindex">Если страница нужна в поиске, такой запрет должен отсутствовать. При этом закрывать URL в robots.txt и одновременно рассчитывать, что поисковик прочитает находящийся внутри страницы noindex, — конфликтующая схема: робот должен получить документ, чтобы увидеть метатег или HTTP-заголовок.
Индексирование Google: что смотреть в Search Console
Для отдельной страницы основной инструмент — проверка URL. Она показывает, что Google знает об адресе и какой статус имеет уже полученная версия страницы. Проверка опубликованной версии полезна после исправления, потому что позволяет убедиться, что Googlebot сейчас может получить документ.
Для анализа большого количества страниц используют отчёт индексирования Google. Важен не сам размер группы «не проиндексировано», а причины и типы URL внутри неё. Архивы, редиректы, дубли и удалённые документы вполне могут отсутствовать в индексе намеренно.
Иначе нужно относиться к коммерческим страницам, статьям и посадочным URL, которые должны участвовать в поиске. Если значительная часть именно таких документов оказывается исключена, диагностируйте конкретные статусы.
«Просканировано — в настоящее время не проиндексировано»
Этот статус принципиально отличается от блокировки робота: Google страницу уже получил, но на данный момент не добавил её в индекс. Поэтому сначала ищут не запрет обхода, а дублирование, canonical-конфликт, слабое отличие от других URL, состояние самого документа и его роль в структуре сайта.
Повторно отправлять десятки таких страниц после каждого просмотра отчёта бессмысленно. Google отдельно указывает, что наличие технически корректной страницы не гарантирует её индексирование.
Для статуса, при котором URL только обнаружен, но ещё не просканирован, логика другая: проверяются доступность сервера, масштабы создаваемого сайтом URL-пространства, Sitemap и внутреннее обнаружение важных страниц.
Что проверить в Яндекс Вебмастере
В Яндексе также нужно смотреть состояние конкретной страницы, а не делать вывод только по присутствию домена в поиске. Среди диагностируемых причин официальная документация указывает HTTP-ошибки, запрет noindex и выбор другого канонического URL.
После реального исправления важные обновлённые страницы можно передать через переобход. Это способ сообщить роботу об изменении, а не гарантия включения документа в поиск.
Что исправлять в зависимости от найденной причины
Если URL закрыт в robots.txt, сначала определите, действительно ли поисковику запрещён нужный раздел. Особенно внимательно проверяйте шаблоны с масками: одна слишком широкая директива способна закрыть целую группу страниц.
Если обнаружен noindex, выясните его источник. В WordPress запрет может появиться из настроек видимости сайта, SEO-плагина, шаблона, пользовательского кода или HTTP-заголовка на уровне сервера.
Если canonical ведёт на другую страницу, сравните намерение с фактической архитектурой. Для дубля это может быть корректно. Для уникальной посадочной страницы canonical на соседний URL означает, что сайт сам сообщает поисковой системе о предпочтении другой версии.
Если страница отдаёт редирект, индексировать исходный URL обычно и не требуется: важна конечная страница цепочки. Для удалённого документа корректный 404 или 410 также не является ошибкой индексирования, если URL действительно больше не нужен.
Отдельный класс проблем — JavaScript. Google умеет обрабатывать JavaScript, а Яндекс предоставляет средства проверки его рендеринга, но критичный контент всё равно нужно оценивать глазами робота. Если исходная страница почти пуста, API возвращает ошибку либо важный материал появляется только при сценарии, недоступном поисковому роботу, браузер пользователя и поисковик могут фактически получать разные документы.
Когда техника исправна, а страница всё равно отсутствует в индексе
Одна из частых ошибок SEO-аудита — считать отсутствие noindex доказательством того, что URL обязан индексироваться.
Google формулирует минимальные технические требования достаточно ясно: Googlebot не должен быть заблокирован, страница должна корректно работать и содержать индексируемый контент. Но выполнение этих условий означает возможность индексирования, а не обещание включить документ в индекс.
На этом этапе нужно проверить уже сам набор страниц:
- создают ли несколько URL один и тот же результат для пользователя;
- не образуют ли фильтры, параметры и архивы большое количество почти одинаковых документов;
- отличается ли новая статья от существующих материалов сайта по задаче и содержанию;
- есть ли у страницы нормальное место в структуре и ссылки с тематически связанных документов;
- не конкурирует ли она с другой собственной страницей за тот же интент;
- не указывает ли совокупность canonical, редиректов и Sitemap на разные версии одного материала.
Sitemap здесь помогает обнаруживать URL, но не является командой «добавить в индекс». То же относится к ручной отправке страницы после исправления.
Для оценки данных полезно смотреть не только количество исключённых URL, но и эффективность Google Search Console в SEO как диагностического инструмента: сопоставлять статус индексирования с типом страницы, датой обхода и реальными изменениями на сайте, а не воспринимать каждый статус как отдельную SEO-ошибку.
Практический сценарий: новые статьи не появляются в поиске
Представим сайт, где опубликовано 40 новых материалов. Все адреса находятся в Sitemap, но часть статей спустя некоторое время не появляется в Google.
Сначала берём не все 40 URL, а выборку: пять индексируемых и пять проблемных страниц одного типа.
У проблемных URL проверяем:
- сервер возвращает
200 OK; - robots.txt не запрещает обход;
- в HTML и заголовках нет
noindex; - canonical указывает на сам URL;
- страница присутствует в Sitemap;
- на неё ведут обычные внутренние ссылки;
- Google действительно просканировал документ.
Если последние данные Search Console показывают «Просканировано — в настоящее время не проиндексировано», проблема уже не сводится к обнаружению URL. Сравниваем десять выбранных материалов: структуру, степень повторения, пересечение интента, уникальную практическую ценность и наличие почти идентичных страниц.
Допустим, выясняется, что каждая новая статья создана из одного шаблона, а значительная часть текста отличается только названием продукта. В такой ситуации очередное Request indexing не устраняет причину. Нужна работа с самими документами и архитектурой: объединение дублей, усиление действительно самостоятельных страниц и удаление лишних URL из индексируемого контура.
После изменений проверяется опубликованная версия страницы, затем поисковой системе дают возможность переобойти URL. Критерий успеха здесь не «кнопка отправки сработала», а изменение фактического состояния после следующего обхода.
Как понять, что проблема индексации действительно исправлена
Проверка заканчивается не в момент изменения robots.txt или canonical. После исправления поисковая система должна снова получить страницу и обработать новую версию.
Для важных URL контролируйте три результата:
- робот получает ожидаемый документ с корректным HTTP-ответом;
- актуальная версия больше не содержит технической причины исключения;
- после повторной обработки меняется фактический статус URL.
Если страница технически доступна, но поисковик всё равно не включает её в индекс, не возвращайтесь автоматически к robots.txt. На этом этапе задача уже смещается от «разрешить роботу доступ» к качеству, уникальности, канонизации и роли URL в архитектуре сайта.
Именно поэтому диагностика «сайт не индексируется» должна идти от конкретного статуса к конкретной причине. Это быстрее и надёжнее, чем одновременно менять Sitemap, robots.txt, текст страницы и отправлять весь сайт на переобход: при таком подходе невозможно понять, что действительно было неисправно.
FAQ
Когда технически исправная страница всё равно не попадает в индекс
Код 200 OK — только одно из минимальных технических условий. Google прямо указывает, что доступность Googlebot, успешный HTTP-ответ и индексируемый контент делают страницу пригодной для индексирования, но не гарантируют включение в индекс. Дополнительно проверяются canonical, содержимое страницы и другие сигналы, используемые системой индексирования.
Постоянно отправлять такой URL повторно не нужно. Этот статус означает, что Google уже просканировал страницу, но пока не включил её в индекс. Полезнее проверить, чем она отличается от уже индексируемых страниц, нет ли дублей, слабого содержимого или противоречивых сигналов canonical.
Да, robots.txt способен запретить роботу обход URL, но это не универсальный способ удаления страницы из поиска. Google и Яндекс отдельно предупреждают, что заблокированный URL при определённых условиях всё равно может быть известен поисковику. Для управления индексированием страницы применяют корректный noindex, при этом робот должен иметь возможность увидеть эту директиву.
Сначала проверьте, доступны ли сами файлы роботу, возвращают ли они корректный HTTP-ответ и присутствуют ли изображения в индексируемой версии страницы. Для сайтов с JavaScript важно убедиться, что изображения и связанный с ними контент доступны после обработки страницы поисковым роботом. Отсутствие изображения в поиске само по себе не означает проблему с индексированием всей страницы.
Нет. Sitemap помогает поисковой системе обнаруживать URL и понимать структуру доступных страниц, но Google прямо указывает, что наличие URL в Sitemap не гарантирует его индексирование и не повышает позиции автоматически. Sitemap нужно рассматривать как способ обнаружения и передачи сигналов об URL, а не как команду добавить страницу в индекс.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.