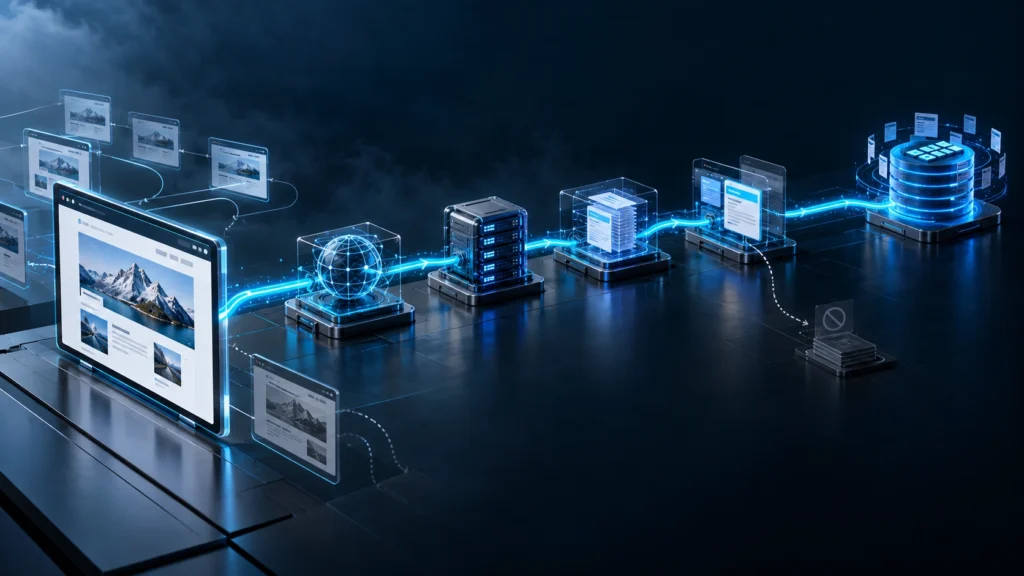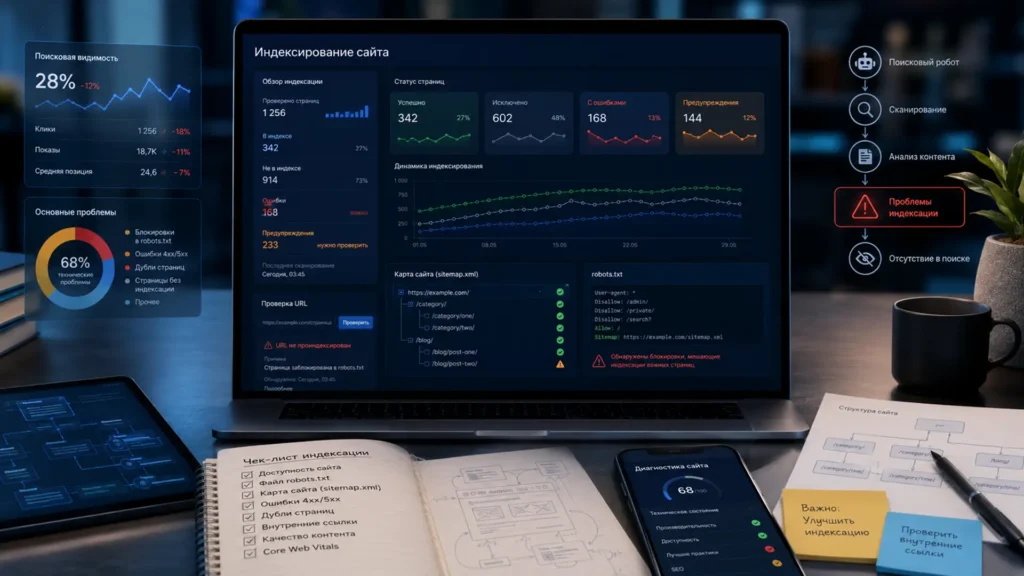
Проверка индексации нужна не для того, чтобы получить условную галочку «страница есть в поиске», а чтобы понять, на каком этапе URL выпал из процесса. Страница может быть известна поисковой системе, уже просканирована, но не добавлена в индекс; может быть признана дублем; может быть закрыта noindex; а может вообще не попадать в обход из-за слабой внутренней связности.
Поэтому проверять стоит не одной командой site: и не сторонним «онлайн-чекером». Для важной страницы нужны данные самой поисковой системы и несколько технических сигналов: HTTP-ответ, доступность для робота, robots-директивы, canonical, присутствие в Sitemap и внутренние ссылки.
Сначала разделите обход, индексирование и показ в поиске
У Google процесс состоит из отдельных этапов: обнаружение URL, обход, индексирование и дальнейший показ релевантных результатов. Сам факт успешного обхода ещё не означает, что страница обязательно попадёт в индекс, а наличие в индексе не гарантирует показ по конкретному запросу.
В Яндексе логика похожа: робот сначала получает документ, затем данные обрабатываются, после чего алгоритмы решают, может ли страница участвовать в поиске. В Яндекс Вебмастере отдельно видны страницы в поиске и причины исключения, включая ошибки HTTP, noindex, дубли и неканонические URL.
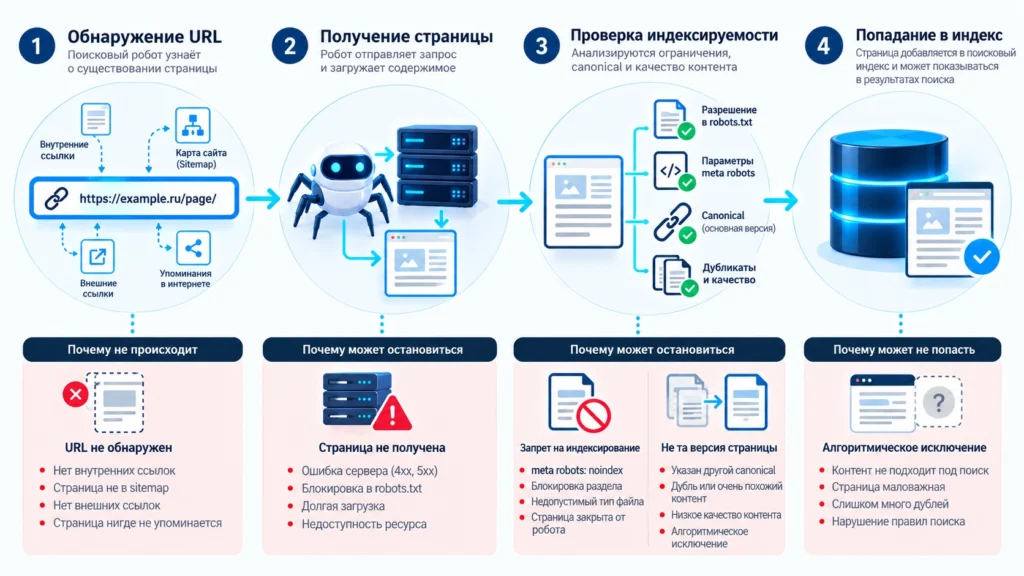
Как проверить индексацию конкретной страницы
Для Google основным инструментом является URL Inspection в Search Console. Он показывает, известен ли URL Google, был ли успешным последний обход, разрешено ли индексирование и какую каноническую страницу выбрал Google. Проверка live-версии помогает понять, исправлена ли техническая причина прямо сейчас, даже если основной отчёт ещё хранит данные предыдущего обхода.
В Яндекс Вебмастере для одной страницы полезны «Проверка страницы» и «Проверка ответа сервера». Они позволяют увидеть HTTP-код, доступность документа для выбранного робота и текущий статус страницы. Для массовой картины нужно смотреть раздел с индексируемыми и исключёнными страницами, а не проверять сотни URL вручную.
Запрос site:example.com/page/ годится только как быстрый ориентир: Google прямо указывает, что site: не обязан возвращать полный набор проиндексированных URL. Для спорной страницы опирайтесь на Search Console или Яндекс Вебмастер.
Для документов задача может отличаться от обычной HTML-страницы: индексация pdf зависит от того, доступен ли сам файл роботу, отдаётся ли поддерживаемый тип содержимого и не закрыт ли документ через HTTP-заголовки.
Что проверить до работы с контентом
Сначала убедитесь, что URL отвечает так, как вы ожидаете:
curl -I https://example.com/page/Для индексируемой HTML-страницы нормальная отправная точка — 200 OK. Затем проверьте, нет ли X-Robots-Tag: noindex в заголовках, а в HTML — запрета через robots meta:
curl -s https://example.com/page/ | grep -iE 'robots|canonical'Команды показывают ответ сервера, а не состояние поискового индекса, но быстро находят блокировку, HTTP-ошибку или неожиданный canonical.
Что означает «не индексируется»: диагностируйте причину, а не статус
Один и тот же итог «URL отсутствует в поиске» может требовать совершенно разных действий.
| Сигнал | Что это означает | Что делать |
|---|---|---|
5xx, 4xx, ошибочный редирект | робот не получает нормальную целевую страницу | исправить серверный ответ, редирект или доступность |
блокировка в robots.txt | обход URL ограничен | проверить, должна ли страница вообще сканироваться |
noindex | поисковику явно запрещено индексировать документ | убрать запрет, если URL должен участвовать в поиске |
| выбран другой canonical | поисковик считает другой URL основной версией | проверить дубль, rel="canonical", редиректы и внутренние сигналы |
| URL обнаружен, но ещё не просканирован | поисковик знает адрес, но обход не состоялся | проверить внутренние ссылки, Sitemap, сервер и общую доступность |
| URL просканирован, но не индексирован | технический доступ есть, но страница не включена в индекс | проверить дублирование, полезность, полноту и необходимость отдельного URL |
Не все исключённые страницы нужно «исправлять». Фильтры, технические URL, служебные страницы и корректные дубли часто не должны находиться в индексе. Цель аудита — не 100% индексируемых адресов, а индексируемость именно тех canonical-страниц, которые должны получать поисковый трафик.
Отдельный риск — URL без нормального пути по ссылкам. Страницы без внутренних ссылок могут присутствовать в Sitemap, но оставаться слабо связанными со структурой сайта. Такие сиротские страницы проверяйте и по фактическим входящим ссылкам.
Как исправлять проблемы в правильном порядке
Начинайте с технической доступности. Если важная страница возвращает 404, 500, уходит по ошибочной цепочке редиректов или закрыта от обхода, переписывание текста не решит первопричину.
Следующий уровень — явные запреты на индексирование. Для Google noindex должен быть доступен роботу: если одновременно закрыть URL в robots.txt, Google может не увидеть метатег или HTTP-заголовок noindex. На WordPress отдельно проверьте Настройки → Чтение → Видимость для поисковых систем. Включённая опция «Попросить поисковые системы не индексировать сайт» добавляет директивы, мешающие нормальной индексации публичного проекта.
После этого проверьте canonical. Если нужная страница указывает канонической другую версию либо поисковик выбрал другой URL из группы дублей, нужно исправить противоречивые сигналы: rel="canonical", постоянные редиректы, внутренние ссылки и состав Sitemap. Сам по себе canonical является сигналом, а не абсолютной командой: поисковая система может выбрать другой URL, если остальные признаки указывают на него.
После этого проверьте обнаружение страницы. В Sitemap должны находиться канонические URL, которые вы хотите видеть в поиске. Sitemap для Google — подсказка, а не гарантия обхода или индексации; внутренние ссылки также помогают обнаруживать новые URL.
Только после исключения технических причин оценивайте содержание: не дублирует ли страница другой документ, закрывает ли отдельный интент и есть ли у неё самостоятельная ценность.
После исправления можно ускорить индексацию важной страницы через запрос повторного обхода в Search Console или инструмент переобхода в Яндекс Вебмастере. Это запрос на повторную обработку, а не гарантия попадания в индекс или роста позиций.
Практический пример: статья WordPress пропала из индекса
Исходная ситуация: опубликованная статья открывается в браузере, есть в Sitemap, но по важному URL Search Console показывает отсутствие в индексе, а в Яндекс Вебмастере страница находится среди исключённых.
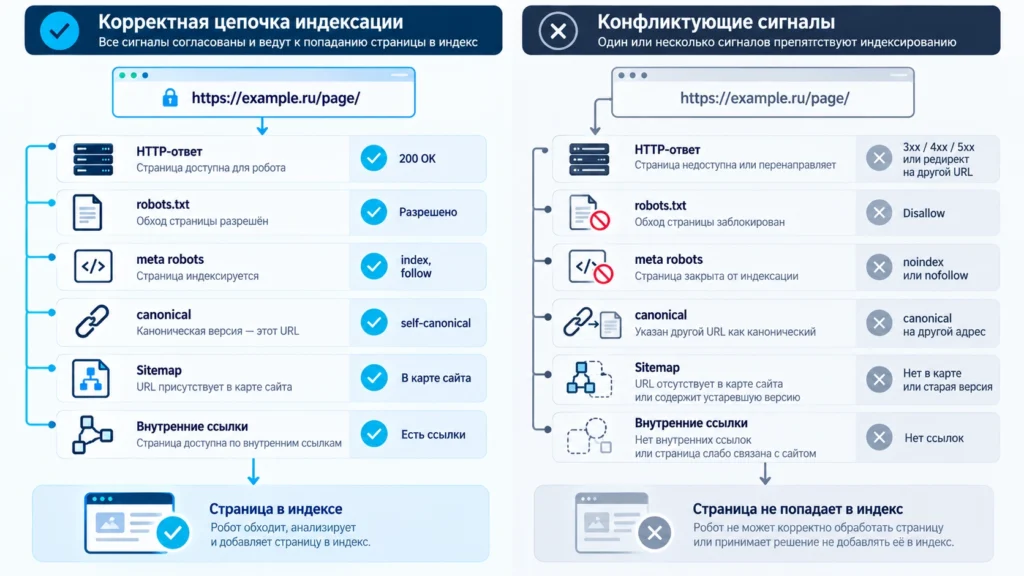
Первое действие — проверить сам URL и его окончательный ответ. Если вместо 200 обнаруживается редирект на другую страницу, причина уже найдена: нужно решить, какой URL должен быть основным. Если ответ 200, проверяем robots.txt, robots meta и X-Robots-Tag.
Второе действие — сравнить canonical в HTML с адресом страницы. На WordPress ошибочный canonical иногда появляется не из ядра CMS, а из SEO-плагина, кастомного фильтра, миграции домена или шаблона. Если canonical ведёт на старый или соседний URL, сначала исправляется этот сигнал.
Третье действие — проверить, может ли робот нормально найти страницу без Sitemap. Ссылка из тематически близкого материала или хаба полезнее случайной ссылки из подвала. Если URL существует только в XML-карте, стоит проверить архитектуру и входящие внутренние ссылки.
Четвёртое действие — посмотреть причину исключения в панели поисковика. Если Google уже просканировал страницу и не нашёл технического запрета, а Яндекс считает её дублем или малоценной, повторная отправка на переобход без изменения причины обычно ничего не меняет. Сначала устраняется дублирование, конфликт интента или недостаток самостоятельной ценности.
Критерий успеха — не мгновенное появление по site:. Сначала live-проверка должна подтверждать доступность и индексируемость, затем после нового обхода должен обновиться статус URL. Позиции и трафик оцениваются отдельно.
Как контролировать индексацию всего сайта
Для сайта целиком важна не разовая проверка, а распределение URL по причинам. Разделите адреса минимум на четыре группы: индексируются и должны индексироваться; не индексируются и это нормально; не индексируются ошибочно; индексируются, хотя должны быть закрыты.
В Google Search Console для этого подходит отчёт Page indexing: он показывает известные Google URL и причины, по которым часть адресов не индексируется. Не стоит стремиться к 100% coverage — Google отдельно отмечает, что не все известные URL должны попадать в индекс, особенно альтернативные и дублирующиеся страницы.
В Яндекс Вебмастере ту же задачу удобно решать через «Страницы в поиске» и список исключённых URL. Для крупных разделов полезно смотреть динамику по структуре сайта: резкий рост HTTP-ошибок, noindex, дублей или неканонических URL важнее абсолютного числа исключений.
Проверка индексации заканчивается не кнопкой «Запросить индексирование», а подтверждением причины и результата. Для важной страницы нормальная цепочка выглядит так: робот может получить URL, сервер возвращает ожидаемый ответ, индексирование не запрещено, canonical согласован, страница обнаруживается по ссылкам и Sitemap, а поисковая система после повторного обхода корректно обновляет её статус.
Практика
Как проверить и восстановить индексацию страницы
Определите нужный URL
Зафиксируйте канонический адрес страницы, которая должна участвовать в поиске, и исключите проверку случайного дубля, параметрической или старой версии URL.
Проверьте статус поисковика
Откройте URL Inspection в Google Search Console и проверку страницы в Яндекс Вебмастере, чтобы получить официальную причину индексирования или исключения.
Проверьте технический ответ
Убедитесь, что целевой URL отдаёт ожидаемый HTTP-ответ и не содержит случайных noindex, блокировок robots или неправильного X-Robots-Tag.
Сверьте canonical и ссылки
Проверьте rel="canonical", конечные редиректы, наличие URL в Sitemap и входящие внутренние ссылки; сигналы должны указывать на одну основную версию страницы.
Исправьте первопричину
Устраните обнаруженную техническую ошибку, дубль или проблему самостоятельной ценности страницы и повторно проверьте live-версию URL.
Запросите повторный обход
Отправьте исправленный важный URL на повторную обработку и после нового обхода убедитесь, что поисковая система обновила его статус.
FAQ
Когда отсутствие страницы в индексе действительно проблема
Для конкретного URL используйте URL Inspection в Google Search Console. Инструмент показывает, известна ли страница Google, был ли успешен обход, разрешено ли индексирование и какой URL выбран каноническим. Оператор site: можно использовать только как дополнительную быструю проверку: Google не гарантирует полноту результатов этого оператора.
Код 200 OK — только одно из условий. Страница может иметь noindex, неправильный canonical, считаться дублем, быть слабо связана внутренними ссылками или быть исключена поисковой системой после обработки. Поэтому нужно смотреть конкретную причину в Search Console или Яндекс Вебмастере.
Нет. Технические URL, фильтры, корректные дубли, страницы с редиректами и специально закрытые документы могут законно отсутствовать в индексе. Проблема возникает, когда исключена каноническая страница, которая должна получать поисковый трафик.
Sitemap помогает поисковой системе обнаруживать нужные URL, но сам по себе не гарантирует их обход или индексирование. В карте сайта желательно оставлять канонические страницы, которые действительно должны участвовать в поиске, и одновременно поддерживать нормальную внутреннюю перелинковку.
Сначала повторно проверьте фактическую версию страницы и убедитесь, что техническая причина устранена. Затем можно запросить повторный обход в Search Console или Яндекс Вебмастере. После нового обхода проверяйте изменение статуса URL; позиции и трафик оцениваются уже отдельно от факта индексирования.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.