Страница в индексе — это URL, который поисковая система обнаружила, обработала и решила хранить в своей поисковой базе как вариант, способный участвовать в выдаче. Сам факт публикации, наличие URL в Sitemap или успешный обход роботом этого не гарантируют: между обнаружением страницы и её появлением в поиске есть несколько отдельных решений.
Для SEO важен не максимальный счётчик проиндексированных URL, а соответствие индекса реальной структуре сайта. Полезные посадочные должны быть доступны роботу и определяться как основные версии, а фильтры, дубли и служебные URL — не засорять поисковый контур.
Что именно происходит до попадания страницы в индекс
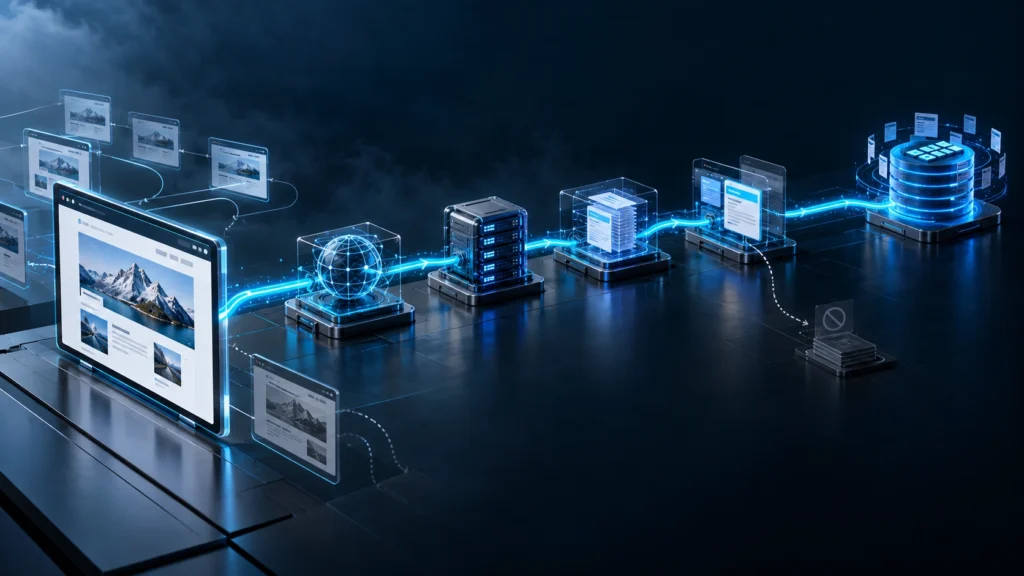
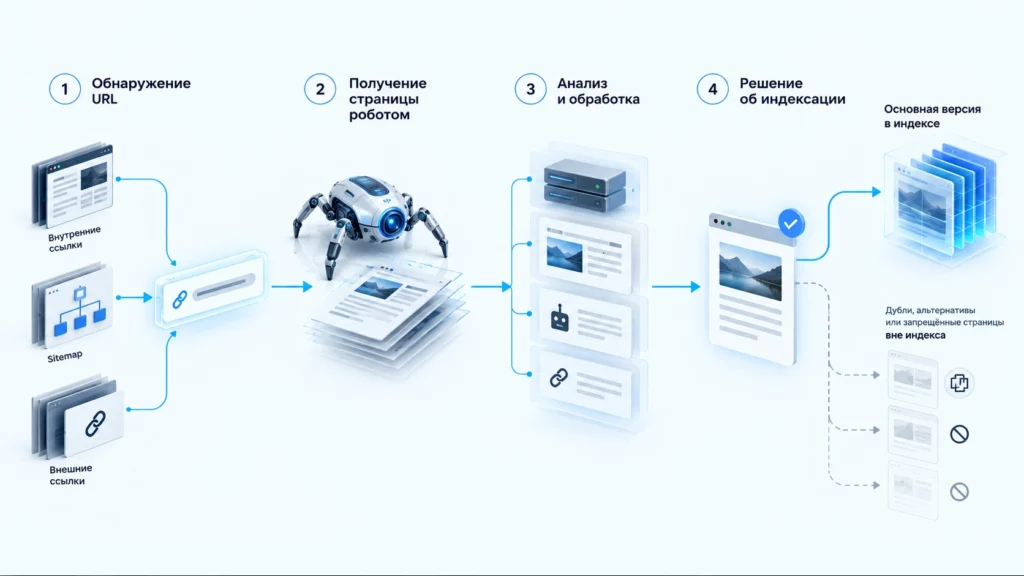
Условно путь URL можно разделить на четыре этапа: обнаружение, обход, обработка и решение об индексации. Поисковик узнаёт адрес из внутренних и внешних ссылок, Sitemap и уже известных ему URL, затем запрашивает страницу, анализирует ответ сервера, HTML, директивы для роботов, canonical, содержимое и связи с другими страницами.
Поэтому индексация сайта — не действие по кнопке и не одноразовая загрузка Sitemap. Это процесс, в котором поисковику сначала нужно найти URL, затем получить его содержимое и понять, какую версию страницы считать основной.
Даже при ответе 200 OK страница может не попасть в индекс. Причиной может быть noindex, выбранная поисковиком другая canonical-версия, дублирование, недостаточные сигналы для обнаружения или ситуация, когда URL известен и просканирован, но пока не выбран для индексации.
Как проверить страницы в индексе без ложных выводов
Для массовой оценки в Google удобнее начинать с отчёта индексирования страниц в Search Console: он показывает, какие известные Google URL были проиндексированы, а какие нет, и группирует причины. Для конкретного адреса нужен инструмент проверки URL — там важнее не общий график, а состояние именно этой страницы, выбранная canonical и данные последнего обхода.
В Яндекс Вебмастере проверяйте состояние конкретной страницы и причины исключения: например, HTTP-ошибку, noindex или неканоническую версию. После исправления URL можно отправить на повторный обход, но это не гарантирует включение в поиск.
Запрос site:example.com годится как быстрый ориентир и способ найти неожиданные URL, но не как точный счётчик. Google прямо предупреждает, что оператор site: не обязан показывать все проиндексированные адреса. Поэтому сравнивать «вчера было 800 результатов, сегодня 730» и сразу делать вывод о выпадении 70 страниц некорректно.
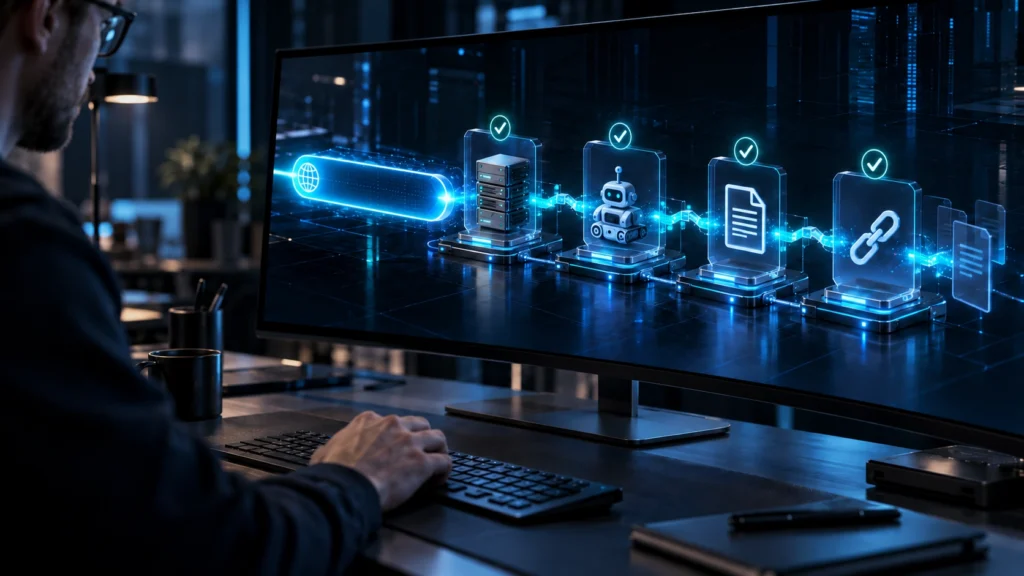
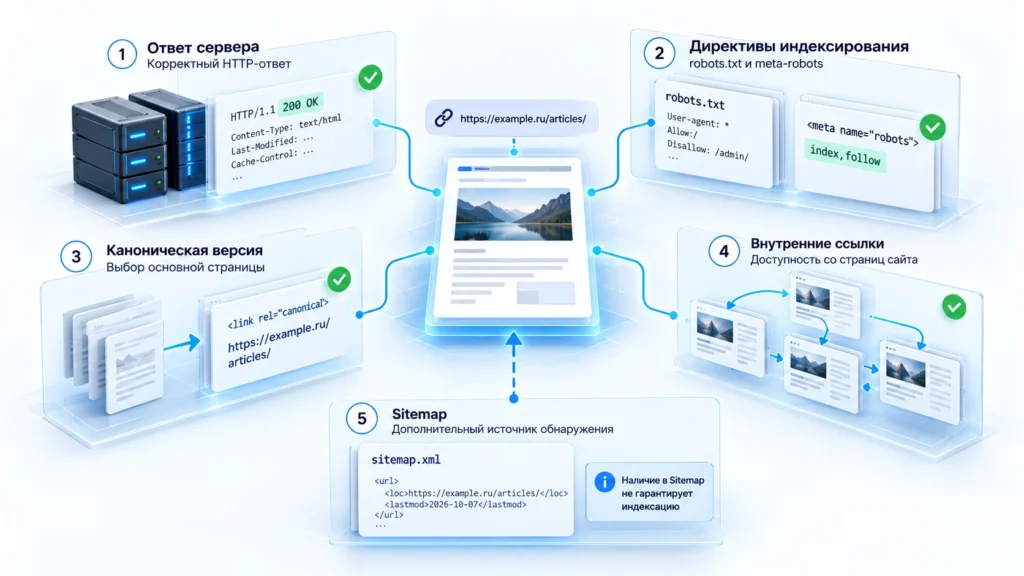
Для системной диагностики нужна проверка индексации по трём слоям:
| Слой | Что проверять | Нормальный результат |
|---|---|---|
| Доступность | HTTP-ответ, robots.txt, доступ без авторизации | важная страница отвечает корректно и доступна роботу |
| Индексируемость | meta robots, X-Robots-Tag, canonical | нет случайного noindex, canonical указывает на нужную версию |
| Обнаружение и связи | Sitemap, внутренние ссылки, глубина перехода | URL есть в актуальной структуре и не существует изолированно |
Для быстрой серверной проверки можно начать с заголовков ответа:
curl -I https://example.com/page/Нужно увидеть ожидаемый статус ответа и проверить, нет ли неожиданного X-Robots-Tag: noindex. Но одного curl -I недостаточно: директива noindex может находиться в HTML, а canonical — в <head>, поэтому финальную проверку делайте по исходному документу и данным поисковой системы.
Почему URL найден, но всё равно не индексируется
Статус «не в индексе» описывает результат, а не диагноз. У двух URL с одинаковым итогом причины могут быть разными.
Сначала исключите технический запрет
Проверьте ответ сервера, robots.txt, meta robots и X-Robots-Tag. Если страница закрыта от обхода в robots.txt, робот может не получить HTML и, следовательно, не увидеть находящийся внутри noindex. Поэтому смешивать Disallow и noindex без понимания задачи опасно: запрет обхода и запрет показа в поиске — разные механизмы.
Затем проверьте canonical и дубли
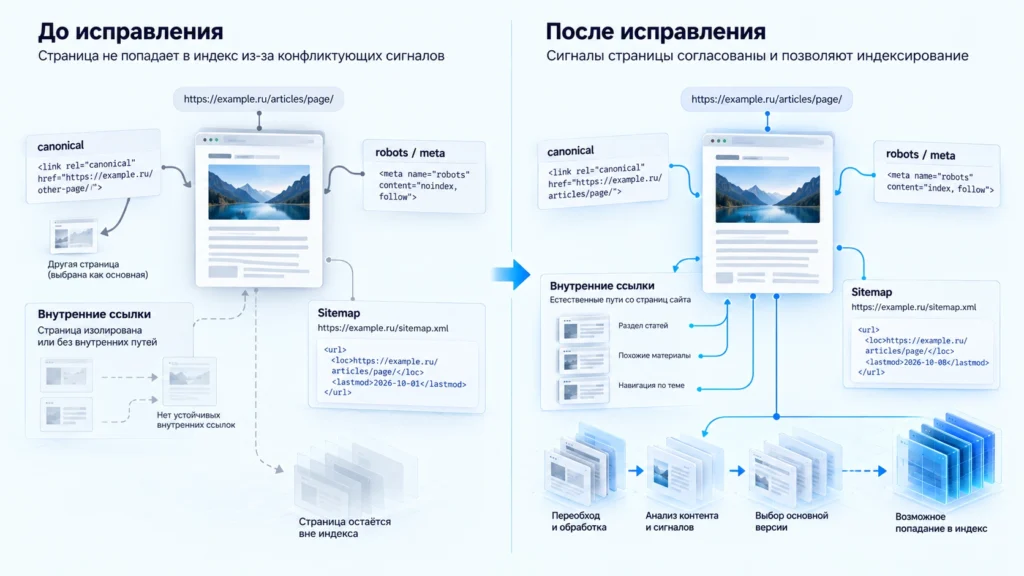
Если страница является дублем или очень близкой версией другой, поисковая система может выбрать другой URL как канонический. Сам rel="canonical" — сильный сигнал, но не абсолютная команда. Если Sitemap, внутренние ссылки, редиректы и canonical противоречат друг другу, сначала выровняйте эти сигналы.
Отдельно смотрите на статусы вроде crawled currently not indexed. Они не означают, что нужно бесконечно нажимать «Запросить индексирование». Сначала проверьте, самостоятельна ли страница по смыслу, не конкурирует ли она с другой посадочной, получает ли внутренние ссылки и действительно ли её нужно видеть в поиске.
Сиротские страницы проверяйте как отдельный класс
URL может быть открыт для робота и находиться в Sitemap, но не иметь нормального пути из структуры сайта. Такие orphan pages хуже связаны с остальным контентом.
Если важная публикация существует только в Sitemap, добавьте её в тематический хаб, категорию или контекстные связи. Отдельная задача страницы без ссылок полезна именно как аудит структуры: она показывает не «штраф», а разрыв между опубликованным URL и реальной навигацией сайта.
Как исправлять проблему: от причины, а не от симптома
Не начинайте с массовой отправки URL на переобход. Сначала выберите 5–10 проблемных страниц одного типа и для каждой зафиксируйте: текущий HTTP-статус, индексируемость, canonical, наличие в Sitemap, число и качество внутренних путей, а также состояние в поисковой панели.
Если обнаружен технический запрет, исправьте его и повторно проверьте страницу. Если canonical ведёт не туда — устраните конфликт между canonical, редиректами, Sitemap и внутренними ссылками. Если URL оказался дублем, правильным решением может быть не «добиться индексации», а объединить сигналы на основной странице.
Для Яндекса после исправления отдельного URL можно использовать переобход страниц яндекс, но это способ сообщить о новой или обновлённой странице, а не гарантия результата. Для Google запрос индексирования в проверке URL работает по той же логике: сначала URL должен быть технически доступен и иметь смысл как самостоятельная страница.
Практический сценарий
Предположим, после публикации 60 новых статей в индексе появились только 38. Массовый вывод «поисковик не любит новый раздел» ничего не объясняет.
Проверка выборки показывает три группы:
- У 8 страниц ошибочно остался
noindexиз шаблона черновика. - У 6 страниц canonical указывает на родительскую рубрику.
- Ещё 8 URL доступны и уникальны, но на них нет ссылок из хабов и старых материалов.
Первые две группы требуют технического исправления. Для третьей нужно восстановить внутреннюю архитектуру и убедиться, что URL включены в актуальный Sitemap. После этого проверяются конкретные адреса, а не только общий счётчик. Если страницы начинают корректно определяться как индексируемые и после повторного обхода переходят в индекс, причина подтверждена.
Если технические сигналы чистые, сравните проблемные URL с уже индексируемыми страницами того же типа: интент, уникальность содержания, повторяемость шаблона и конкуренцию между собственными URL.
Что считать исправлением
Успех — не рост числа URL сам по себе. Нормальная картина выглядит так: важные страницы доступны и индексируются, исключённые URL имеют понятную причину, canonical и Sitemap не конфликтуют, а внутренние ссылки ведут на те версии, которые вы действительно хотите показывать в поиске.
После изменений проверьте выборку URL повторно в Google Search Console и Яндекс Вебмастере. Для больших сайтов полезно сопоставлять данные поисковых систем с собственным краулером и списком канонических URL. Это помогает отличить реальное выпадение посадочных от технических дублей, параметров и адресов, которые вообще не должны были попадать в индекс.
FAQ
Когда страница действительно готова к индексации
Это означает, что поисковый робот уже получил страницу, но URL пока не включён в поисковый индекс. Сам факт обхода не гарантирует индексацию. Проверьте canonical, дубли, внутренние связи, индексируемость страницы и то, является ли она самостоятельной полезной посадочной.
Нет. Google прямо указывает, что оператор site: не обязан возвращать полный список проиндексированных URL. Его удобно использовать для быстрой выборочной диагностики, но точные выводы по конкретным страницам лучше делать через Search Console и проверку URL.
Обычно нет. Поисковые системы находят страницы через ссылки, Sitemap и повторный обход сайта. Ручной запрос полезен для отдельных новых или исправленных URL, но он не заменяет нормальную архитектуру сайта и не гарантирует включение страницы в индекс.
Запрет обхода и запрет индексации — разные механизмы. Если робот не может получить страницу из-за robots.txt, он может не увидеть размещённый внутри HTML noindex. Для удаления страницы из поиска нужно выбирать метод с учётом требований конкретной поисковой системы, а не считать Disallow универсальным способом.
Сначала убедитесь, что сервер отдаёт ожидаемый ответ, запреты отсутствуют, canonical выбран правильно и URL связан с сайтом внутренними ссылками. После повторного обхода проверьте состояние конкретной страницы в Google Search Console и Яндекс Вебмастере. Сам рост общего числа URL без проверки причин не подтверждает исправление.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.