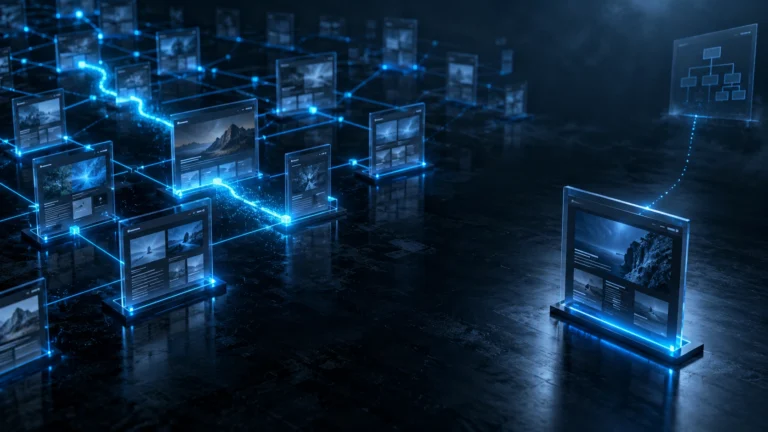
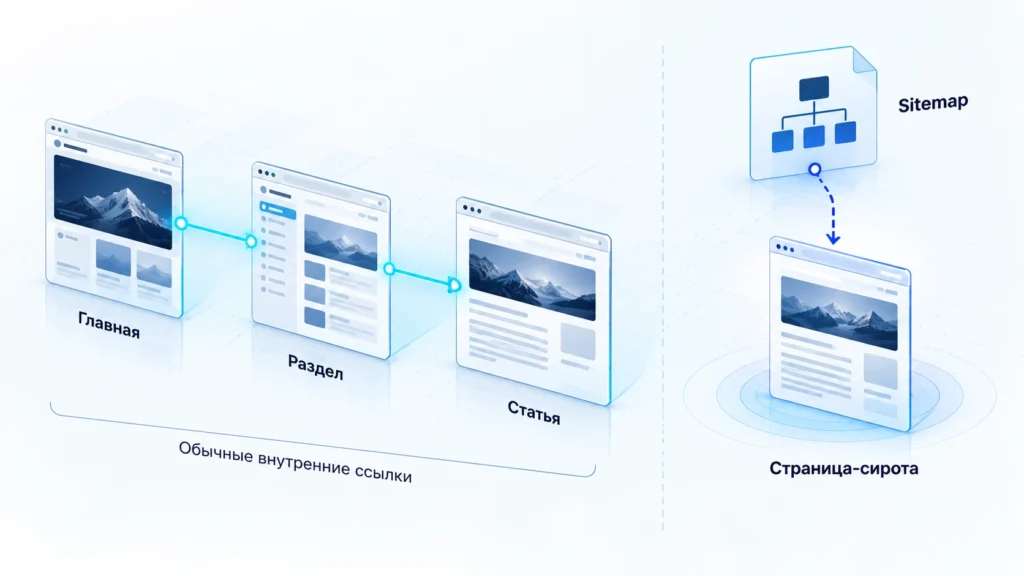
Страницы без ссылок внутри сайта часто возникают, когда URL опубликован, но не встроен в обычную навигацию и внутреннюю перелинковку. Такой адрес может быть известен Google или Яндексу через Sitemap, внешнюю ссылку или историю обхода, но пользователь и обычный краулер не получают к нему нормального пути.
В SEO такой URL обычно называют orphan page, или страницей-сиротой. Для аудита важен не термин, а проверяемый признак: нужная страница не обнаруживается при обычном обходе сайта по внутренним crawlable-ссылкам от главной или другого стартового узла.
Как понять, что URL действительно orphan page
Страницу-сироту легко спутать с «тупиковой» страницей. Если на URL можно перейти с другой страницы сайта, но с него самого почти некуда идти дальше, это не orphan page: входящая внутренняя связь у него есть.
Удобный критерий:
URL существует → должен быть доступен пользователям → при crawl от главной не найден → известен из другого источника
Например, статья присутствует в XML Sitemap, но ни архив рубрики, ни блок связанных материалов, ни другие страницы на неё не ссылаются. Обычный краулер её не увидит. Если дополнительно загрузить Sitemap или данные поисковой консоли, адрес появится в сравнении.
Google Search Central прямо рекомендует, чтобы каждая важная страница имела ссылку хотя бы с одной другой страницы сайта. Для надёжного обхода Google рекомендует обычный элемент <a> с href, а не навигацию, существующую только как JavaScript-событие.
Почему страницы без ссылок могут оставаться известными поиску
Отсутствие внутренних ссылок не означает автоматически, что страница не индексируется.
Google может узнать URL из Sitemap, старых ссылок и других источников. URL Inspection в Search Console показывает сведения об обнаружении, обходе и Sitemap для конкретного адреса. При этом Google отдельно подчёркивает: Sitemap помогает сообщить о URL, но не гарантирует их обход или индексирование.
Яндекс также учитывает внутренние и внешние ссылки, Sitemap и другие источники при формировании списка известных страниц. В документации Яндекса Sitemap отдельно рекомендуется для сайтов с большим числом страниц, глубокой структурой и страницами без навигационных ссылок.
Поэтому orphan page — прежде всего дефект архитектуры и обнаружения. Нельзя обещать, что добавление одной ссылки автоматически повысит позиции, но для важной страницы отсутствие нормального внутреннего пути стоит исправлять.
Как найти orphan pages: сравнивайте разные источники URL
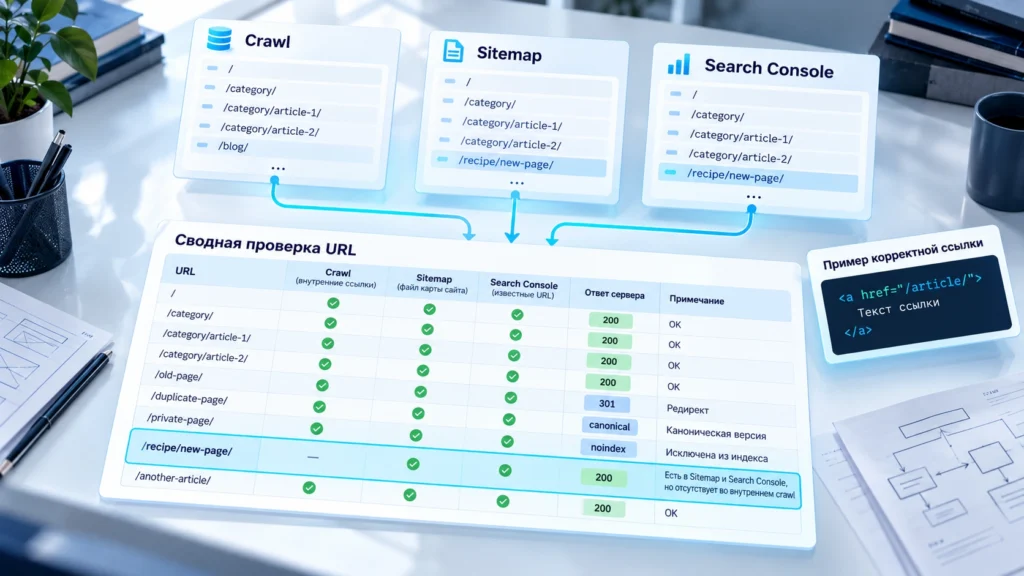
Один обычный crawl не может показать полный список сирот: если до URL нет пути по ссылкам, краулер не знает, что он существует. Поэтому нужно сравнить URL, найденные при обходе от главной, с независимыми источниками: XML Sitemap, CMS, Search Console, Яндекс Вебмастером, аналитикой или логами.
| Источник | Для чего нужен |
|---|---|
| Crawl от главной | Показывает реально связанный внутренний граф |
| XML Sitemap | Находит URL, заявленные поисковикам, но не найденные crawl |
| CMS / база | Показывает фактически опубликованные сущности |
| Search Console | Находит известные Google URL с поисковыми данными |
| Яндекс Вебмастер | Помогает проверить обход известных Яндексу страниц |
| Логи | Показывают реальные обращения поисковых роботов |
Практическая формула: известные URL − URL из внутреннего crawl = кандидаты на orphan pages.
Для точечной проверки полезен Google Search Console для SEO: URL Inspection показывает, что Google знает о конкретной странице. Но консоль не заменяет полноценный crawl и сравнение списков.
Каждый кандидат нужно проверить вручную. В разнице могут оказаться не только полезные статьи, но и старые посадочные, редиректы, технические URL, фильтры и намеренно изолированные страницы.
Что делать с найденной страницей-сиротой
Если страница полезна, актуальна и должна получать органический трафик, верните её в структуру: добавьте релевантную ссылку из хаба, категории, статьи по теме или блока связанных материалов. Важно, чтобы внутренние ссылки сайта были обычными crawlable-ссылками и вели сразу на канонический URL.
Если URL устарел и у него есть очевидная замена, логичнее перенаправить его на релевантную новую страницу. Если замены нет и адрес больше не нужен, уберите его из Sitemap и выберите подходящий HTTP-ответ или директиву индексирования по реальной задаче. Сам статус orphan не является основанием автоматически ставить noindex или 301.
Техническую страницу, которая нужна пользователю по прямому сценарию, но не должна участвовать в поиске, не нужно искусственно «лечить» SEO-ссылками. Сначала определите, должна ли она индексироваться и быть частью публичной структуры.
Частые технические ошибки
Первая ошибка — добавить URL только в Sitemap и считать задачу закрытой. Карта сайта помогает обнаружению, но не заменяет нормальную архитектуру ссылок.
Вторая — поставить навигацию через элемент без обычного <a href="...">. Визуально кнопка может работать, но для обхода надёжнее стандартная crawlable-ссылка.
Третья — связать несколько orphan pages только между собой. Если весь кластер недостижим из основной структуры, crawl от главной по-прежнему его не увидит.
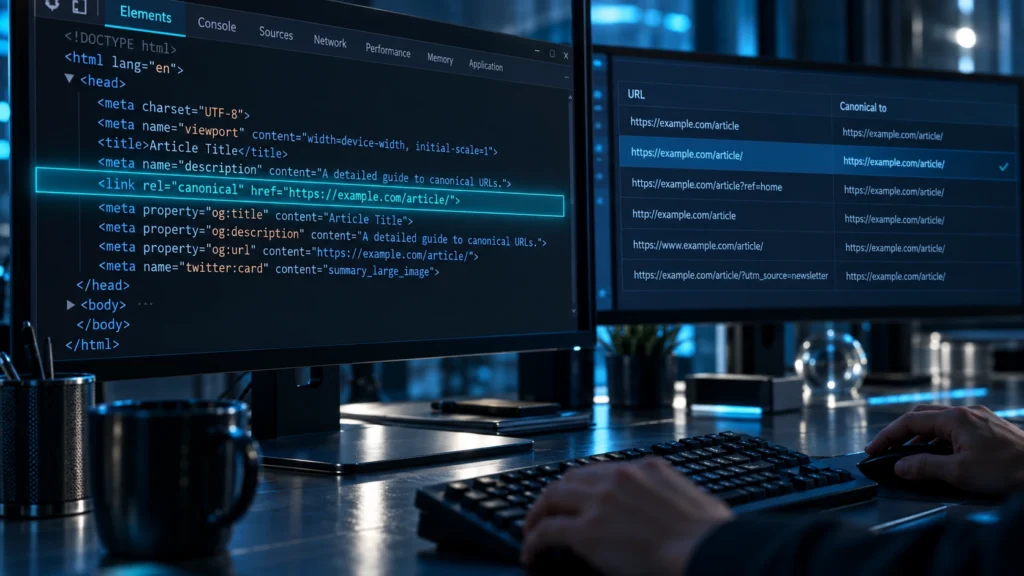
Четвёртая — вести ссылку на URL, который редиректит, канонизируется на другую страницу или закрыт от индексирования. Перед перелинковкой проверьте конечный ответ, canonical и robots directives.
Пятая — применять одно решение ко всем найденным URL. Полезной статье, старой кампании, дублю и технической странице нужны разные действия.
Практический пример и критерий исправления
Допустим, на сайте 500 опубликованных материалов. Crawl от главной нашёл 488, а в Sitemap находятся 500. Разница — 12 URL. Это не готовый список ошибок, а список для классификации.
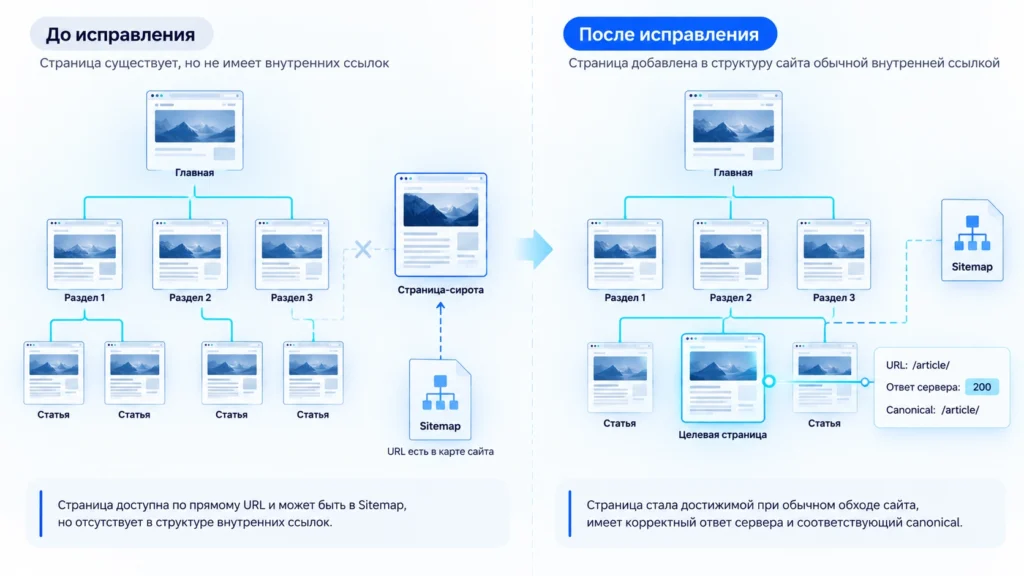
После проверки 6 статей оказываются актуальными и индексируемыми — им добавляют контекстные ссылки из тематических страниц. Две старые посадочные заменены новыми — для них настраивают релевантный редирект и убирают старые URL из Sitemap. Три технические страницы не предназначены для поиска — их приводят в соответствие с выбранной политикой индексирования. Ещё одна статья выпала из архива рубрики из-за ошибки шаблона — исправляют сам шаблон.
Затем сайт краулят повторно. Для важной страницы нормальный результат такой: она обнаруживается через внутренние ссылки, отвечает 200, не конфликтует с canonical и директивами индексирования и остаётся в Sitemap, если действительно должна участвовать в поиске.
Для важных исправленных URL можно использовать переобход страниц, но повторный обход не заменяет исправление структуры и не гарантирует попадание в индекс или рост позиций.
Если orphan pages появляются массово из-за структуры разделов, шаблонов CMS или слабой перелинковки, исправлять отдельные URL по одному мало: комплексное SEO-продвижение с аудитом перелинковки должно сначала выявить системную причину, а затем вернуть важные страницы в нормальный внутренний граф сайта.
FAQ
Когда orphan page действительно требует исправления
Практически это существующий URL, который не обнаруживается при обычном обходе сайта по внутренним ссылкам от главной или другого стартового узла. При этом страница может быть известна из Sitemap, поисковой консоли, внешних ссылок или других источников. Важно отличать её от страницы, на которую ведёт внутренняя ссылка, но с которой нет исходящих переходов.
Да. Поисковая система может узнать URL через Sitemap, внешний или ранее обнаруженный маршрут. Поэтому отсутствие внутренних ссылок нельзя автоматически приравнивать к отсутствию страницы в индексе.
Краулер обычно начинает с заданной страницы и следует по найденным внутренним ссылкам. Если до URL нет такого маршрута, он не может обнаружить его самостоятельно. Поэтому результаты crawl нужно сравнивать с независимыми списками URL — Sitemap, CMS, Search Console, аналитикой или логами.
Нет, если это важная публичная страница, которая должна быть частью структуры сайта. Sitemap помогает поисковику узнать об URL, но Google прямо указывает, что это не гарантия обхода или индексирования. Для важных страниц нужен нормальный доступ по внутренним crawlable-ссылкам.
Нет. Сначала нужно определить назначение URL. Полезную индексируемую страницу обычно возвращают в структуру, устаревшую страницу с подходящей заменой можно перенаправить, а технический или ненужный URL обрабатывают согласно выбранной политике индексирования.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.