Когда XML-карт становится несколько, поисковой системе необязательно передавать каждую из них по отдельности. Для этого используется sitemap index: он содержит адреса дочерних Sitemap, которые поисковый робот может загрузить и обработать отдельно.
Это особенно удобно для крупных сайтов и CMS, где URL уже разделены по типам материалов, разделам или пакетам. Но сам факт наличия sitemap index не означает, что перечисленные страницы автоматически попадут в поиск. Карта сайта помогает обнаружению URL и передаёт поисковой системе дополнительную информацию, а решение о сканировании и индексировании принимается отдельно.
Как устроен Sitemap index и что в нём должно находиться
Обычная XML Sitemap содержит записи <url> с адресами страниц. Sitemap index устроен иначе: внутри него находятся записи <sitemap>, каждая из которых указывает на отдельную карту сайта.
Минимальный рабочий пример выглядит так:
<?xml version="1.0" encoding="UTF-8"?>
<sitemapindex xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
    <sitemap>
        <loc>https://example.com/post-sitemap.xml</loc>
        <lastmod>2026-10-09T10:15:00+00:00</lastmod>
    </sitemap>
    <sitemap>
        <loc>https://example.com/page-sitemap.xml</loc>
        <lastmod>2026-10-08T18:40:00+00:00</lastmod>
    </sitemap>
</sitemapindex>
Здесь обязательны три уровня:
<sitemapindex>— корневой элемент индекса;<sitemap>— контейнер для одной дочерней карты;<loc>— абсолютный URL этой карты.
<lastmod> необязателен. В индексе он должен обозначать время изменения именно дочернего файла Sitemap, а не произвольную дату обновления какой-либо страницы внутри него.
По протоколу один Sitemap ограничен 50 000 URL и 50 МБ в несжатом виде. Если сайт выходит за один из этих лимитов, содержимое разбивают на несколько файлов, а их адреса собирают в индекс. Сам индекс также может содержать до 50 000 записей о Sitemap.
На практике индекс полезен задолго до достижения предельного размера. Например, интернет-магазину удобнее держать товары, категории и информационные материалы в разных картах: так проще увидеть, какая группа URL перестала обновляться или начала отдавать ошибки.
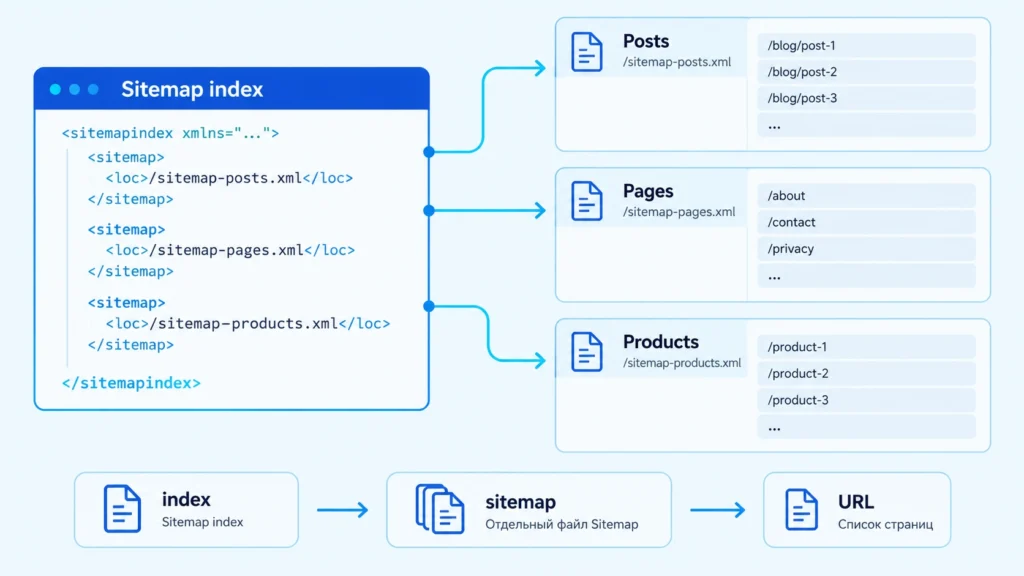
Если задача состоит в том, чтобы впервые создать sitemap, важно не начинать сразу с индекса. Сначала определяют, какие URL действительно должны передаваться поисковым системам, и только затем решают, требуется ли разделение на несколько файлов.
Почему Sitemap помогает обходу, но не гарантирует индексацию
Sitemap — это канал обнаружения URL, а не команда на добавление страницы в поисковый индекс.
У поисковой системы остаются отдельные этапы: получение адреса, сканирование страницы, обработка содержимого, определение канонического URL и решение об индексировании. Поэтому ситуация «URL присутствует в Sitemap, но отсутствует в поиске» сама по себе не доказывает ошибку Sitemap.
Практически это означает, что нужно разделять два вопроса:
| Что проверяем | Что показывает проверка |
|---|---|
| Sitemap index успешно загружается | Поисковик может получить список дочерних карт |
| Дочерняя Sitemap успешно обрабатывается | Поисковик смог разобрать содержащиеся в ней URL |
| URL обнаружен через Sitemap | Поисковик знает об адресе |
| URL просканирован | Робот запросил страницу |
| URL индексируется | Страница прошла отдельный этап обработки и пригодна для поиска |
Именно поэтому число обнаруженных страниц в инструменте для Sitemap нельзя автоматически приравнивать к числу индексируемых.
Sitemap также не заменяет внутреннюю перелинковку. Если важная страница существует только в XML и на неё невозможно перейти по обычным ссылкам сайта, наличие адреса в Sitemap решает лишь проблему обнаружения, но не исправляет архитектуру сайта.
Для передачи информации о новых и изменённых URL существуют и другие механизмы. Их не стоит смешивать с XML-картой: IndexNow и Индексация решают смежную задачу передачи сигналов об изменениях, тогда как Sitemap описывает набор доступных поисковику URL и их структуру.
Что проверять в sitemap index до Search Console и Вебмастера
Первая диагностика выполняется на самом сайте. Панель поисковой системы не должна быть первым местом, где обнаруживается техническая ошибка.
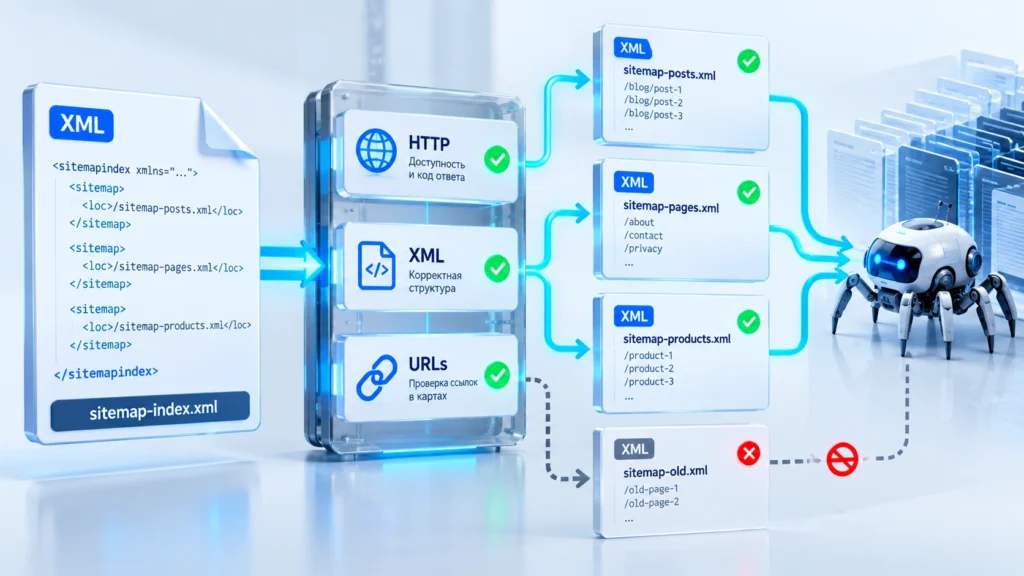
Начните с URL индекса. Для рабочего файла важны четыре вещи:
- Сервер действительно отдаёт XML, а не HTML-страницу ошибки.
- HTTP-ответ соответствует нормальной доступности файла.
- Каждый
<loc>ведёт на существующую дочернюю карту. - Дочерние карты содержат те URL, которые вы действительно хотите передавать поиску.
Для быстрой серверной проверки достаточно посмотреть заголовки ответа:
curl -I https://example.com/sitemap_index.xmlЕсли сервер поддерживает обычный запрос корректно, ожидается успешный ответ. После этого полезно получить сам документ:
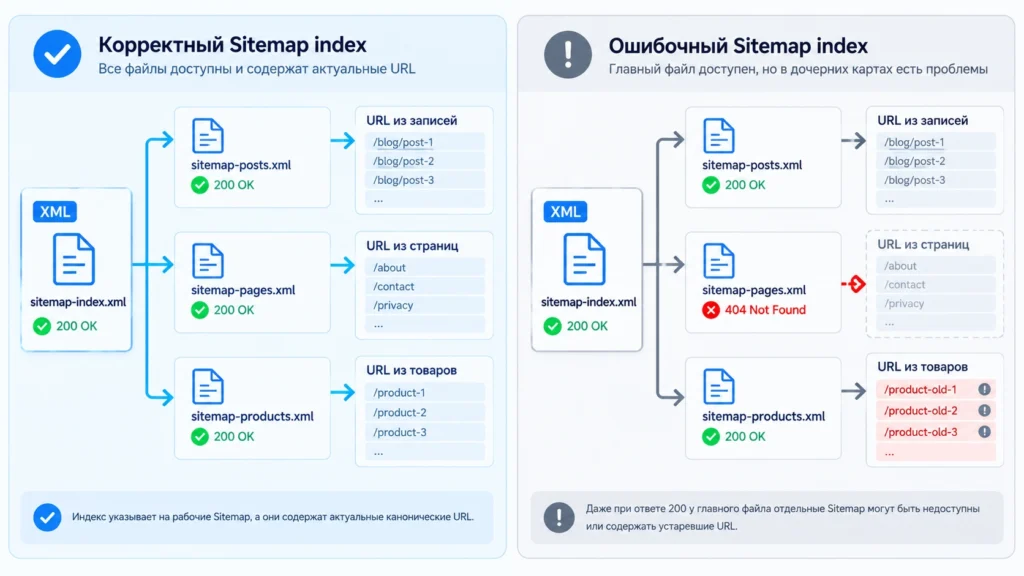
curl -s https://example.com/sitemap_index.xmlПроверять нужно не только главный файл. Возьмите несколько <loc> из индекса и повторите запрос для них. Типичная неисправность выглядит так: индекс открывается с 200 OK, но одна из дочерних карт возвращает 404, 403, 5xx или ведёт через ошибочную цепочку перенаправлений.
Отдельно проверьте XML. Условный индекс sitemap может выглядеть корректно в браузере благодаря XSL-оформлению, хотя в исходном XML уже присутствует неправильный URL или отсутствует обязательный элемент.
Какие URL должны попадать в дочерние карты
Для Google практический ориентир — передавать URL, которые вы хотите видеть в результатах поиска, и использовать полные абсолютные адреса.
Это означает, что в карте обычно нет смысла сохранять:
- страницы, намеренно закрытые от индексации;
- служебные результаты поиска и фильтры без отдельного поискового интента;
- старые URL после окончательной миграции;
- технические дубли;
- адреса, которые не являются выбранной канонической версией страницы.
Sitemap не является инструментом запрета. Если страницу нужно исключить из поиска, задача решается соответствующим механизмом самой страницы или управления обходом, а не удалением URL из XML как единственной мерой.
Отдельные расширения протокола применяются для специализированного контента. Например, image sitemap имеет смысл рассматривать отдельно, когда сайту важно помочь поисковой системе обнаруживать изображения и передавать относящиеся к ним данные.
Как проверить обработку в Google Search Console и Яндекс Вебмастере
После серверной проверки индекс можно контролировать через инструменты поисковых систем.
В Google Search Console отчёт Sitemaps показывает тип отправленного файла, дату отправки, время последнего чтения, статус обработки и количество обнаруженных страниц. Для sitemap index число обнаруженных страниц агрегируется по дочерним картам, причём дубли URL учитываются один раз.
Особенно полезны три состояния:
Success— файл получен и обработан без ошибок;Has errors— файл доступен, но при разборе обнаружены проблемы;Couldn't fetch— Google не смог получить Sitemap.
Даже статус успешной обработки не следует трактовать как подтверждение индексирования всех URL. Для этого отдельно анализируют отчёт индексирования страниц и конкретные URL.
В Яндекс Вебмастере Sitemap также можно добавить отдельным URL и отслеживать обработку. Яндекс рекомендует дополнительно проверять файл валидатором и отдельно контролировать ответ сервера. Для sitemap index дочерние карты обрабатываются как отдельные файлы.
Ещё один способ сообщить поисковым системам расположение индекса — директива в robots.txt:
Sitemap: https://example.com/sitemap_index.xmlЕсли используется индекс, перечислять в robots.txt все вложенные Sitemap обычно не требуется: поисковый робот получает их адреса из самого файла индекса.
Не оценивайте качество Sitemap только по статусу «успешно»
Технически валидный XML ещё не означает, что его содержимое соответствует структуре сайта.
Например, индекс может успешно обрабатываться, но одна карта продолжает содержать удалённые URL. Другой вариант — генератор создаёт карту архива, который закрыт noindex. В обоих случаях исправлять нужно источник генерации, а не повторно отправлять тот же файл в панель поисковой системы.
Как использовать lastmod без ложных сигналов
Внутри sitemap index тег <lastmod> относится к дочерней Sitemap. Он должен меняться, когда реально изменился соответствующий файл.
Например, если в post-sitemap.xml добавлена новая статья, содержимое дочерней карты изменилось — дата обновления этого файла оправданна. Если ничего не изменилось, бессмысленно каждый час выставлять новое время только для создания видимости свежести.
Поисковым системам полезнее последовательный сигнал, основанный на реальных изменениях, чем постоянно обновляемая дата без связи с содержимым.
Эта логика особенно важна на сайтах с автоматической генерацией XML. Если требуется глубже разобраться именно с датами изменения, lastmod sitemap лучше рассматривать как отдельный уровень настройки: дата страницы внутри Sitemap и дата дочернего файла внутри sitemap index описывают разные объекты.
WordPress: когда индекс уже существует без дополнительного PHP
В WordPress собственная система XML Sitemap появилась в ядре начиная с версии 5.5. При обычной конфигурации постоянных ссылок главный индекс доступен по адресу:
https://example.com/wp-sitemap.xmlWordPress формирует дочерние карты через провайдеры и собирает их в общий индекс. Поэтому писать отдельный sitemap index php только ради появления XML на стандартном сайте обычно не требуется.
Сначала стоит проверить:
/wp-sitemap.xmlа затем посмотреть, какие дочерние карты перечислены внутри. Если сайт использует SEO-плагин или собственный механизм Sitemap, фактический адрес и состав XML могут отличаться.
Важно избегать ситуации, когда параллельно существуют несколько конкурирующих генераторов и неизвестно, какой индекс считается основным. Наличие нескольких технически доступных Sitemap само по себе не является преимуществом — важнее, чтобы используемая поисковиками структура была актуальной и предсказуемой.
Пример собственного Sitemap index на PHP
Для проекта без CMS индекс можно сформировать динамически. Минимальный пример:
<?php

header('Content-Type: application/xml; charset=UTF-8');

$sitemaps = [
    [
        'loc' => 'https://example.com/sitemap-pages.xml',
        'lastmod' => '2026-10-09T10:00:00+00:00',
    ],
    [
        'loc' => 'https://example.com/sitemap-products.xml',
        'lastmod' => '2026-10-09T11:30:00+00:00',
    ],
];

echo '<?xml version="1.0" encoding="UTF-8"?>' . PHP_EOL;
echo '<sitemapindex xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">' . PHP_EOL;

foreach ($sitemaps as $sitemap) {
    echo '  <sitemap>' . PHP_EOL;
    echo '    <loc>' .
        htmlspecialchars($sitemap['loc'], ENT_XML1 | ENT_QUOTES, 'UTF-8') .
        '</loc>' . PHP_EOL;

    echo '    <lastmod>' .
        htmlspecialchars($sitemap['lastmod'], ENT_XML1 | ENT_QUOTES, 'UTF-8') .
        '</lastmod>' . PHP_EOL;

    echo '  </sitemap>' . PHP_EOL;
}

echo '</sitemapindex>';
Это демонстрационный вариант, а не готовая архитектура для любого проекта. В рабочей системе список дочерних карт и lastmod лучше получать из реального состояния базы или процесса генерации, а не поддерживать вручную.
Практический сценарий: индекс открывается, но часть URL не появляется в поиске
Предположим, сайт содержит 80 000 индексируемых страниц. Генератор разделяет их на четыре дочерние Sitemap, а общий /sitemap_index.xml открывается без ошибок.
При этом в панели поисковой системы отображается значительно меньше обнаруженных URL, чем ожидается.
Начинать с предположения о «штрафе поисковика» не нужно. Диагностика выглядит практичнее:
Исходное состояние. Главный индекс возвращает 200 OK, XML визуально выглядит нормальным.
Проверка дочерних файлов. Выясняется, что один <loc> ссылается на старое имя products-sitemap-2.xml, которое после изменения генератора стало возвращать 404.
Проверка содержимого. В другой карте присутствует несколько тысяч URL со старой схемой параметров, которые уже не являются каноническими.
Исправление. Генератор начинает отдавать актуальный адрес дочернего файла и исключает устаревшие URL. После этого заново проверяются XML, HTTP-ответы и соответствие количества URL ожидаемой структуре.
Контроль результата. Успехом считается не мгновенный рост поискового трафика, а устранение технического расхождения: все дочерние карты доступны, поисковая система может их обработать, а обнаруживаемые URL соответствуют текущему набору индексируемых страниц.
Такой подход отделяет техническую проверку Sitemap от анализа качества и индексируемости самих страниц. Если XML уже исправен, а конкретный URL по-прежнему отсутствует в поиске, дальше нужно проверять именно страницу: доступность для робота, canonical, noindex, ответ сервера, дублирование, качество содержимого и другие причины.
Sitemap index стоит считать исправным, когда он отражает реальную структуру индексируемых URL, дочерние карты стабильно доступны, XML проходит проверку, а поисковые системы могут регулярно получать изменения. Всё остальное — количество проиндексированных страниц, скорость переобхода и позиции — нужно оценивать отдельно, не приписывая XML-карте возможностей, которых у неё нет.
Практика
Как проверить и исправить Sitemap index
Зафиксируйте текущую структуру
Сохраните текущий Sitemap index, список дочерних карт и настройки генератора, чтобы после изменения можно было сравнить структуру и быстро выполнить откат.
Проверьте ответы сервера
Убедитесь, что индекс и несколько дочерних Sitemap доступны поисковым роботам и возвращают ожидаемый HTTP-ответ без циклических редиректов и серверных ошибок.
Проверьте XML и URL
Проверьте структуру sitemapindex, теги loc, корректность адресов дочерних файлов и соответствие содержащихся в них URL каноническим индексируемым страницам сайта.
Исправьте источник генерации
Вносите исправление в CMS, PHP-генератор или SEO-модуль, а не вручную в автоматически создаваемый XML; сначала проверьте изменение на тестовой среде или ограниченной группе Sitemap.
Отправьте индекс поисковикам
После проверки укажите Sitemap index в Google Search Console и Яндекс Вебмастере либо убедитесь, что поисковые системы получают его через корректную директиву Sitemap в robots.txt.
Проверьте обработку URL
После повторного чтения Sitemap сопоставьте статус файлов, количество обнаруженных URL и фактическое индексирование страниц; отсутствие страницы в индексе диагностируйте уже отдельно от Sitemap.
FAQ
Когда Sitemap index работает правильно, а когда требует исправления
Это XML-файл со списком других файлов Sitemap. Вместо передачи поисковой системе одной огромной карты сайта вы разделяете URL на несколько карт, а их адреса собираете в одном индексе. Поисковик получает индекс и затем загружает перечисленные в нём файлы.
Прямого правила «есть Sitemap index — позиции выше» нет. Sitemap помогает поисковой системе обнаруживать важные URL и отслеживать изменения, поэтому может улучшить техническую управляемость обхода. Однако попадание страницы в Sitemap не гарантирует ни сканирование, ни индексирование, ни конкретную позицию.
Откройте URL индекса и проверьте ответ сервера, XML-структуру и адреса дочерних Sitemap. Затем проверьте несколько дочерних файлов и их URL, после чего посмотрите статус обработки в Google Search Console и Яндекс Вебмастере. Отдельно полезно сопоставить количество URL в картах с фактическим числом канонических индексируемых страниц.
Частые проблемы — HTTP-ошибки, ссылки на несуществующие дочерние карты, неправильный XML, устаревший lastmod, URL другого хоста и попадание в дочерние карты технических или неканонических страниц. Ещё одна ошибка — считать успешную обработку Sitemap подтверждением индексации всех перечисленных URL.
Сначала исключите проблемы доступности: проверьте HTTP-код, robots.txt, XML и каждый проблемный дочерний файл. После исправления повторно отправьте индекс через соответствующий инструмент поисковой системы и следите за датой последнего чтения, статусом обработки и индексированием самих страниц. Если индекс читается корректно, искать причину отсутствия URL в поиске нужно уже на уровне конкретных страниц.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.