Страница может выглядеть безупречно у посетителя и одновременно отдавать поисковому роботу почти пустой документ. Особенно часто это встречается в проектах, где основной текст, карточки товаров, навигация или метаданные формируются JavaScript уже после загрузки начального HTML.
Именно здесь рендеринг страницы становится задачей технического SEO. Проверять нужно не наличие React, Vue, Next.js или другого фреймворка само по себе, а результат: какой код получает робот, что появляется после выполнения скриптов и доступны ли ему элементы, по которым страницу можно обнаружить, понять и проиндексировать.
В контексте SEO под рендерингом веб-страницы обычно понимают обработку HTML, CSS и JavaScript браузерным движком. Это не то же самое, что аппаратный рендеринг с помощью видеокарты: GPU может участвовать в отрисовке интерфейса пользователя, но проблема поисковой индексации находится уровнем выше — в доступности содержимого и структуры документа.
Что происходит с JavaScript-страницей до индексирования
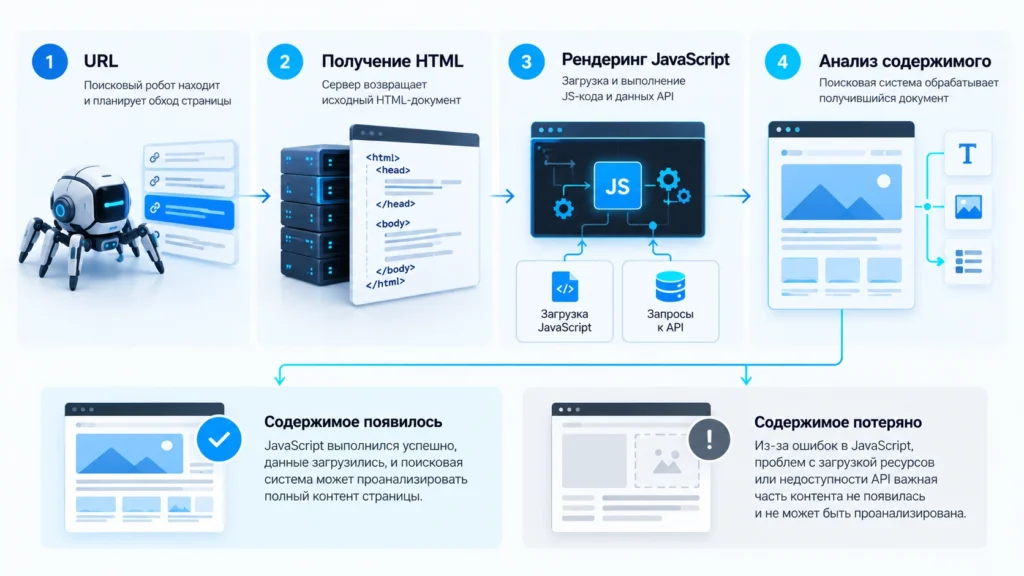
Упрощённо путь страницы можно представить так:
- поисковый робот обнаруживает URL;
- сервер отвечает на запрос;
- робот получает первоначальный HTML и доступные ресурсы;
- при необходимости выполняется JavaScript;
- получается отрендеренная версия документа;
- поисковая система анализирует полученное содержимое и принимает дальнейшие решения об индексировании.
У Google обход, рендеринг и индексирование являются отдельными этапами. Для JavaScript-сайта это принципиально: первоначальный HTML может содержать только каркас приложения, а текст и другие элементы появятся позднее после исполнения кода.
Например, сервер может вернуть документ примерно такого вида:
<div id="app"></div>
<script src="/app.js"></script>
Человек этого не замечает: браузер загружает скрипт, обращается к API и через мгновение показывает полноценную страницу. Но для технического SEO возникает дополнительная зависимость. Чтобы увидеть тот же результат, робот должен успешно получить скрипт, выполнить его, дождаться необходимых запросов и сформировать итоговый HTML.
Чем больше критичного содержимого зависит от этой цепочки, тем больше точек отказа.
| Подход | Что получает клиент сразу | Что важно для SEO |
|---|---|---|
| SSR | HTML с содержимым формируется сервером | Основной контент доступен уже в ответе сервера |
| SSG / пререндеринг | Заранее сформированный HTML | Результат обычно легко проверить и воспроизвести |
| CSR | Сервер может отдавать только оболочку приложения | Нужно убедиться, что робот действительно получает контент после JavaScript |
| SSR с гидратацией | Содержимое приходит в HTML, затем JS добавляет интерактивность | Важно не сломать уже доступный контент во время гидратации |
Ни один из этих вариантов автоматически не делает страницу «хорошей» или «плохой» для поиска. Критерий проще: может ли робот стабильно получить нужное содержимое.
Когда рендеринг страницы становится SEO-проблемой
Сам факт использования JavaScript ничего не доказывает. Проблема начинается там, где версия для робота отличается от рабочего содержимого настолько, что поисковая система получает неполную информацию.
Характерные симптомы:
- в браузере есть основной текст, а в отрендеренном HTML робота его нет;
- карточки каталога появляются только после действия пользователя;
- ссылки реализованы обработчиками JavaScript без нормального адреса перехода;
<title>, canonical или другие важные элементы меняются скриптом, но итоговое состояние получается нестабильно;- для загрузки данных требуется cookie, авторизация, содержимое localStorage или иной контекст, которого у робота нет;
- JavaScript или запросы к API завершаются ошибкой;
- необходимые ресурсы недоступны поисковому роботу;
- бесконечная прокрутка показывает следующие элементы пользователю, но не предоставляет поисковой системе обнаруживаемые URL.
Внешне все эти случаи могут выглядеть одинаково: «страница есть, а в поиске её содержимое определяется неправильно». Поэтому проверка начинается не с замены фреймворка, а с поиска конкретного участка, где расходятся версии страницы.
Как происходит рендеринг Googlebot
Google способен выполнять JavaScript и использует для рендеринга современный Chromium. Страница сначала загружается роботом, а затем может пройти отдельный этап выполнения JavaScript.
Это означает, что утверждение «Google вообще не видит JavaScript» неверно. Но из этого не следует обратное — что любое клиентское приложение автоматически будет обработано именно так, как ожидает разработчик.
Поэтому у JavaScript-сайта стоит проверять не теоретическую поддержку технологии, а фактический отрендеренный HTML конкретных URL.
Отдельно важно, что URL с успешным ответом сервера и возможность выполнить JavaScript ещё не гарантируют попадание страницы в поиск. Рендеринг лишь позволяет системе получить материал для дальнейшего анализа.
Рендеринг поисковыми роботами Яндекса
Яндекс также умеет исполнять JavaScript и предоставляет в Вебмастере отдельные средства для работы с такими страницами. В настройках можно оставить решение о выполнении JavaScript на усмотрение робота или изменить режим рендеринга.
Для проекта без SSR это полезный дополнительный механизм, но его не стоит превращать в замену технической проверке сайта. Если приложение падает при загрузке, требует недоступных данных или выдаёт неполное содержимое, одна настройка Вебмастера архитектурную ошибку не исправит.
И для Google, и для Яндекса рабочая цель одна: основное содержимое страницы должно быть доступно без хрупкой последовательности условий.
Как проверить рендеринг страницы на сайте
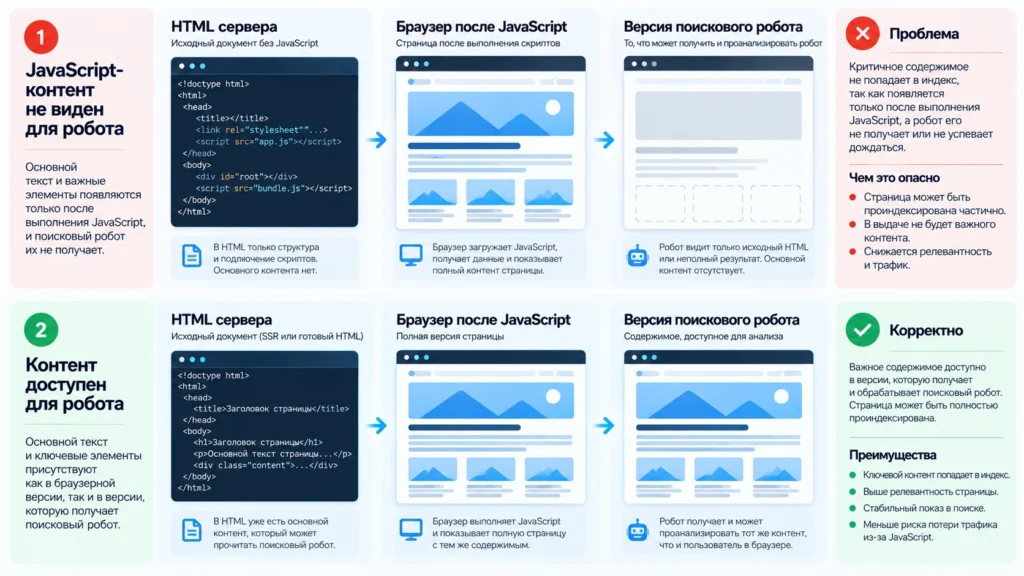
Для диагностики полезно сравнить три состояния одной страницы.
Первое — ответ сервера. Это HTML, полученный до исполнения JavaScript. Его можно посмотреть через исходный код документа или запрос к серверу.
Второе — итоговый DOM в обычном браузере. Он показывает, что получилось после работы скриптов у пользователя.
Третье — версия поискового робота. Именно она помогает понять, смогла ли поисковая система получить тот же критичный контент.
Если текст есть во всех трёх состояниях, зависимость от JavaScript для него минимальна. Если его нет в исходном HTML, но он присутствует у поискового робота, клиентский рендеринг работает, хотя его всё равно стоит учитывать при техническом аудите. Наиболее явная проблема — когда пользователь видит элемент, а робот после рендеринга нет.
Для Google такую проверку можно провести через инструмент проверки URL в Search Console. Live Test позволяет посмотреть отрендеренный HTML, загруженные ресурсы, сообщения JavaScript и снимок результата. При этом данные о уже проиндексированной версии и результаты live-проверки — не одно и то же: первая отражает состояние, известное индексу после предыдущей обработки, вторая проверяет страницу сейчас.
В Яндекс Вебмастере для JavaScript-страниц следует смотреть проверку страницы и доступное поисковому роботу содержимое. Дополнительно полезно сопоставлять результат со статистикой обхода и статусом URL в поисковой базе.
Что исправлять, если робот получает неполный контент
Выбор решения зависит не от названия фреймворка, а от причины расхождения.
Если важные элементы доступны только после клиентского рендеринга и регулярно пропадают у робота, для них имеет смысл рассмотреть SSR, статическую генерацию или пререндеринг. Основной текст, заголовок страницы, навигация и содержимое карточек в таком случае появляются раньше и меньше зависят от выполнения цепочки клиентского кода.
Если CSR работает корректно, переписывать приложение исключительно ради факта использования JavaScript необязательно. Сначала нужно доказать проблему.
Особое внимание стоит уделить ссылкам. Навигационные переходы должны быть представлены обычными HTML-ссылками с адресом, который робот может извлечь. Интерфейс, где переход существует только как JavaScript-событие на произвольном элементе, менее надёжен для обнаружения следующих страниц.
Отдельная категория — контент, который появляется только после прокрутки, открытия вкладки или нажатия кнопки. Для интерфейса это может быть нормальным решением, но критичную поисковую информацию не стоит делать зависимой от действия, которое робот не обязан воспроизводить.
Проверьте также:
- ответы сервера и редиректы;
- загрузку основных JS-файлов;
- ошибки JavaScript при инициализации;
- запросы к API;
- содержимое
<title>и других элементов<head>; - canonical;
- доступность обычных ссылок;
- отсутствие обязательной авторизации;
- поведение страницы при медленной или неудачной загрузке одного из ресурсов.
Google отдельно не рекомендует рассматривать dynamic rendering — выдачу одной версии роботам и другой пользователям — как долгосрочное решение. Для новых реализаций предпочтительнее серверный или статический рендеринг либо архитектура с гидратацией, если она подходит проекту.
Частые технические ошибки JavaScript-сайтов
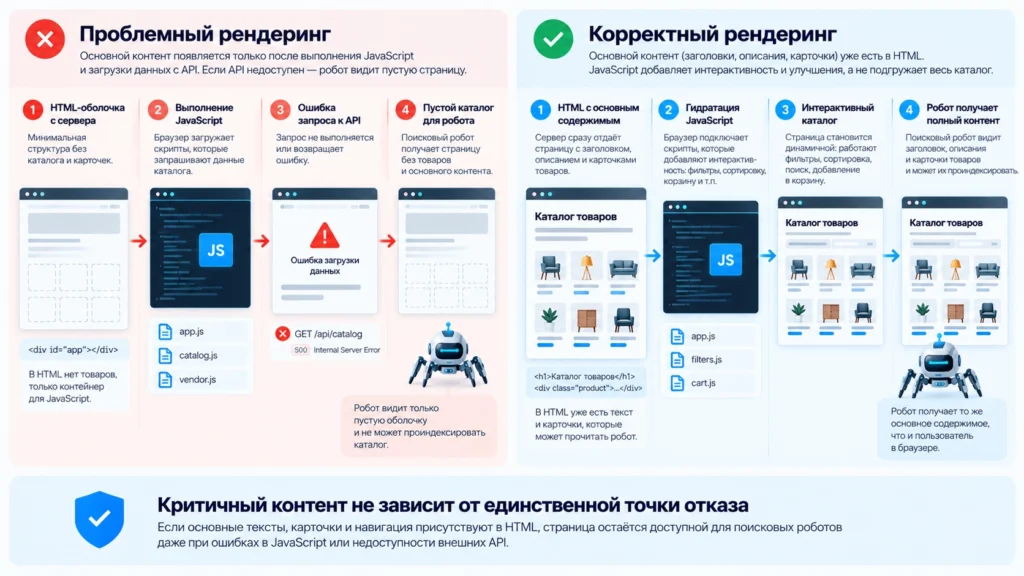
Одна из самых неприятных ошибок — «пустая оболочка». Сервер возвращает успешный ответ, но практически всё полезное содержимое существует только внутри JavaScript-приложения. Пока всё работает, проблема незаметна. При сбое одного API или скрипта робот получает страницу без смысла.
Второй вариант — неправильный HTTP-ответ. Красивый экран «товар не найден» может возвращаться со статусом 200 OK, а реальная страница — ошибкой сервера. В таком случае визуальное состояние и технический ответ говорят поисковику разные вещи.
Третья ошибка — зависимость от пользовательского состояния. Например, приложение получает данные только после чтения значения из localStorage. Обычный посетитель, который уже пользовался сайтом, всё видит. Новый сеанс или робот может получить другой результат.
Четвёртая — клиентская навигация без нормально обнаруживаемых URL. Посетитель переходит между экранами приложения, но поисковый робот не получает полноценной структуры документов.
Пятая — попытка решить проблему только инструментами поисковой системы. Переобход, live-проверка и настройки рендеринга помогают диагностировать состояние, но не чинят JavaScript, сервер или API.
Практический пример: каталог работает у людей, но теряет товары при рендеринге
Представим интернет-каталог на React.
При запросе категории сервер возвращает:
<main id="catalog"></main>
<script src="/catalog.js"></script>
После запуска приложения выполняется запрос к API и появляются H1, описание категории и 30 карточек товаров. В обычном браузере всё выглядит правильно.
При проверке поисковой версии обнаруживается, что H1 присутствует, а товары и описание категории отсутствуют. В консоли при рендеринге видна ошибка запроса к API.
Из этого нельзя сделать вывод «React плохо индексируется». Причина уже конкретнее: поисковый рендер не смог получить данные, от которых зависит основное содержимое.
Команда переводит H1, описание и первый набор товаров в серверный HTML, а JavaScript оставляет для фильтрации, сортировки и последующей интерактивности. После изменения исходный ответ уже содержит полезный документ, а гидратация дополняет его поведением приложения.
Проверка считается пройденной не тогда, когда визуально исчезла ошибка у разработчика, а когда:
- сервер стабильно возвращает корректный статус;
- ключевой контент присутствует в получаемой роботом версии;
- карточки содержат доступные адреса страниц;
<head>содержит ожидаемые метаданные;- отрендеренный HTML не зависит от авторизации или сохранённого состояния браузера;
- повторная проверка даёт тот же результат.
Что считать нормальным результатом для SEO
Цель технической работы с рендерингом — не добиться определённого названия технологии в архитектуре сайта. SSR не является самостоятельной гарантией позиций, так же как CSR не означает автоматическую проблему с индексированием.
Нормальный результат можно определить практическими критериями.
Поисковый робот получает страницу с корректным HTTP-ответом, видит основной текст и структуру документа, может обнаружить необходимые URL, получает ожидаемые метаданные, а итог не меняется случайным образом из-за состояния браузера или необязательного пользовательского действия.
После этого задача рендеринга в значительной степени решена. Дальнейшее попадание страницы в индекс и её позиции зависят уже не только от JavaScript, но и от качества самой страницы, каноникализации, доступности сайта, релевантности и других сигналов поисковой системы.
Поэтому наиболее полезный вопрос при аудите звучит не «использует ли сайт JavaScript?», а «какую страницу в действительности получает поисковый робот и достаточно ли в ней информации для нормальной обработки?».
FAQ
Когда проблема рендеринга действительно мешает индексации
Это превращение исходного HTML, CSS и JavaScript в итоговое состояние страницы. На JavaScript-сайте часть содержимого может отсутствовать в первоначальном HTML и появляться только после выполнения скриптов, поэтому для SEO важно проверить именно конечный результат.
Сам по себе способ рендеринга не является гарантией более высоких позиций. Проблема возникает, когда из-за реализации поисковый робот не получает важный контент, ссылки или метаданные и поэтому не может нормально обработать страницу. После исправления доступности контента результат ранжирования всё равно зависит от множества других факторов.
Сравните исходный HTML, DOM после выполнения JavaScript и версию, которую получает поисковый робот. Для Google удобно использовать проверку URL и отрендеренный HTML в Search Console, для Яндекса — инструменты проверки страницы и JavaScript-рендеринга в Вебмастере.
Нет. Главный критерий — доступность необходимого содержимого поисковому роботу. SSR или пререндеринг часто делают результат более предсказуемым, но корректно реализованный клиентский рендеринг тоже может индексироваться.
Сначала определите, на каком этапе пропадает содержимое: в HTTP-ответе, при загрузке JavaScript, при обращении к API или после выполнения кода. Затем устраните зависимость критичного контента от недоступных ресурсов, пользовательских действий или ошибок JavaScript и повторите проверку отрендеренной версии.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.