6 октября 2026 года Google DeepMind выпустила EmbeddingGemma 2 — компактную мультимодальную embedding-модель, рассчитанную в том числе на работу непосредственно на пользовательском устройстве. Её наиболее интересная особенность не просто в поддержке нескольких типов данных, а в том, что текст, код, изображения, видео и аудио можно представить в одном 768-мерном векторном пространстве.
На практике это меняет архитектуру локального поиска. Чтобы найти фотографию по фразе «кот спит на клавиатуре», необязательно сначала описывать каждое изображение текстом. Чтобы найти эпизод в видео, необязательно строить весь поиск только поверх транскрипции. Запрос и медиаконтент можно преобразовать в совместимые embeddings и сравнивать непосредственно по семантической близости.
При этом EmbeddingGemma 2 — не генеративная LLM и не локальная замена ChatGPT. Модель предназначена прежде всего для получения векторных представлений, retrieval, semantic similarity, классификации и clustering. Если системе нужен сформулированный ответ, найденные через неё данные можно передать отдельной генеративной модели.
Один индекс вместо отдельных поисков по тексту, фото и звуку
Классический мультимедийный поиск часто превращается в набор параллельных конвейеров. Текст индексируется одной моделью, фотографии сначала получают captions, звук проходит speech-to-text, видео разбивается на кадры и транскрипцию. После этого разработчику ещё нужно согласовать результаты разных поисковых систем.
EmbeddingGemma 2 предлагает другую основу: специализированные modality encoders приводят разные входы к совместимому embedding space.
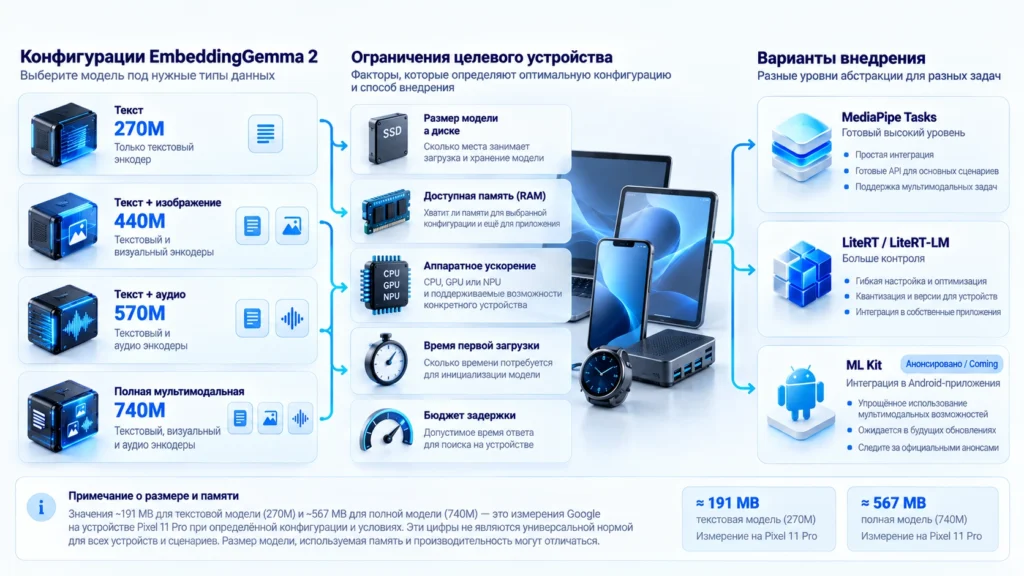
Полная модель содержит 740 млн параметров. Из них 270M приходятся на text-модель, к ней могут подключаться vision encoder на 170M и audio encoder на 300M. Поэтому конфигурацию можно выбирать по данным проекта: 270M для текста и кода, 440M для text+vision, 570M для text+audio либо 740M для полного мультимодального сценария.
Это важнее самой цифры «740M». Мобильной фотогалерее без голосовых записей не обязательно держать audio encoder. Локальной базе документации не нужен vision encoder, пока в поиск не включаются схемы, скриншоты или PDF с визуальным содержимым.
Сам embedding имеет 768 измерений. Благодаря Matryoshka Representation Learning его можно сократить до 512, 256 или 128 измерений и после этого нормализовать. В model card Google указывает компрессию vector storage 1:3 для 256d и 1:6 для 128d. При этом качество на 128d снижается сильнее именно в мультимодальных задачах, поэтому минимальный размер вектора нельзя выбирать только ради красивой цифры экономии.
Что реально происходит при поиске по локальной медиатеке
Представим медиатеку на ноутбуке или смартфоне: десятки тысяч фотографий, домашние видео, голосовые заметки и текстовые файлы. Пользователь пишет: «найди момент, где ребёнок задувает свечи», не указывая тип файла.
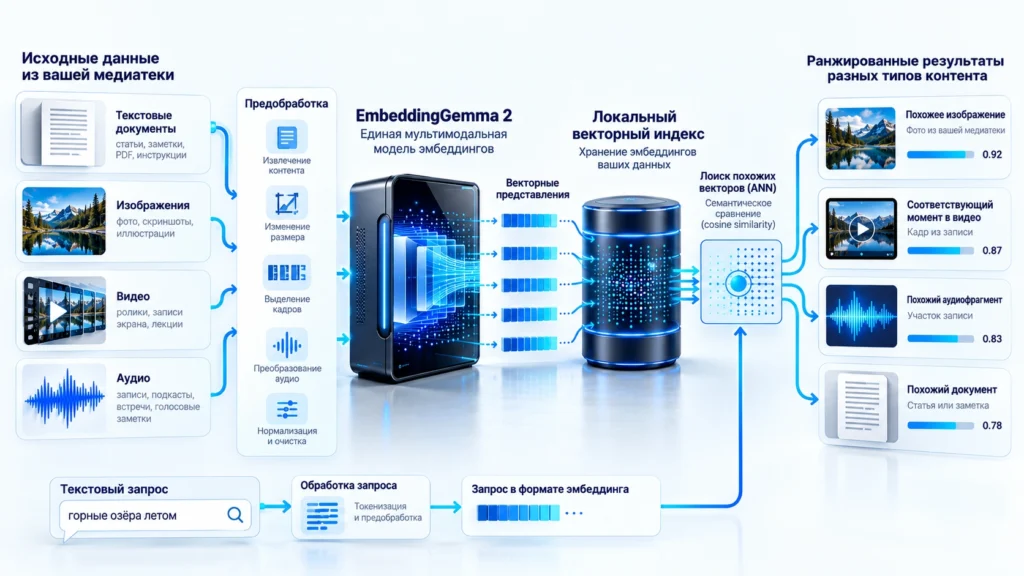
Во время индексирования приложение сначала подготавливает контент. Текст можно разбивать на смысловые фрагменты. Изображения передаются vision-компоненту. Видео может индексироваться по выбранным кадрам или сегментам; model card указывает базовую обработку видео с выборкой 1 кадр в секунду, причём sampling можно менять. Аудио модель принимает непосредственно, без обязательной предварительной транскрипции.
Каждый фрагмент получает embedding и запись в локальном индексе вместе с техническими метаданными: идентификатором файла, типом контента, временной позицией для видео или аудио и другими данными, необходимыми приложению.
Когда появляется запрос, для него строится query embedding. Дальше нужен уже не «искусственный интеллект, который всё понимает», а вполне конкретная retrieval-задача: найти ближайшие векторы и отсортировать кандидатов по similarity.
В демонстрации Google AI Edge локальные embeddings сохраняются в SQLite, а результаты сравниваются по cosine similarity. MediaPipe Semantic Retriever предоставляет более законченный слой: генерацию embeddings, on-device vector storage и retrieval. В документации описан локальный поиск по тексту, изображениям и аудиофайлам, в том числе через SQLite-backed vector store.
Главное преимущество единого пространства проявляется на границе modalities. Текстовый запрос может найти изображение. Изображение может стать запросом для поиска похожего контента. Смысл голосовой заметки можно сопоставлять с другими данными, если архитектура приложения и выбранный runtime поддерживают нужный вход.
Но «единое пространство» не означает, что нужно свалить всю медиатеку в один недифференцированный индекс. В реальном продукте всё равно понадобятся metadata filters, типы объектов, timestamps, ограничения доступа, deduplication и иногда второй этап reranking.
MediaPipe и LiteRT решают разные уровни одной задачи
Для типового приложения разумно сначала смотреть на MediaPipe Tasks. Universal Embedder принимает текст, изображения и аудио и возвращает совместимые embeddings. Semantic Retriever добавляет слой индекса и поиска. То есть разработчику не нужно вручную собирать весь preprocessing и хранилище вокруг низкоуровневого inference.
Если требуется более точный контроль над execution backend, моделью и аппаратным ускорением, Google предлагает LiteRT/LiteRT-LM. В актуальной документации LiteRT-LM EmbeddingGemma 2 уже фигурирует как поддерживаемая embedding model для text, images, video и audio, а версия 0.18.0 содержит multimodal embeddings и Matryoshka truncation для Python, Kotlin, Swift, Web/JavaScript и C++.
LiteRT также позволяет выбирать CPU, GPU и на поддерживаемом железе NPU. Это полезно именно потому, что одна фраза «работает локально» практически ничего не говорит о реальной скорости приложения.
Google публикует отдельные измерения для Pixel 11 Pro, Samsung S26 Ultra, iPhone 18 Pro, MacBook Pro M5, Windows-систем и других устройств. Результаты заметно различаются в зависимости от hardware и backend. Поэтому показатель конкретного смартфона нельзя превращать в обещание вроде «поиск всегда занимает 50 мс».
С ML Kit ситуация на момент публикации другая. В анонсе от 6 октября Google сообщает, что сервисная интеграция EmbeddingGemma 2 для Android через ML Kit должна появиться в ближайшие недели, с управлением моделью и NPU acceleration там, где оно доступно. На 7 октября корректно говорить о запланированной интеграции, а не о готовом production API.
Локальный поиск на сайте — совсем не то же самое, что поиск внутри приложения
Особенно осторожно к EmbeddingGemma 2 стоит подходить в веб-разработке. Техническая возможность запустить модель в браузере ещё не означает, что полный on-device вариант нужно загружать каждому посетителю сайта.
В документации LiteRT-LM полный omnimodal bundle EmbeddingGemma 2 указан примерно как 485 MB, text+vision — 388 MB, text-only — 165 MB. Это размер готовых LiteRT-моделей в конкретной поставке, а не active RAM, но уже он показывает масштаб первой загрузки.
Для установленного мобильного приложения сотни мегабайт могут быть осознанной платой за приватный офлайн-поиск. Для обычной страницы WordPress ситуация иная: модель конкурирует за трафик, cache storage, память, CPU/GPU пользователя и время до готовности функции.
Поэтому для сайта я бы разделял как минимум четыре сценария.
Первый — локальная корпоративная или персональная веб-система. Пользователь регулярно работает с приложением, модель кэшируется, данные чувствительные, а offline mode действительно полезен. Здесь browser-side embeddings имеют практический смысл.
Второй — PWA или специализированный медиакаталог. Если поиск является центральной функцией продукта и посетитель возвращается постоянно, стоимость первоначальной загрузки можно оправдать и измерить.
Третий — обычный публичный WordPress-сайт. Загружать сотни мегабайт модели человеку, который пришёл прочитать одну статью или найти услугу, в большинстве случаев сложно обосновать. Серверный embedding pipeline или cloud vector database может оказаться и быстрее для пользователя, и проще в эксплуатации.
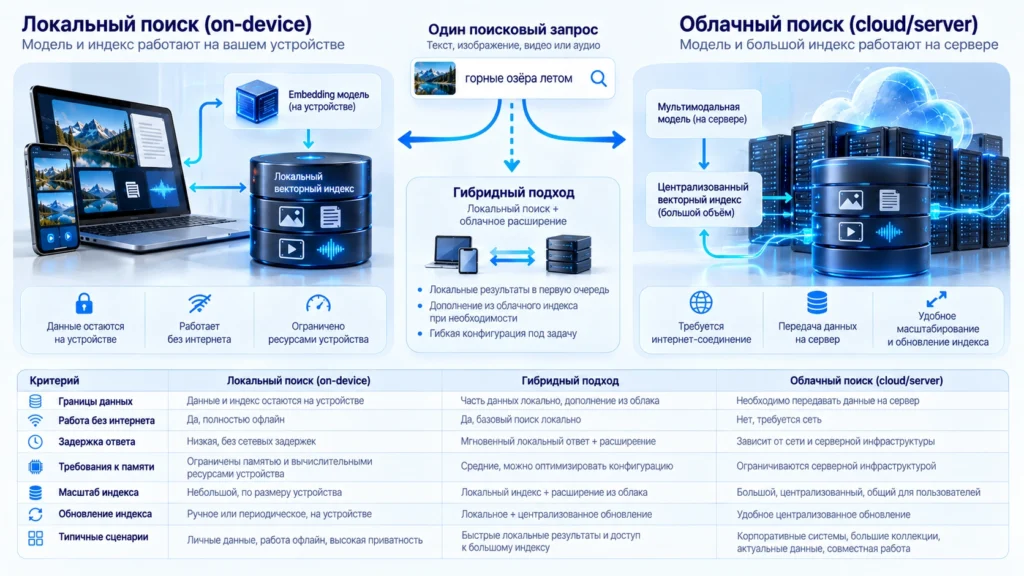
Четвёртый — гибрид. На сервере хранится основной большой индекс, а локально работают приватные пользовательские данные, небольшой персональный cache или отдельный first-stage retrieval.
Перед внедрением web-версии нужны измерения как минимум на слабом Android, среднем ноутбуке и целевых браузерах: размер фактически скачанных ресурсов, время cold load, время инициализации модели, peak memory, скорость индексирования, query latency и влияние процесса на интерфейс. Один benchmark мощного ноутбука здесь почти бесполезен.
256 измерений могут быть практичнее 768, но это нужно доказать на своих данных
MRL делает размер вектора отдельным параметром архитектуры. Нативный результат EmbeddingGemma 2 — 768d, но model card поддерживает 512d, 256d и 128d.
На 256d размер хранимого вектора сокращается втрое. Google показывает сравнительно небольшое снижение своих benchmark-метрик на этом уровне и в developer guide называет его разумным storage-constrained вариантом. На 128d чистое vector storage уменьшается в шесть раз, но падение мультимодальных benchmark-результатов становится заметнее.
Отсюда практическое правило: размер embedding следует выбирать не по максимальной экономии, а по retrieval-тесту.
Соберите контрольный набор реальных запросов и заранее определите, что считается правильным результатом. Например, для медиатеки это могут быть 100–300 запросов разных типов: конкретный объект на фото, событие, визуальная сцена, фраза в аудио, момент в видео, тематически связанный документ.
Затем сравните 768d, 512d и 256d на одинаковом корпусе. Смотрите не только на среднюю similarity, а на Recall@K, долю случаев, когда правильный объект оказался в первых результатах, latency и размер индекса.
128d имеет смысл проверять отдельно. Model card прямо отмечает, что этот режим лучше подходит для text-only workloads и что мультимодальное качество при таком сокращении следует валидировать на своей задаче.
Ещё один технический нюанс: после ручного truncation вектор нужно повторно L2-нормализовать. И запрос, и индексируемые документы обязаны иметь одинаковую размерность. Иначе либо сравнение вообще невозможно, либо ranking тихо деградирует.
Где on-device выигрывает, а где облако остаётся рациональнее
Локальный retrieval особенно привлекателен там, где содержимое не должно покидать устройство. Личные фотографии, записи встреч, локальная документация, заметки и приватные файлы можно индексировать без отправки исходного контента на внешний embedding API.
Второй плюс — отсутствие обязательного сетевого round-trip для каждого запроса. После загрузки модели и построения индекса система может работать офлайн, а стоимость дополнительных запросов не превращается в API billing.
Но слово «локальный» не отменяет затрат. Модель занимает storage и память, первоначальная индексация расходует вычислительные ресурсы и батарею, большой ANN-index тоже нужно хранить, обновлять и иногда перестраивать. Разработчику приходится учитывать аппаратную фрагментацию устройств.
Облако выигрывает в другом масштабе. Когда один индекс должен обслуживать множество пользователей, корпус состоит из миллионов постоянно меняющихся объектов, нужен централизованный access control или требуется тяжёлый reranking, серверная vector infrastructure может быть значительно практичнее.
Кроме того, локальное выполнение само по себе не гарантирует приватность продукта. Если приложение после retrieval отправляет найденные документы или embeddings на сервер, нужно отдельно анализировать весь data flow.
Практическая архитектура, которую я бы проверял первой
Для локальной медиатеки я бы не начинал с генеративного RAG и не добавлял сложность раньше времени.
Первый слой — ingestion. Приложение замечает новый или изменённый файл и определяет его modality. Фотография может индексироваться целиком, видео — по сегментам или выборке кадров, аудио — по временным отрезкам, длинный текст — по смысловым chunks.
Второй слой — EmbeddingGemma 2. Загружаются только нужные encoders. Все индексируемые элементы получают нормализованные embeddings одной выбранной размерности.
Третий — local vector store. Помимо самого вектора запись должна содержать ссылку на исходный объект и достаточные metadata для фильтрации и восстановления результата. Для видео особенно важен timestamp, иначе retrieval найдёт правильный embedding, но интерфейс не сможет открыть нужный момент.
Четвёртый — query pipeline. Текст пользователя получает embedding с корректной task instruction для search query. У EmbeddingGemma 2 task prefixes являются частью рекомендуемой схемы работы: запрос и индексируемый текст обрабатываются не одинаково.
Пятый — ANN retrieval и ranking. Сначала выбирается ограниченное число ближайших кандидатов. Затем можно применить metadata filters или дополнительный reranking, если базовой cosine similarity недостаточно.
Шестой — интерфейс результата. Пользователь должен увидеть исходный тип контента, релевантный фрагмент и понятный переход к оригиналу. Не нужно заставлять генеративную модель пересказывать фотографию или видео, если задача пользователя — просто найти файл.
И только если продукту действительно нужен ответ на основе найденных объектов, retrieval можно дополнить отдельной генеративной моделью и построить RAG. EmbeddingGemma 2 в такой архитектуре отвечает за поиск контекста, а не за формулирование финального ответа.
Что проверять до production
Первый показатель — качество retrieval на собственном корпусе. Benchmark модели помогает сравнивать технологии, но не сообщает, найдётся ли нужный кадр именно в ваших камерах наблюдения, товарных фотографиях или архиве документов.
Второй — cold start. Локальный запрос после уже загруженной модели может быть быстрым, но пользователю важен путь от запуска приложения до первого рабочего поиска.
Третий — индексация. Для большой медиатеки вычисление embeddings может оказаться гораздо дороже одного поискового запроса. Нужны очередь, incremental updates и стратегия удаления устаревших записей.
Четвёртый — реальный memory peak, а не только размер файла модели. Google приводит около 191 MB active RAM для text-only weights и около 567 MB для full multimodal model на Pixel 11 Pro. Это полезная контрольная точка, но не системное требование для всех Android-устройств.
Пятый — размер индекса при выбранной dimension. 256d часто выглядит более практичным компромиссом, чем максимальные 768d, но решение должно подтверждаться retrieval-тестами. Чистая размерность 768→128 означает шестикратное уменьшение vector storage. Отдельное заявление Google AI Edge о сокращении local storage/index footprint до 8× относится к реализации вокруг MRL и не должно подменять арифметику самих embedding vectors.
Шестой — граница локальных данных. Нужно точно знать, какие файлы, embeddings, поисковые запросы и результаты остаются на устройстве, а что уходит во внешние сервисы.
EmbeddingGemma 2 интересна не потому, что появилась ещё одна модель семейства Gemma. Она делает вполне конкретную архитектуру мультимодального поиска реалистичнее: один компактный embedding stack может сопоставлять текст, изображения, видео и аудио без обязательного каскада отдельных captioning, transcription и text-embedding моделей.
Но ценность проявляется только после инженерных измерений. Для локальной медиатеки или приватной базы знаний on-device retrieval может убрать сетевой round-trip и сохранить исходные данные на устройстве. Для публичного WordPress-сайта с огромным общим индексом облачная или гибридная схема часто останется рациональнее. А выбор между 768d, 256d и 128d должен определяться не обещанной экономией памяти, а тем, насколько хорошо реальные пользователи находят реальные данные.
FAQ
Частые вопросы об EmbeddingGemma 2
Это мультимодальная embedding-модель Google DeepMind на 740 млн параметров. Она не генерирует готовые ответы как чат-LLM, а превращает текст, код, изображения, видео и аудио в векторы, которые можно сравнивать по семантической близости.
Да. Разные типы входных данных проецируются в одно 768-мерное пространство. В частности, Google демонстрирует поиск фотографий естественным языком и поиск нужных моментов в локальных видео.
Нет. Архитектура модульная: можно оставить только 270M text/code, добавить vision и получить 440M, использовать text+audio на 570M либо загрузить полный 740M-вариант.
Нативный результат имеет 768 измерений, а MRL позволяет использовать 512d, 256d или 128d. Чистый vector storage при переходе 768→128 уменьшается в 6 раз. Google AI Edge отдельно сообщает до 8× уменьшения local storage/index footprint в своей реализации, поэтому эти две цифры описывают не совсем одну и ту же метрику.
По состоянию на 7 октября 2026 года Google пишет, что соответствующая ML Kit-интеграция появится в ближайшие недели. Для разработки уже доступны MediaPipe Tasks и LiteRT/LiteRT-LM.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.