OpenAI начала внедрять для текста отдельную систему происхождения контента — textGrain. Это невидимый статистический водяной знак, который формируется непосредственно во время генерации: модель немного изменяет способ выбора между допустимыми словами и частями слов, а специализированный детектор позднее ищет накопившийся статистический паттерн.
Это не скрытые Unicode-символы, не невидимые пробелы и не метаданные, прикреплённые к текстовому файлу. Сигнал находится в самой последовательности выбранных моделью слов. OpenAI прямо описывает textGrain как изменение случайности при выборе слов и уточняет, что пользователь визуально этот watermark не видит.
5 октября 2026 года OpenAI объявила отдельный порядок внедрения технологии. API-клиенты по всему миру получили возможность добровольно включать text watermarking для поддерживаемых моделей, при этом по умолчанию он для API отключён. Для ChatGPT и Codex компания объявила внедрение невидимого watermark для подходящих текстовых ответов в Евросоюзе. Доступ к официальному текстовому детектору на старте ограничен одобренными исследователями и экспертными организациями.
Для редакций, владельцев сайтов и SEO-специалистов здесь особенно важно не сделать слишком широкий вывод. Наличие textGrain не доказывает, что весь материал «написан нейросетью». Отсутствие обнаруживаемого watermark тоже не доказывает человеческое происхождение. И сам по себе этот сигнал ничего не говорит о качестве, достоверности, авторском вкладе или SEO-ценности текста.
Что OpenAI меняет в ChatGPT, Codex и API
В случае текста задача происхождения сложнее, чем с изображениями. У картинки может быть самостоятельный файл с Content Credentials, у аудио — встроенный невидимый сигнал. Текст постоянно копируют из одного приложения в другое: из ChatGPT в документ, из документа в WordPress, из CMS в мессенджер.
Обычная файловая метаинформация в такой цепочке легко исчезает.
Поэтому в textGrain носителем сигнала становится сама формулировка текста.
В актуальном Help Center OpenAI указывает для текста textGrain watermarks (EU only) и объясняет, что для ChatGPT в ЕС технология применяется в связи с требованиями EU AI Act. Там же отдельно указано, что охват может зависеть от продукта, модели, способа получения результата и времени создания контента.
Для OpenAI API схема отличается. Клиент может включить text watermarking для конкретного проекта или всей организации и выбрать поддерживаемые модели. Включение watermark не предоставляет автоматический доступ к официальному текстовому детектору: его доступность регулируется отдельно.
Это означает, что нельзя исходить из правила «любой текст любой OpenAI-модели во всём мире теперь содержит textGrain».
Для ChatGPT и Codex OpenAI связывает первоначальное массовое применение с ЕС. Для API за пределами этого сценария watermark остаётся управляемой настройкой клиента.
Как работает textGrain
При генерации текста языковая модель на каждом шаге имеет несколько допустимых вариантов продолжения. У возможных следующих токенов есть собственное распределение вероятностей.
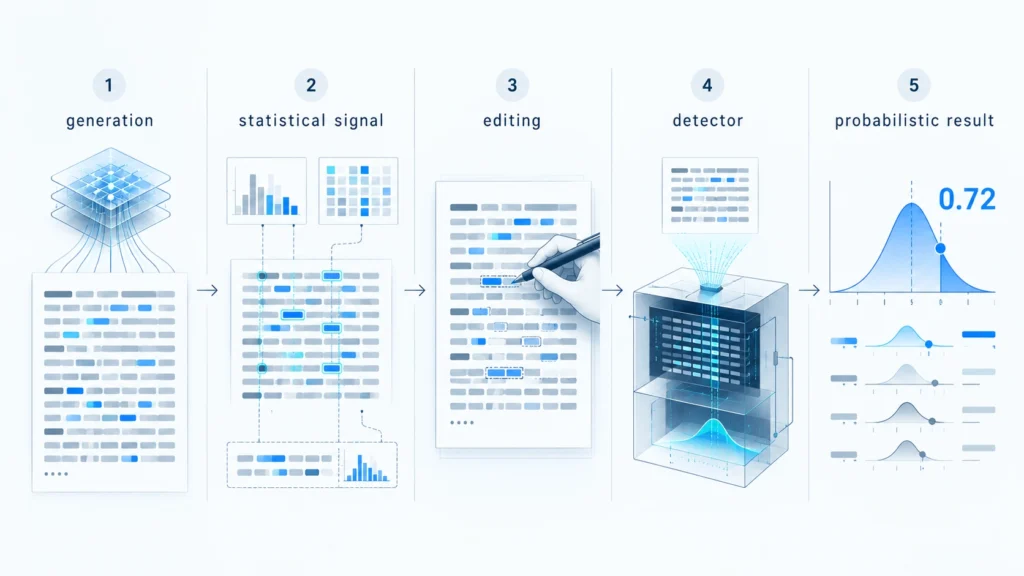
В упрощённом виде textGrain изменяет способ случайного выбора между такими вариантами, чтобы на протяжении достаточно длинного фрагмента возник статистический паттерн.
Внешне предложение остаётся обычным.
Например, модель могла бы сформулировать одну мысль несколькими естественными способами. С точки зрения смысла варианты почти равнозначны, но последовательность конкретных выборов может содержать дополнительный статистический сигнал.
OpenAI подчёркивает, что watermark не добавляет к тексту скрытые символы, невидимые пробелы или необычную пунктуацию. Он является частью выбора формулировок.
В техническом описании textGrain используется более сложная схема с секретным ключом, распределением вероятностей и контролем силы сигнала. Поэтому механизм нельзя свести к примитивному правилу вроде «модель выбирает слова из специального словаря».
Смысл технологии в другом: распределение выбора токенов немного изменяется так, чтобы специализированная система, знающая способ построения сигнала, могла статистически проверить достаточно длинный текст.
Отдельное слово при этом ничего не доказывает.
Детектору нужен накопленный сигнал по последовательности.
Почему textGrain — не обычный детектор AI-текста
Здесь важно разделять две принципиально разные технологии.
Обычный AI detector получает уже существующий текст и пытается по его характеристикам определить, похож ли он на машинную генерацию. Он не участвовал в создании текста и не располагает специально встроенным сигналом.
textGrain работает иначе.
OpenAI намеренно изменяет статистику выбора слов непосредственно в момент генерации. Затем специальный детектор ищет именно этот заранее предусмотренный паттерн.
Поэтому сервис, который умеет оценивать «вероятность AI-текста», автоматически не становится детектором textGrain.
На момент запуска OpenAI не делает официальный текстовый detector общедоступным. Компания принимает заявки от исследовательских и экспертных организаций и выдаёт доступ в индивидуальном порядке. Причина — ограничения технологии, включая как ложноположительные, так и ложноотрицательные результаты.
При этом публичные инструменты OpenAI для проверки изображений и аудио существуют отдельно. Для этих типов контента используются Content Credentials, SynthID и Content Provenance API. Текстовый watermark — отдельная система.
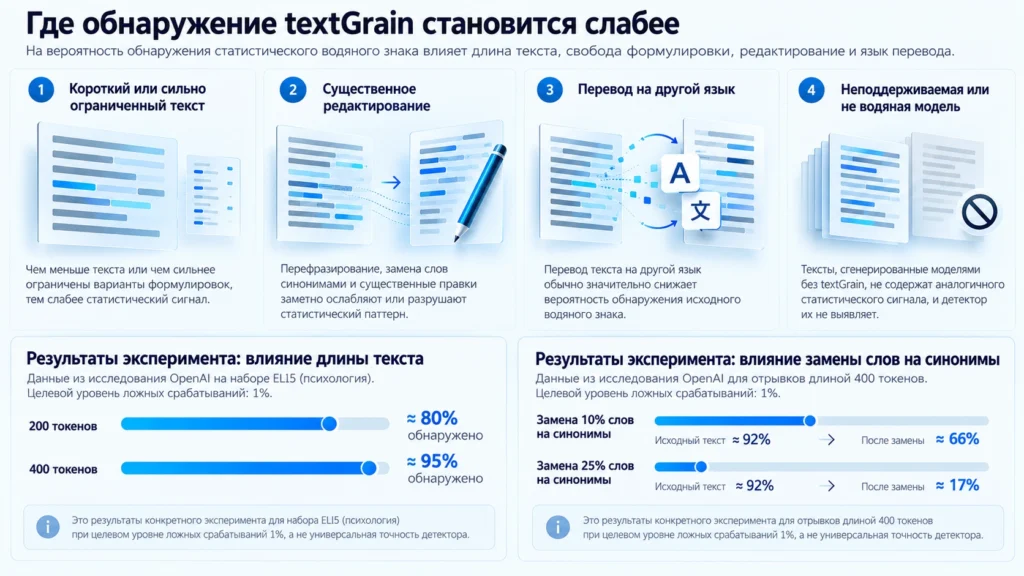
Почему короткий текст обнаруживать сложнее
У статистического сигнала есть естественное ограничение: ему требуется достаточное количество выборов.
Чем длиннее текст и чем больше у модели свободы в формулировках, тем больше статистического материала получает detector.
OpenAI приводит эксперимент, в котором при целевой частоте false positive в 1% detector находил watermark примерно в 80% фрагментов длиной 200 токенов и примерно в 95% фрагментов длиной 400 токенов для контента вроде ответов по психологии.
Для математического контента результаты были существенно хуже, поскольку в подобных ответах меньше свободы выбора формулировок.
Эти цифры нельзя превращать в утверждение «точность textGrain составляет 95%».
Речь идёт о конкретном эксперименте:
- определённый набор материалов;
- конкретная длина текста;
- конкретный тип вопросов;
- заданная целевая частота false positive;
- определённая версия технологии.
В других условиях результат может заметно отличаться.
Именно поэтому короткий ответ ChatGPT, код, математическая формула или сильно ограниченный по форме текст нельзя оценивать так же, как длинный свободно сформулированный материал.
Что происходит с watermark после редактирования
Поскольку textGrain находится в последовательности выбранных слов, изменение формулировок способно разрушать статистический паттерн.
OpenAI проверяла это экспериментально.
Для 400-токенных фрагментов замена 10% слов синонимами снизила обнаружение watermark примерно с 92% до 66%. При замене 25% слов показатель упал примерно до 17%.
Это хорошо показывает принцип работы технологии.
Небольшие изменения не обязательно уничтожают сигнал мгновенно. Но серьёзное перефразирование постепенно меняет тот материал, на котором основано обнаружение.
Перевод — ещё более сложный случай.
При переводе предложения фактически строятся заново на другом языке. OpenAI прямо предупреждает, что substantial rewriting, paraphrasing и translation способны сделать text watermark необнаруживаемым.
Отсюда нельзя делать обратный вывод.
Если detector не нашёл watermark, это не означает, что текст написал человек.
Причин отрицательного результата может быть много: текст слишком короткий, сильно отредактирован, переведён, создан до внедрения watermark, получен через неподдерживаемую модель или вообще сгенерирован другой системой. OpenAI отдельно подчёркивает это ограничение.
Что detector может показать — и чего он не доказывает
Даже положительный результат имеет ограниченный смысл.
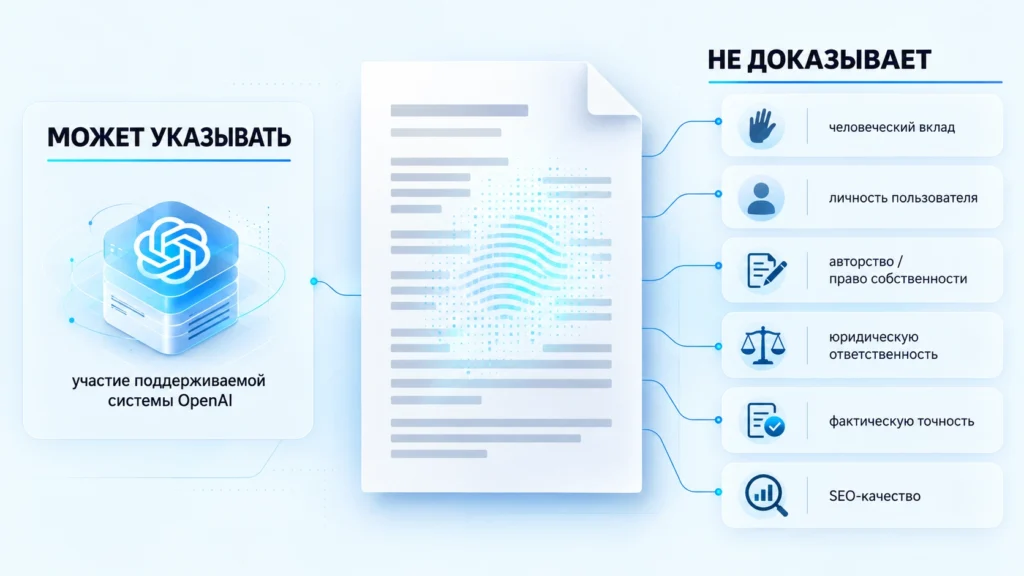
Он может указывать, что OpenAI-система генерировала или обрабатывала часть проверяемого текста и что соответствующий статистический сигнал сохранился в достаточной степени для обнаружения.
Но watermark не измеряет человеческий вклад.
Он не показывает, получил ли пользователь готовую статью и опубликовал её без изменений или использовал ChatGPT только как черновой инструмент, а затем полностью переписал материал после самостоятельного исследования.
Watermark не определяет автора текста.
Он не устанавливает, какой пользователь, аккаунт или организация создали материал. Detector не раскрывает исходный промпт или переписку пользователя.
Watermark не устанавливает право собственности.
Наличие сигнала не отвечает на вопрос, кому принадлежат права, было ли использование материала законным и кто несёт ответственность за публикацию.
Watermark не подтверждает фактическую точность.
Текст с обнаруженным textGrain может содержать правильную информацию, ошибки, устаревшие сведения или неподтверждённые утверждения.
OpenAI прямо перечисляет эти ограничения и отдельно подчёркивает, что отсутствие watermark не является доказательством человеческого авторства.
Поэтому результат нельзя использовать как универсальный вердикт:
«этот материал написал AI»;
«этот материал написал человек»;
«автор обманывает»;
«текст качественный»;
«текст некачественный».
Это гораздо более узкий сигнал происхождения.
Что меняется из-за EU AI Act
Появление textGrain связано прежде всего с требованиями европейского регулирования, поэтому здесь важно разделять обязанности провайдера AI-системы и обязанности того, кто использует AI-контент.
Article 50 AI Act применяется с 2 августа 2026 года. Еврокомиссия указывает, что с этой даты providers и deployers должны соблюдать предусмотренные статьёй требования прозрачности. Для части систем, размещённых на рынке до этой даты, предусмотрен ограниченный переходный период именно для требований Article 50(2).
Для provider задача состоит в том числе в создании машинно-читаемых способов определить синтетический или изменённый AI-контент.
Именно на этом уровне OpenAI внедряет textGrain.
Но отдельные обязанности могут возникать и у deployer — организации или человека, профессионально использующего AI-систему.
Особенно важен Article 50(4), относящийся к AI-generated или manipulated текстам, которые публикуются для информирования общественности по вопросам общественного интереса.
По разъяснению Еврокомиссии, соответствующее требование распространяется на текст, который одновременно опубликован, информирует общественность и касается вопросов общественного интереса.
При этом существует существенное исключение.
Опубликованный текст, прошедший содержательную человеческую проверку или редакционный контроль, не требует такой маркировки при соблюдении условий редакционной ответственности.
Еврокомиссия объясняет human review как осознанную содержательную проверку человеком, который обладает релевантными знаниями и профессиональным суждением.
Editorial control предполагает реальную возможность редактора одобрить, изменить или отклонить материал по содержательным основаниям, включая фактчекинг и проверку надёжности источников.
Обычная проверка орфографии или грамматики для этого недостаточна.
Это важное различие для редакций.
Сам факт наличия textGrain и необходимость ставить читателю видимую отметку об AI-контенте — не одно и то же требование.
Машиночитаемый watermark решает задачу provenance на уровне системы. Юридические обязанности конкретного издателя зависят от сценария использования, характера публикации, редакционного процесса и применимых требований.
Практический сценарий: редакция получает AI-черновик
Представим обычную рабочую ситуацию.
Редактор просит ChatGPT подготовить первоначальный черновик статьи.
В полученном тексте присутствует textGrain.
Далее специалист открывает первичные источники, проверяет даты, цифры и цитируемые утверждения. Неподтверждённые части удаляются. Структура перестраивается. Формулировки меняются. Добавляются собственные выводы и практический опыт. Затем другой редактор проводит финальный фактчекинг и принимает решение о публикации.
После такого процесса статистический сигнал может сохраниться, стать слабее или перестать обнаруживаться.
Ни один из этих исходов не позволяет оценить качество материала.
Если watermark сохранился, это не означает, что перед нами необработанный AI-текст.
Если он исчез, это не означает, что AI в процессе не использовался.
Для редакции важнее иметь собственную цепочку ответственности:
кто сформировал задачу;
кто проверил первичные источники;
кто подтвердил факты;
кто внёс содержательные изменения;
кто принял решение о публикации.
textGrain может стать ещё одним техническим сигналом происхождения, но он не заменяет редакционную историю и экспертную проверку.
Чем textGrain отличается от метаданных изображений и аудио
У OpenAI нет единственного универсального provenance-механизма для всех форматов.
Для изображений используются Content Credentials и SynthID. Для аудио — SynthID. Для текста в ЕС применяется textGrain.
Content Credentials основаны на C2PA и могут содержать информацию об истории и происхождении файла.
Их преимущество — возможность хранить больше контекста.
Недостаток — зависимость от самого файла и цепочки его обработки. Метаданные способны исчезнуть при конвертации, копировании или работе через платформы, которые их не сохраняют.
Watermark встроен в содержимое.
Для изображения или аудио такой сигнал может пережить некоторые преобразования даже после удаления метаданных.
У текста нет устойчивого медиаконтейнера: достаточно скопировать несколько абзацев из ChatGPT и вставить их в CMS.
Поэтому textGrain привязан к статистической структуре самих формулировок.
Но именно из-за этого значительное редактирование и перевод способны ослабить его сильнее.
Что textGrain не меняет в SEO
Появление водяных знаков ChatGPT не создаёт нового правила поискового продвижения.
Нет оснований считать, что обнаруженный textGrain автоматически ухудшает ранжирование страницы, а отсутствие сигнала даёт SEO-преимущество.
Watermark вообще не предназначен для оценки качества страницы.
Он не измеряет полезность материала, экспертность автора, полноту раскрытия интента, корректность фактов или оригинальность практического опыта.
Поэтому пытаться механически «очищать» готовую статью от textGrain ради Google бессмысленно.
Более того, массовое перефразирование только ради изменения статистического паттерна способно ухудшить читаемость, точность терминологии и логические связи.
Для поискового продвижения значительно важнее то, как именно AI используется в редакционном процессе.
Если модель создаёт дешёвые однотипные страницы без дополнительной ценности, проблема находится в качестве и масштабе производства контента.
Если AI помогает собрать черновик, который затем проверяет эксперт, сопоставляет с первичными источниками и существенно дорабатывает, сам факт использования модели не описывает качество результата.
Подробнее этот принцип разобран в материале о требованиях Google к AI-контенту.
Поэтому textGrain стоит воспринимать как технологию provenance, а не как новый SEO-сигнал.
Что стоит изменить в редакционном процессе
Для большинства сайтов появление textGrain не требует полностью перестраивать производство контента.
Но несколько вещей стоит разделить явно.
Первая — происхождение черновика.
Если материал создавался или существенно обрабатывался AI, редакции полезно понимать это внутри собственного процесса независимо от того, сохранился ли технический watermark.
Вторая — проверка качества.
Факты, источники, цифры, выводы и рекомендации должен проверять человек, способный содержательно оценить тему.
Третья — редакционная ответственность.
Должно быть понятно, кто имеет право изменить или отклонить материал перед публикацией и кто отвечает за итоговую версию.
Четвёртая — юридическая прозрачность.
Наличие встроенного машинно-читаемого сигнала само по себе не заменяет другие формы disclosure, если они требуются в конкретном сценарии. OpenAI также отдельно предупреждает, что provenance signals не заменяют видимые уведомления, которые могут требоваться законом или политикой конкретной площадки.
Для компаний, работающих через OpenAI API, дополнительно имеет смысл определить внутреннюю политику: в каких проектах text watermarking необходимо включать и как фиксировать это решение.
Но использовать detector как инструмент оценки сотрудников, авторов или качества статьи без учёта его ограничений — плохая идея.
Главное о водяных знаках ChatGPT
textGrain — это не секретная подпись автора и не универсальный детектор нейросетевого текста.
Это статистический provenance-сигнал, который OpenAI добавляет на этапе генерации поддерживаемого текста.
Он может помочь определить участие соответствующей AI-системы, пока в тексте сохранилось достаточно сигнала.
При этом watermark:
- не измеряет человеческий вклад;
- не устанавливает автора;
- не идентифицирует пользователя или его аккаунт;
- не раскрывает промпт или переписку;
- не устанавливает право собственности;
- не определяет юридическую ответственность;
- не подтверждает достоверность текста;
- не оценивает SEO-качество;
- может ослабнуть после редактирования и перевода.
И обратное правило тоже принципиально важно: отсутствие обнаруженного textGrain не доказывает, что текст создан человеком.
Для редакции это означает довольно простой подход. AI можно использовать в работе, но происхождение черновика, фактчекинг, содержательная человеческая проверка и ответственность за публикацию должны оставаться отдельными понятиями.
Watermark способен дополнить этот процесс.
Заменить его он не может.
FAQ
Вопросы о водяных знаках ChatGPT и textGrain
Нет. textGrain не вставляет специальные Unicode-символы, невидимые пробелы или необычную пунктуацию. Сигнал формируется статистически за счёт выбора слов и частей слов во время генерации.
Нет. Обнаруженный сигнал может указывать на участие поддерживаемой системы OpenAI, но не определяет автора и не показывает объём человеческого редактирования. Отсутствие сигнала также не является доказательством человеческого происхождения.
Он может существенно ослабнуть. В опубликованном эксперименте OpenAI с 400-токенными фрагментами замена 10% слов синонимами снизила обнаружение примерно с 92% до 66%, а замена 25% — примерно до 17%. Это результаты конкретного эксперимента, а не универсальная точность detector.
EU AI Act устанавливает разные требования для providers и deployers. Для AI-generated или manipulated текста, публикуемого для информирования общества по вопросам общественного интереса, предусмотрены требования прозрачности, однако содержательная человеческая проверка или редакционный контроль с редакционной ответственностью могут менять применимый режим. Конкретный случай необходимо оценивать отдельно.
Сам textGrain не является оценкой качества текста и не доказывает наличие или отсутствие SEO-ценности. При работе с AI-контентом важнее фактическая точность, самостоятельная ценность страницы, соответствие интенту, экспертная проверка и отсутствие массового производства малоценных материалов.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.