5 октября 2026 года GitHub представил ReviewBench — открытый benchmark для оценки AI code review agents. Идея выглядит простой: дать разным системам одинаковые pull request и проверить, какие реальные проблемы они обнаруживают. Но главное в ReviewBench не сам leaderboard, а попытка формализовать гораздо более сложный вопрос: что вообще означает «хорошее AI-ревью кода».
Для разработчика это важнее очередного сравнения моделей. Reviewer, который написал 15 комментариев, необязательно лучше reviewer, оставившего четыре. Первый мог перечислить стилистические мелочи, повторить одну проблему несколькими способами и пропустить ошибку авторизации. Второй мог найти именно тот дефект, который остановил бы релиз.
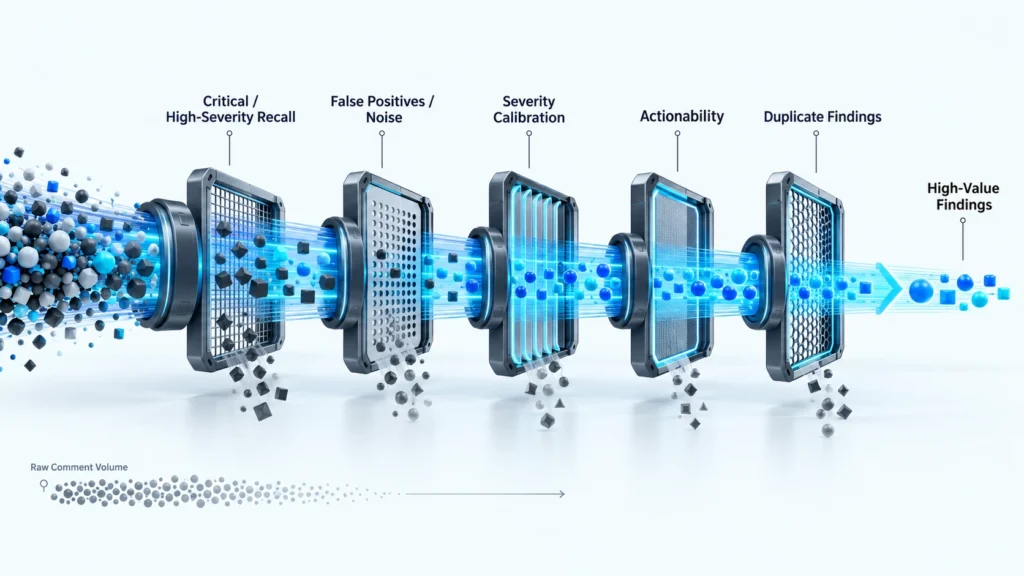
Поэтому ReviewBench интересен прежде всего как методика оценки AI-инструментов: смотреть на recall, precision, серьёзность найденных проблем, ложные срабатывания и практическую ценность замечаний, а не считать количество текста в pull request.
Почему качество AI code review трудно измерить
У code generation сравнительно понятны некоторые проверки: код собирается или нет, проходят тесты или нет, выполняется ли заданная функция. Code review гораздо менее однозначен.
Один reviewer старается найти максимум потенциальных проблем и неизбежно создаёт больше шума. Другой настроен консервативно и пишет только тогда, когда достаточно уверен. Третий хорошо обнаруживает локальные ошибки, но хуже понимает архитектурный контекст. Четвёртый полезен для security-review, но практически не комментирует maintainability.
Даже правильное замечание не всегда одинаково ценно. Ошибка, способная открыть доступ неавторизованному пользователю, и предложение переименовать переменную формально являются двумя findings, но их влияние на результат несопоставимо.
Отсюда одна из главных ошибок при внедрении AI reviewer: считать число найденных проблем самостоятельной метрикой качества.
В ReviewBench единицей оценки становится finding — конкретное замечание о проблеме в коде. Методика различает true positive и false positive и дополнительно хранит такие характеристики, как severity, category, scope, difficulty, требуемый контекст и actionability. Дубликаты, недоказуемые утверждения, незначительные замечания ниже принятого review bar и советы, которые не улучшают изменение, могут считаться false positive.
Что именно исправляет ReviewBench
GitHub строил корпус не как небольшую коллекцию специально подобранных демонстрационных багов. Перед формированием benchmark компания анализировала распределения 103,9 млн pull request. Итоговый корпус содержит 219 публичных PR из 187 open-source репозиториев и охватывает 19 языков программирования. Распределение языков и размеров репозиториев старались приблизить к GitHub в целом, хотя размер самих PR намеренно смещён в сторону более содержательных изменений, чтобы benchmark не состоял преимущественно из крошечных однострочных правок.
Следующая проблема — ground truth. Нельзя взять комментарии одного человеческого reviewer и объявить их исчерпывающим списком ошибок: человек тоже что-то пропускает.
ReviewBench поэтому собирает кандидатов из нескольких источников. В них входят реальные человеческие review comments, проблемы, которые можно вывести из последующих исправляющих commit автора, результаты детерминированных анализаторов и findings нескольких LLM-reviewer. Затем пересекающиеся замечания семантически дедуплицируются, чтобы одна и та же проблема не увеличивала denominator только потому, что её заметили несколько источников.
После этого findings проверяются по единой rubric. Текущая методика использует Claude Sonnet 5 как classifier для TP/FP и вспомогательных характеристик. При независимом аудите senior engineers совпали с benchmark по TP/FP в 96,6% случаев. Это важный показатель согласованности разметки, но его нельзя читать как «ReviewBench находит 96,6% багов» или «AI reviewer точен на 96,6%».
Более того, по точной оценке severity согласие заметно ниже: в опубликованной методике указано 62,9% полного совпадения на трёхуровневой шкале, хотя в пределах одного уровня agreement составляет 98,7%. Это хороший пример того, почему severity нельзя воспринимать как абсолютно объективную величину.
Grounded recall, precision и шум: как читать метрики
У ReviewBench есть две группы метрик: grounded и augmented.
Grounded recall отвечает на наиболее прямой вопрос: какую долю известных полезных findings из golden set reviewer обнаружил. Именно эту метрику GitHub предлагает использовать как основной сопоставимый сигнал при сравнении разных систем, потому что denominator остаётся одинаковым.
Grounded precision показывает качество тех candidate findings, которые удалось сопоставить с известными findings benchmark. Здесь есть важная техническая деталь: unmatched comments не входят в denominator grounded precision. Поэтому одной этой цифры недостаточно, чтобы понять реальный уровень шума во всём output reviewer.
Для этого полезнее смотреть на augmented precision. В ней учитываются все candidate findings: если комментарий не совпал с golden set, classifier отдельно определяет, является ли он новым полезным finding или false positive.
Augmented recall тоже учитывает новые подтверждённые проблемы, однако GitHub отдельно предупреждает о его ограничении: denominator становится зависимым от самого reviewer. Поэтому augmented recall удобен как диагностическая характеристика конкретной системы, но его нельзя использовать как единственный показатель для прямого рейтинга разных агентов.
Recall важных проблем
Для production-команды общий recall часто менее полезен, чем recall по severity.
Reviewer, который обнаруживает большинство низкоприоритетных замечаний, но пропускает дефекты высокой серьёзности, может выглядеть неплохо в общей статистике и одновременно быть слабым страховочным слоем перед merge.
ReviewBench позволяет пересчитывать результаты по severity и category. Это позволяет отдельно посмотреть, например, security или correctness findings высокой серьёзности и не смешивать их с documentation и небольшими maintainability-замечаниями.
False positives и noise
False positive — не просто неправильный комментарий. Для команды это потерянное время.
Разработчик должен прочитать finding, открыть контекст, проверить предположение AI, иногда запустить тест или изучить документацию, а затем доказать самому себе, что проблемы нет. Когда такой цикл повторяется десятки раз, автоматический reviewer начинает замедлять разработку вместо ускорения.
Поэтому полезный AI reviewer должен не только находить проблемы, но и знать, когда лучше ничего не писать.
Severity calibration
Следующий вопрос — правильно ли reviewer расставляет приоритеты.
Если потенциальная security-проблема и необязательный рефакторинг выглядят в review одинаково срочными, команда быстро получает alert fatigue. Если серьёзный defect обозначен как незначительный совет, его легче пропустить.
ReviewBench хранит severity отдельно именно потому, что простая бинарная классификация «нашёл / не нашёл» не передаёт реальную ценность review.
Actionability
Хорошее замечание должно позволять разработчику понять, что именно проверить или изменить.
Фраза «возможна проблема с безопасностью» почти бесполезна без указания причины. Гораздо ценнее finding, который объясняет условие возникновения дефекта, затронутый участок и ожидаемое направление исправления.
Actionability присутствует среди характеристик, предусмотренных методикой ReviewBench. Это важный критерий и для внутреннего теста любой команды: технически верный, но неоперационный комментарий создаёт меньше ценности, чем конкретное и проверяемое замечание.
Дубли
Одна проблема, сформулированная три раза, не превращается в три полезных находки.
ReviewBench специально выполняет semantic deduplication golden findings, а при scoring не позволяет нескольким candidate comments бесконечно получать credit за один и тот же известный defect. Дубли также входят в типичные failure modes false positive.
Это особенно важно при сравнении AI reviewer: comment volume без дедупликации легко создаёт иллюзию высокой активности инструмента.
Latency и cost
ReviewBench отдельно измеряет review duration. Для container-based evaluations фиксируется время работы reviewer, а итоговое значение не смешивается с precision или recall. Это правильный подход: скорость и качество — разные оси.
Cost в текущей методике не является одной из четырёх основных quality metrics. В разделе о возможных расширениях GitHub отдельно упоминает cost-adjusted metrics. При этом в собственных production-экспериментах Copilot GitHub уже сопоставляет offline quality с реальной стоимостью review.
Для команды вывод простой: latency и cost стоит фиксировать, но нельзя позволять дешёвому или быстрому reviewer компенсировать плохой recall критичных дефектов.
Как перенести идею ReviewBench на WordPress и PHP
Сам факт хорошего результата на общем benchmark ещё не говорит, насколько полезен reviewer на конкретном WordPress-проекте.
В опубликованном ReviewBench есть PHP, но benchmark охватывает множество языков, репозиториев и типов изменений. Он не моделирует в полном объёме специфику вашего набора плагинов, темы, архитектуры, legacy-кода и правил разработки.
Для WordPress есть собственный класс дефектов: отсутствие проверки capability, ошибки nonce verification, неправильное escaping и sanitization, небезопасная работа с SQL, некорректная регистрация REST route, проблемы AJAX handlers, неверное использование hooks, кеширование пользовательских данных, ошибки cron, multisite-особенности, совместимость версий PHP и WordPress.
Именно здесь полезно смотреть на задачи, где нейросети ускоряют работу WordPress-разработчика не как на обещание заменить разработчика, а как на перечень процессов, где AI можно подключить к уже существующей инженерной проверке.
Лучший локальный benchmark для такой команды — собственная история изменений.
Берутся historical pull request или эквивалентные diff, для которых уже известно, какие реальные проблемы были найдены до merge, какие обнаружились позже на тестировании и какие пришлось исправлять после релиза. Важно сохранить состояние кода до исправления, иначе reviewer будет проверяться уже на версии, где defect исчез.
Два AI reviewer получают одинаковые snapshots и одинаковый доступный контекст. Их результаты сохраняются без ручного редактирования. Затем опытный разработчик делает adjudication каждого finding: подтверждена ли проблема, насколько она серьёзна, относится ли к изменению, конкретен ли совет, не повторяет ли другой комментарий.
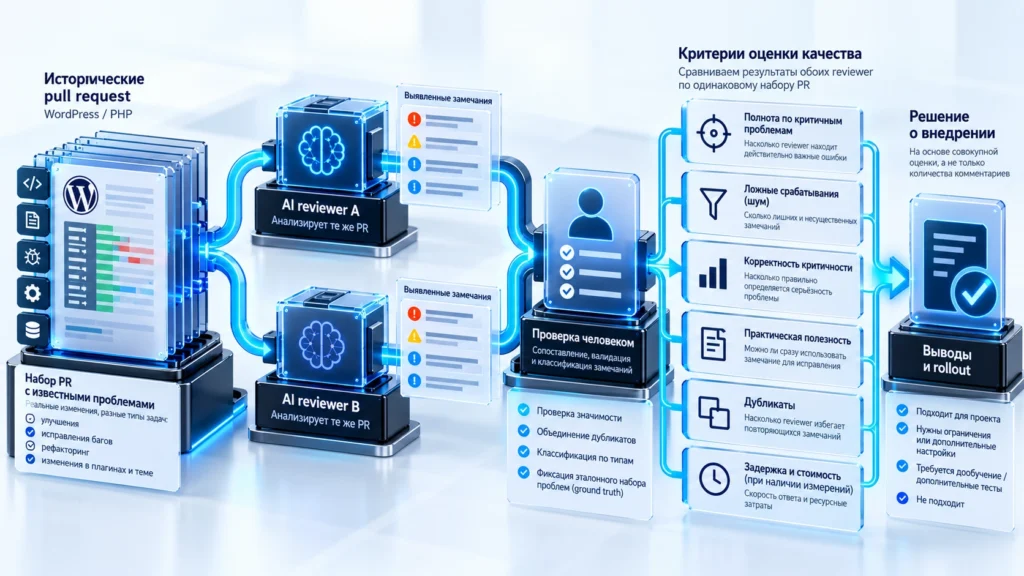
После adjudication сравнивается не число комментариев, а профиль reviewer.
Сначала — recall серьёзных известных дефектов. Затем false positives и общий уровень noise. После этого — насколько адекватно reviewer определяет severity, насколько comments actionable и сколько среди них повторов. Если система предоставляет стабильные измерения времени и стоимости, latency и cost добавляются отдельными показателями.
Числовой threshold нельзя универсально взять из ReviewBench. Команда должна установить baseline сама. Для небольшого корпоративного сайта один профиль допустимого шума, для платежного плагина или инфраструктурного проекта — другой.
Где заканчивается применимость benchmark
ReviewBench заметно улучшает воспроизводимость сравнения AI code review systems, но его результаты нельзя превращать в сертификат качества.
Первая граница — неполнота golden set. GitHub прямо пишет, что конечное число producers не способно гарантированно обнаружить все реальные проблемы. Если defect не нашёл ни человек, ни анализатор, ни одна из использованных моделей, он может отсутствовать в reference set.
Вторая — зависимость от classifier. Решение о том, является ли unmatched finding полезным, принимает Claude Sonnet 5 по опубликованной rubric. Даже при высокой согласованности с инженерами TP/FP остаётся оценочным понятием, зависящим от принятого review bar.
Третья — matcher. Чтобы понять, описывает ли candidate comment тот же defect, что и golden finding, используется семантическое LLM-сопоставление. Ошибка matcher способна потерять или ошибочно выдать grounded credit.
Четвёртая — offline/online gap. Benchmark измеряет поведение на зафиксированных historical PR. В production появляются собственные conventions, архитектурные зависимости, CI, внутренние API, контекст задач и требования конкретной команды. Сам GitHub поэтому сравнивает offline-сигнал ReviewBench с online experiments, а не объявляет benchmark заменой production validation.
Наконец, code review не равно code generation. Способность модели написать работающий код не означает способности систематически находить дефекты в чужом изменении, а хороший reviewer не обязательно является лучшим coding agent.
Практический framework оценки AI reviewer
Перед тестом стоит определить не «какой AI лучший», а роль reviewer в процессе разработки.
Если он должен быть первым фильтром перед человеком, приоритетом может быть широкий recall при приемлемом шуме. Если он запускается на каждый небольшой PR и разработчики чувствительны к лишним комментариям, выше становится цена false positives. Для security-sensitive участка важнее отдельный recall по серьёзным security findings, а не средний score по всем категориям.
Набор historical PR тоже должен соответствовать реальной работе. Если команда в основном разрабатывает WordPress-плагины, benchmark из JavaScript frontend-компонентов и Python backend-задач даст слабый сигнал, даже если формально проведён без ошибок.
Результат лучше хранить как профиль, а не одно число: recall важных дефектов, noise, severity calibration, actionability, duplicates, latency и cost. Тогда видно не просто «Reviewer A набрал больше», а почему один вариант лучше подходит конкретному workflow.
И после rollout оценка не заканчивается. Следует смотреть, какие AI comments разработчики действительно исправляют, какие регулярно закрывают как нерелевантные, какие дефекты всё равно обнаруживаются человеком и что уходит в production незамеченным. Именно такой feedback loop превращает benchmark из красивой таблицы в инженерный инструмент.
GitHub сам формулирует ограничение для Copilot достаточно прямо: AI-review не гарантирует обнаружение всех проблем, его feedback нужно проверять и дополнять человеческим review. Даже появившаяся возможность Copilot approval не отменяет этого ограничения.
Поэтому главный вывод ReviewBench не в том, что теперь существует ещё один рейтинг AI-инструментов. Он в другом: качество code review можно и нужно измерять содержательно.
Reviewer ценен не тогда, когда пишет больше всех. Он ценен, когда находит проблемы, которые действительно стоило найти, не отвлекает команду ложными тревогами, правильно показывает приоритет и помогает разработчику быстрее принять верное решение.
FAQ
Частые вопросы о GitHub ReviewBench
ReviewBench — открытый benchmark GitHub для воспроизводимой оценки AI-систем, выполняющих code review pull request. Он использует общий набор PR, golden findings и единую процедуру сопоставления и оценки результатов.
Не напрямую. Benchmark полезен для сравнения систем на одинаковых данных, но результат зависит от состава корпуса, правил разметки, severity, выбранного соотношения precision и recall и особенностей конкретного проекта. Для окончательного выбора нужен тест на собственном коде.
Большое количество комментариев может означать как хорошее покрытие проблем, так и большое число ложных или малозначимых замечаний. Recall показывает, какую долю известных полезных проблем reviewer действительно обнаружил.
Он может использоваться как методический ориентир, а PHP присутствует в опубликованном наборе, но общий benchmark не моделирует все особенности конкретного WordPress-проекта. Для реального внедрения лучше дополнить его собственным набором исторических PR.
GitHub прямо предупреждает, что Copilot может пропускать проблемы и ошибаться, и рекомендует проверять его выводы и дополнять AI-review человеческим review. Для security-sensitive и критичного кода человеческий контроль особенно важен.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.