AI-агенты не отменили Git и не обнаружили в нём внезапный фундаментальный дефект. Они изменили другое — частоту, параллельность и ритм работы вокруг репозитория.
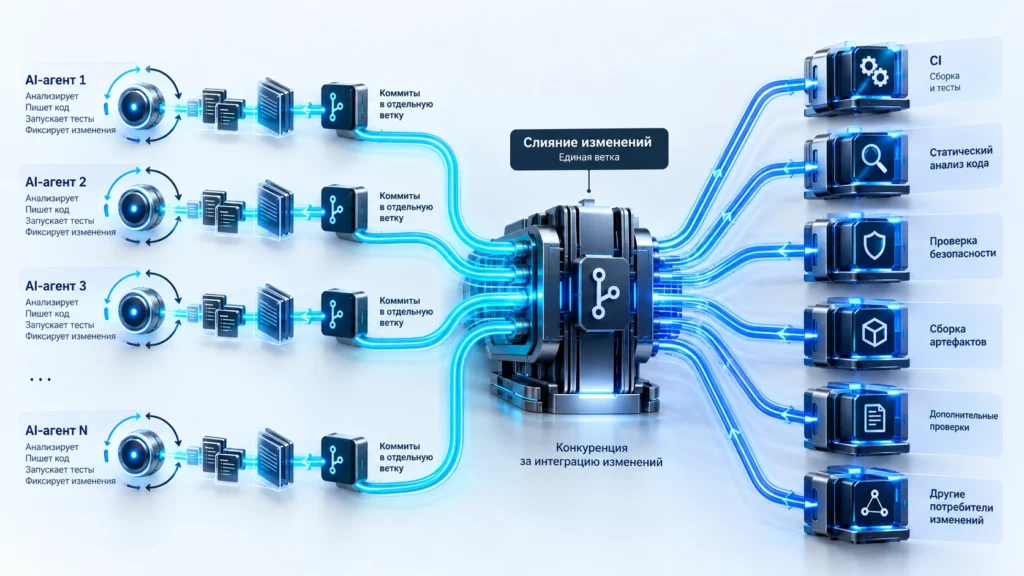
Человеку нормально несколько минут писать код, затем проверить изменение, сделать commit, открыть pull request и переключиться на следующую задачу. Coding agent способен повторять короткий цикл «изменил — проверил — сохранил состояние — продолжил» значительно чаще. Если таких агентов десятки или тысячи, знакомый Git workflow превращается для инфраструктуры в непрерывный поток конкурентных записей.
6 октября 2026 года GitHub подробно рассказал, почему этот профиль нагрузки заставляет компанию перестраивать слой, который обслуживает Git-репозитории. Масштаб хорошо показывает динамика: суммарная Git-активность выросла с 218,2 млрд событий в сентябре 2025 года до 473,3 млрд в августе 2026-го. В сентябре 2026 года разработчики и агенты создали 7,38 млрд commits — более чем в пять раз больше, чем годом ранее. Количество pushes выросло с 0,69 до 3,35 млрд в месяц.
Это ещё не означает, что все эти изменения созданы AI или что обычному проекту пора проектировать собственную распределённую Git-платформу. Но верхний край нагрузки уже показывает GitHub, каким становится репозиторий, когда люди, CI и целые группы агентов начинают работать одновременно.
Главная перемена — агент ждёт Git чаще, чем человек
Для человека лишние 200 или 500 миллисекунд в отдельном push обычно незаметны. У агента ситуация другая. Если его рабочий цикл зависит от завершения push, проверки ветки или получения нового состояния репозитория, небольшая задержка становится частью каждой итерации.
GitHub выделяет несколько связанных эффектов.
Первый — commit turnaround. Агент может фиксировать промежуточное состояние после очень коротких действий, поэтому latency одной операции начинает ограничивать скорость всей петли.
Второй — write throughput. Тысячи параллельных веток могут независимо принимать commits, однако все записи в итоге обслуживаются одной инфраструктурой репозитория.
Третий — конкуренция за общую reference. Отдельные feature branches хорошо распараллеливаются, но merge в main, release branch или другую общую точку снова сводит работу в один поток согласованных изменений.
И четвёртый эффект появляется уже после записи: один push способен породить большое число чтений. CI, security scanners, code analysis и другие системы начинают получать или клонировать новое состояние. Только GitHub Actions в сентябре 2026 года запускался 3,26 млрд раз — более чем в четыре раза чаще, чем годом ранее.
Именно поэтому проблему нельзя свести к «сделаем clone быстрее». Чтения сравнительно удобно масштабировать кэшами и дополнительными обслуживающими узлами. Запись сложнее: новое состояние должно быть надёжно сохранено и стать согласованно видимым другим участникам системы.
Где прежняя архитектура GitHub встречает потолок
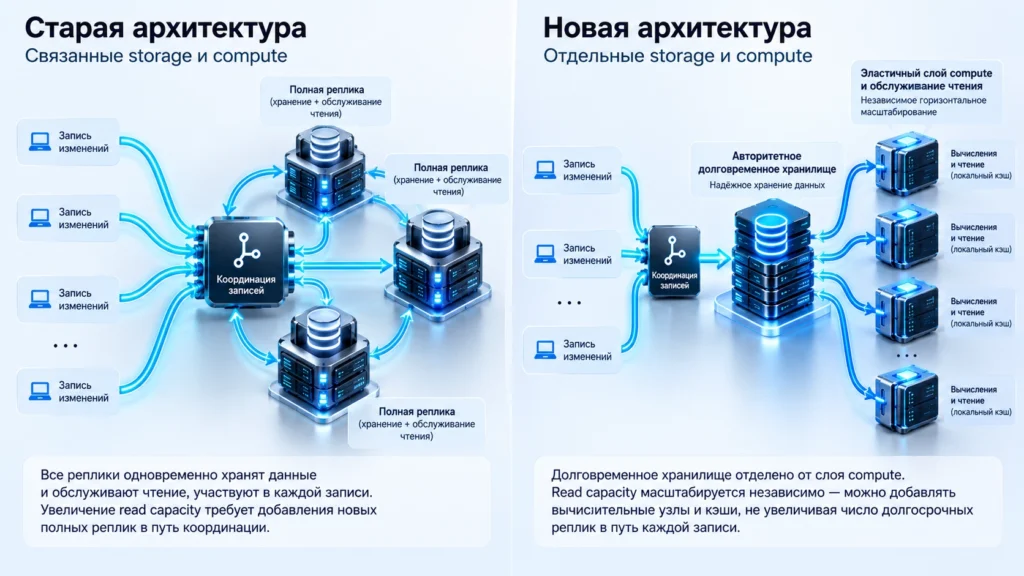
Текущая инфраструктура GitHub использует систему Spokes. Репозиторий хранится полными копиями на локальных дисках нескольких fileservers — по умолчанию пяти. Эти копии одновременно решают две задачи: обеспечивают долговечность данных и дают дополнительные узлы для обслуживания чтений.
При обновлении reference GitHub использует three-phase commit и quorum, чтобы разные клиенты не получили противоречивое состояние репозитория. Эта архитектура много лет успешно обслуживает GitHub и, по данным самой компании, поддерживает около миллиарда репозиториев.
Проблема проявляется на экстремальной параллельности.
Если системе нужно больше мощности для чтения, логично добавить ещё одну replica. Но поскольку replica одновременно является частью durable storage, она также оказывается участником пути записи. Чем больше таких участников, тем больше coordination требуется при push. Скорость записи начинает зависеть в том числе от наиболее медленного участника группы.
Получается неприятная связь: масштабирование reads добавляет работу writes.
Потеря одного узла одновременно уменьшает read capacity и долговечную репликацию. А потеря quorum способна остановить записи. Для обычных репозиториев это разумный компромисс. Для среды, где один крупный repository постоянно атакуют тысячи конкурентных операций, связь durability и serving capacity становится архитектурным ограничителем.
Не Git становится «слишком старым для AI». Ограничение находится в способе распределённо хранить и публиковать огромное количество Git-изменений.
Новая идея GitHub: согласовывать только то, что действительно требует согласования
Главный принцип новой архитектуры выглядит почти очевидным: не включать в критический путь push работу, которую можно выполнить независимо.
GitHub пишет, что реального согласования требует прежде всего обновление reference. Хранение Git objects, проверка object connectivity, secret scanning и часть другой работы гораздо объёмнее, но она не обязана целиком сериализовать остальные записи. Значительную часть этих операций можно выполнять параллельно.
Это важный принцип distributed systems: coordination сохраняется там, где без неё нарушится корректность, но не распространяется автоматически на всё действие.
То же относится к обслуживанию репозитория. Compaction и garbage collection требуют ресурсов, однако не обязаны конкурировать за тот же compute с текущими pushes и fetches. В проектируемой архитектуре отдельные workers смогут заниматься maintenance непосредственно поверх durable storage, не превращая обслуживание данных в препятствие для живого трафика.
В результате критический путь записи становится уже. Система пытается быстрее завершить именно минимально необходимую согласованную часть, а тяжёлую независимую работу распределить вокруг неё.
Storage и compute больше не должны масштабироваться вместе
Второй большой сдвиг — разделение долговечного хранения и вычислительного слоя.
В нынешней модели локальная полная копия repository одновременно является durable replica и местом выполнения Git-операций. В новой архитектуре authoritative repository data GitHub размещает в Azure Blob Storage, а запросы обслуживают отдельные compute workers с локальными кэшами.
Отсюда появляются сразу несколько преимуществ.
Read capacity теперь можно наращивать, не добавляя ещё одну полную durable copy в путь каждой записи. При всплеске CI или активности агентов GitHub может увеличить количество workers, обслуживающих чтения.
Отказ compute worker перестаёт означать потерю одной из authoritative copies. Новый worker может подняться и постепенно наполнить кэш данными из durable storage.
Наконец, вычислительную мощность можно приблизить к реальной текущей нагрузке. Release, массовая работа agent fleet или большой CI burst требуют больше compute — его можно временно добавить. После окончания всплеска дополнительная мощность больше не нужна.
GitHub сообщает, что во внутренних benchmark эта архитектура обеспечивала до 35 раз более высокую write throughput. Здесь принципиально важно слово «до». Компания не обещает 35-кратное ускорение каждого push, repository или GitHub Actions workflow. Речь идёт о результате внутренних испытаний инфраструктурной архитектуры при определённых нагрузках.
Почему после ускорения записи проблема всё равно возвращается к одной ветке
Допустим, инфраструктура научилась принимать в десятки раз больше независимых writes. Это ещё не означает, что приложение можно безопасно собирать из бесконечного числа одновременно изменяемых веток.
В какой-то момент изменения должны встретиться.
Десять агентов могут независимо работать каждый в своей branch. Но если все десять хотят изменить одну функцию, один package.json, общий API-контракт или одновременно попасть в main, физическое масштабирование Git-хранилища не устранит логическую зависимость между изменениями.
Поэтому agent-scale development — не только инфраструктурная задача GitHub. Это ещё и задача организации работы.
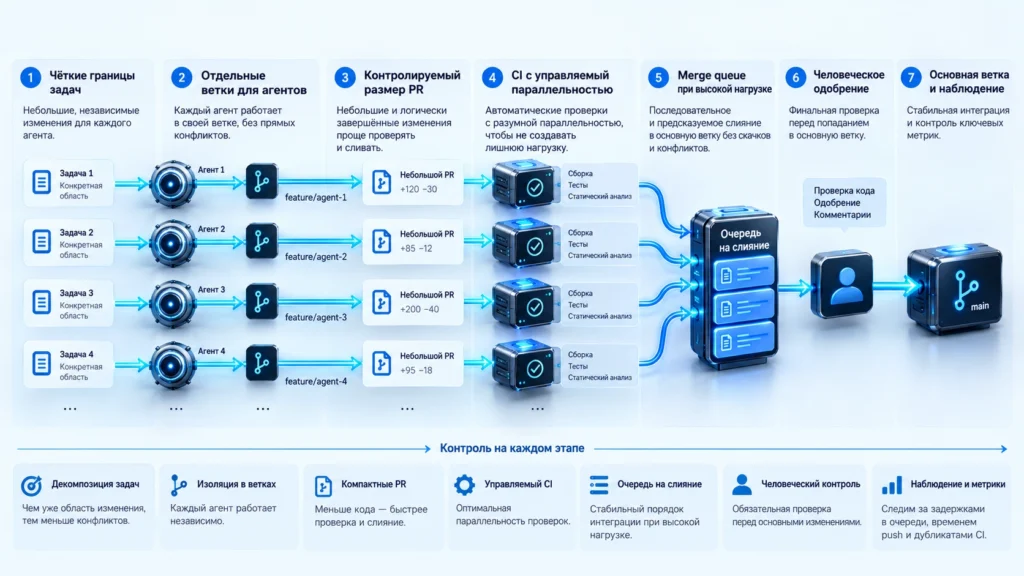
Чем выше параллельность, тем важнее хорошие границы задач. Агент, которому поручено «улучшить весь проект», создаёт гораздо более широкую поверхность конфликтов, чем агент с ограниченным модулем, понятным контрактом и предсказуемым набором файлов.
Этим agentic development напоминает обычную работу большой команды, только события происходят значительно быстрее. Плохая декомпозиция, которую пять разработчиков замечали за неделю, пятьдесят агентов способны превратить в очередь конфликтующих PR за несколько минут.
Для WordPress-проектов полезно смотреть на задачи WordPress-разработчика для ускорения с AI именно с этой позиции: ускорять стоит не максимальное количество параллельных изменений, а те участки работы, у которых можно задать ясные границы и критерий готовности.
Практический сценарий: несколько coding agents в WordPress-репозитории
Представим не GitHub с миллиардами событий, а обычную продуктовую команду. Один агент изменяет PHP-код темы, второй работает над отдельным плагином, третий обновляет тесты, четвёртый проверяет фронтенд. Каждый работает в собственной branch, делает промежуточные commits, периодически push и открывает PR.
На этом масштабе копировать инфраструктуру GitHub бессмысленно. Azure Blob Storage, собственный distributed Git serving layer или новая система репликации не решат реальные проблемы такой команды.
Полезнее работать с источниками нагрузки.
Локальные checkpoints могут оставаться частыми, но нет необходимости автоматически превращать каждое микроскопическое изменение в remote push и полный CI pipeline. Точку публикации стоит связывать с состоянием, которое действительно имеет смысл проверять на сервере.
Следующая зона — CI fan-out. Если три новых pushes за минуту запускают три одинаковых тяжёлых workflow для одной branch, два первых результата могут потерять ценность ещё до завершения. GitHub Actions позволяет управлять concurrency и, при необходимости, отменять устаревшие runs одной группы или выстраивать их в очередь.
Но ограничивать параллельность нужно осмысленно. Независимые unit tests можно выполнять параллельно. Одновременные deployments в один staging environment, миграции одной базы данных или дорогие e2e-проверки нескольких уже устаревших commits — хорошие кандидаты на coordination.
Далее появляется общая ветка. Branch protection позволяет требовать status checks, review, разрешение обсуждений и другие условия перед merge. GitHub отдельно подчёркивает возможность обязательного approving review — это особенно важно, когда исходное изменение подготовил агент.
Если готовых pull requests становится достаточно много и все они конкурируют за активно изменяемую branch, можно рассматривать merge queue. Она проверяет изменение уже в контексте актуального состояния целевой ветки и предыдущих элементов очереди. GitHub прямо описывает этот механизм как полезный для branches с большим числом ежедневных merges. Для обязательных GitHub Actions checks workflow должен реагировать и на событие merge_group.
Именно здесь становится важным отдельное правило как проверять качество AI-ревью кода: автоматическое review может быть дополнительным фильтром, но не должно незаметно превращаться в замену владельцу кода там, где цена ошибки высока.
Какие метрики покажут проблему раньше, чем число commits
Само количество commits мало что говорит о состоянии процесса. Тысяча маленьких commits может проходить без проблем, а несколько крупных PR — создать длинную очередь на integration.
Для команды полезнее связка операционных сигналов.
Push latency показывает, начал ли удалённый repository отвечать заметно медленнее при росте параллельности. Смотреть лучше не только среднее значение, но и хвост распределения: редкие очень медленные pushes сильнее влияют на автоматические loops.
PR queue time показывает время от готовности изменения до фактического merge. Если агенты пишут код быстрее, а очередь растёт, производительность команды не увеличилась — bottleneck просто переместился.
CI runs per merged PR помогает увидеть повторную работу. Если один итоговый PR породил множество одинаковых отменённых или устаревших runs, fan-out требует настройки.
Время обязательных checks показывает, какая часть feedback loop действительно ограничивает скорость следующего шага.
Доля конфликтующих или повторно открываемых PR помогает понять качество декомпозиции задач. При росте этого показателя добавлять ещё агентов обычно бесполезно.
И наконец, имеет смысл измерять количество изменений, дошедших до human approval без повторной существенной переработки. Agentic development должен уменьшать стоимость результата, а не только увеличивать скорость появления diff.
Где опыт GitHub нельзя переносить на обычный проект
Самая опасная интерпретация этой истории — решить, что любой команде с Copilot или coding agent теперь нужна отдельная Git-инфраструктура.
GitHub решает задачу совершенно другого класса. В августе 2026 года самый загруженный repository на платформе получил около миллиарда requests за месяц. Общий объём Git activity измеряется сотнями миллиардов событий. Новая архитектура проектируется в том числе для организаций, способных запускать тысячи агентов против одной codebase.
WordPress-сайт, SaaS-продукт или корпоративный monorepo почти наверняка находится на много порядков ниже.
Поэтому копировать решение не нужно. Переносить стоит принцип.
Если reads и writes имеют разные профили нагрузки — не связывайте их масштабирование без необходимости. Если только небольшая часть операции действительно требует consensus — не сериализуйте вокруг неё всю работу. Если тяжёлое обслуживание можно вынести из пользовательского critical path — выносите. Если автоматизация увеличивает скорость производства изменений — отдельно проектируйте контроль интеграции этих изменений.
Именно в этом архитектурная ценность публикации GitHub выходит за пределы самого GitHub.
AI ускоряет разработку, но coordination никуда не исчезает
Интересная часть agentic development состоит в том, что автоматизация не отменяет фундаментальные проблемы распределённых систем. Наоборот, она быстрее доводит систему до мест, где эти проблемы начинают определять производительность.
Агенты могут независимо писать код. Git может хранить огромное количество объектов. Compute можно горизонтально масштабировать. CI можно запускать параллельно.
Но общее состояние продукта всё равно требует точек согласования.
GitHub отвечает на это разделением durable storage и compute, уменьшением coordination в critical path и независимым масштабированием чтений. По внутренним тестам потенциал для write throughput велик — до 35×, однако компания сама формулирует результат как характеристику строящейся инфраструктуры, а не универсальный коэффициент ускорения.
Для обычной команды вывод проще: не пытаться сделать Git «быстрее для AI» раньше времени. Сначала определить, где именно появляется очередь — на push, CI, review или merge. Затем уменьшать ненужную параллельную работу и сохранять coordination только в точках, где она защищает корректность.
AI-агенты увеличивают скорость производства изменений. Архитектура должна сделать так, чтобы вместе с ней не увеличивалась скорость производства конфликтов, бесполезных CI-запусков и непроверенного кода.
FAQ
GitHub, Git и AI-агенты: что меняется в инфраструктуре
Агент способен выполнять короткие циклы изменения, проверки и фиксации состояния значительно чаще человека. Несколько агентов одновременно создают больше независимых веток, pushes, проверок и CI-запусков, поэтому важны уже не только объёмы чтения репозитория, но и пропускная способность записи и координации.
Нет. Речь идёт прежде всего об инфраструктуре GitHub, которая хранит и обслуживает Git-репозитории. Семантика Git, ветки, commits, pull requests и привычные процессы разработки сохраняются. GitHub меняет архитектуру нижнего уровня, чтобы эффективнее обрабатывать значительно более высокую параллельную нагрузку.
GitHub сообщает, что новая архитектура во внутренних benchmark обеспечивала до 35 раз более высокую пропускную способность записи. Это верхний результат внутренних испытаний конкретной инфраструктуры, а не обещание ускорить push любого проекта в 35 раз.
Нет. Практический вывод для небольшой команды заключается не в копировании Azure Blob Storage или распределённой инфраструктуры GitHub, а в контроле количества параллельных веток, CI fan-out, размеров PR, merge queue, обязательных проверок и точек человеческого одобрения.
Не автоматически. Она полезна прежде всего для активно изменяемой целевой ветки с большим потоком готовых PR. GitHub рекомендует merge queue именно для веток, куда ежедневно сливается много pull requests от разных участников; обязательные Actions-проверки при этом должны поддерживать событие merge_group.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.