В приложении далеко не каждый запрос к модели должен заканчиваться абзацем текста. Иногда системе нужен всего один ответ: относится ли документ к условию, в какой отдел отправить обращение или насколько серьёзна проблема по заранее определённой шкале.
Для таких задач OpenAI выпустила Decisions API — отдельный POST /v1/decisions. По состоянию на 11 октября 2026 года API находится в public beta и работает с gpt-6-luna. OpenAI заявляет для него примерно десятикратное преимущество по скорости относительно Responses API именно в сценариях типизированных решений.
Ключевое отличие здесь не в том, что модель стала «детерминированной». Решение всё ещё строится моделью и требует проверки качества. Изменился контракт: вместо свободной генерации приложение заранее формулирует вопрос и ожидаемый тип ответа.
Как работает OpenAI Decisions API: predicate, choice и score
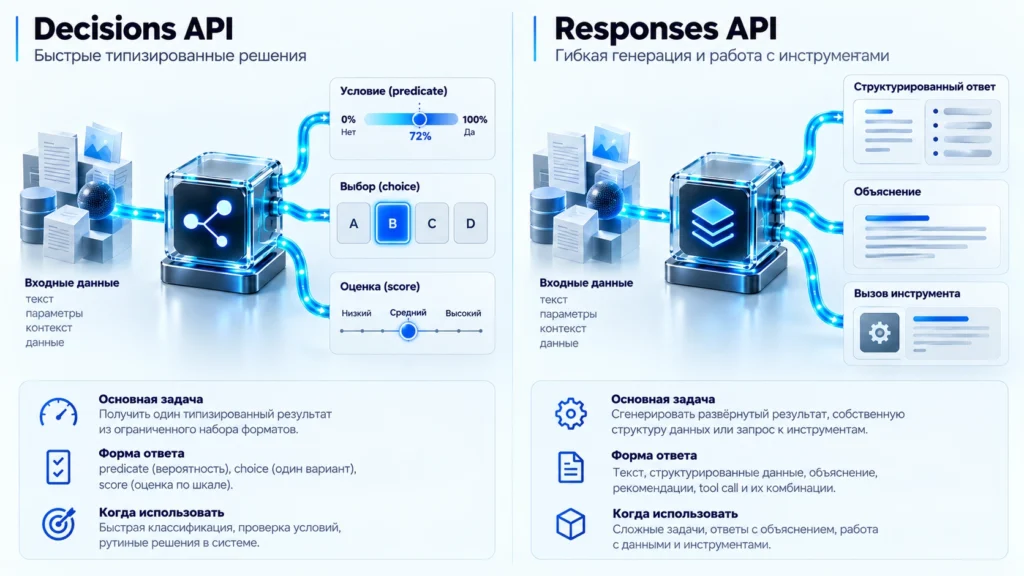
У запроса три основные части: model, общий input и массив questions. Ответ приходит в answers, причём каждому вопросу полезно задавать уникальное name, которое API возвращает вместе с результатом. Входом может быть текст либо пользовательское сообщение с текстом и изображением.
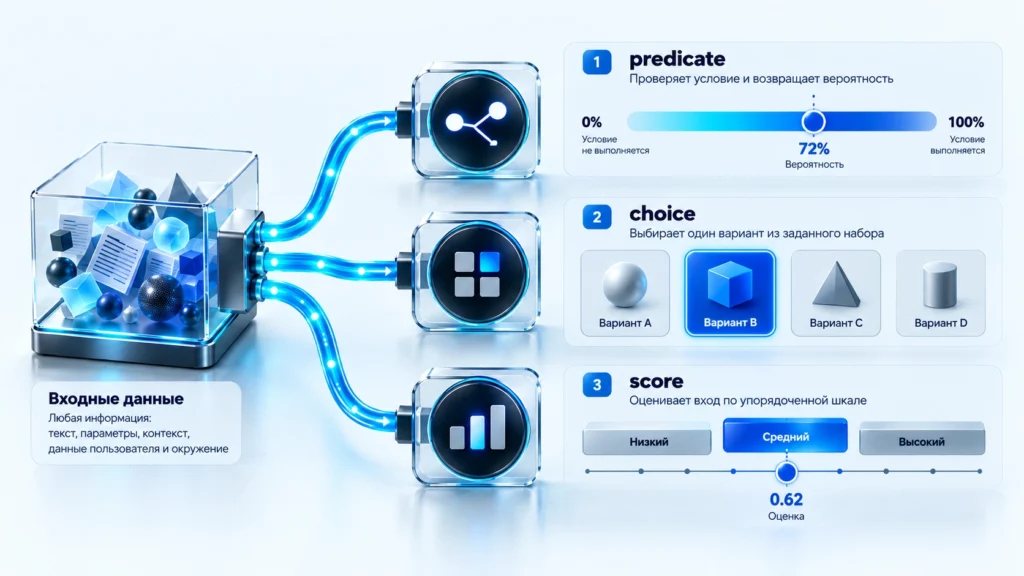
Самое важное — правильно выбрать тип вопроса.
| Тип | Когда использовать | Основной результат |
|---|---|---|
predicate | нужно проверить одно условие | вероятность от 0 до 1 |
choice | нужно выбрать одну категорию из известного набора | одно из переданных приложением значений |
score | нужно оценить объект по упорядоченным уровням | числовой score между уровнями |
predicate: выполняется условие или нет
predicate подходит не только для буквального yes/no. Endpoint возвращает probability — оценку того, насколько условие считается истинным.
Например:
- содержит ли обращение запрос на возврат;
- релевантен ли фрагмент документа вопросу;
- виден ли дефект на фотографии;
- требуется ли обязательная дополнительная проверка.
Важно не превращать 0.91 в утверждение «верно с вероятностью 91%» без собственной валидации. Документация называет это оценкой модели и прямо предлагает выбирать порог под задачу приложения.
choice: выбрать маршрут из фиксированного набора
Для классификации и routing обычно нужен choice. Приложение перечисляет допустимые значения и объясняет смысл каждого.
Например:
{
  "type": "choice",
  "name": "department",
  "instructions": "Which department should handle this request?",
  "choices": [
    {
      "value": "billing",
      "description": "Payments, invoices, refunds and duplicate charges."
    },
    {
      "value": "technical",
      "description": "Errors and problems using the product."
    },
    {
      "value": "sales",
      "description": "Questions about buying, plans and commercial terms."
    },
    {
      "value": "other",
      "description": "Requests outside the listed categories."
    }
  ]
}
Ответ содержит выбранное значение, распределение вероятностей по вариантам и confidence. OpenAI отдельно рекомендует иметь fallback вроде other, если реальные входы могут выходить за пределы таксономии. Такой результат можно отправлять в общую очередь вместо принудительной классификации в неподходящий отдел.
score: не класс, а положение на упорядоченной шкале
score нужен, когда уровни имеют естественный порядок: например, low → medium → high или cosmetic → workaround available → fully blocked.
API считает score как средневзвешенное по вероятностям значение индексов уровней. Поэтому результат способен оказаться между двумя категориями. В официальном примере распределение 0.1 / 0.7 / 0.2 по уровням 0 / 1 / 2 даёт итоговый score = 1.1.
Это принципиально отличается от choice: если отделы billing и technical не образуют шкалу, их нельзя осмысленно усреднять. Для них нужен choice.
Decisions API или Responses API: выбор зависит от формы результата
Фраза «Decisions быстрее Responses» сама по себе не означает, что новый endpoint заменяет Responses API.
OpenAI разделяет эти сценарии достаточно чётко. Decisions предназначен для трёх описанных типов ответа. Если приложению требуется объект по собственной JSON-схеме, извлечение набора полей или текстовое объяснение, документация направляет к Structured Outputs в Responses API. Если модель должна решить, какой инструмент вызвать и с какими аргументами, нужен function calling.
Практический критерий можно сформулировать так:
| Задача | Что выбрать |
|---|---|
| «Это спам?» | predicate |
| «В какой отдел отправить?» | choice |
| «Насколько критична проблема?» | score |
| «Извлеки имя, email, компанию и сформируй JSON» | Responses + Structured Outputs |
| «Объясни клиенту причину решения» | Responses API |
| «Выбери инструмент и передай аргументы» | function calling |
Поэтому Decisions особенно интересен как маленький decision-layer внутри большей системы. Он может классифицировать запрос до того, как более дорогая генеративная ветка вообще понадобится.
Например, сначала приложение определяет, что вопрос относится к технической поддержке, а уже затем запускает нужный retrieval, workflow или одного из AI-агентов для бизнеса и сайта.
Практический сценарий: routing заявок billing / technical / sales / other
Рассмотрим endpoint не в демонстрационном запросе, а в production-контуре.
Допустим, на сайт поступают обращения из формы поддержки. Сейчас оператор вручную решает, куда направить каждое: биллинг, техническая команда, продажи или общая очередь.
Сначала нужна таксономия. Категории должны различаться по наблюдаемым признакам, а не по внутренней интуиции команды.
billing — оплата, счета, возвраты и двойные списания.technical — ошибки и невозможность использовать продукт.sales — покупка, тарифы и коммерческие условия.other — всё, что не соответствует этим определениям.
После этого создаётся ground truth: набор реальных обращений, для которых человек зафиксировал правильный маршрут. Без него невозможно ответить на главный production-вопрос — насколько полезны значения choice, probabilities и confidence именно на вашем потоке.
Сам запрос может выглядеть так:
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "После продления тарифа деньги списались два раза. Как вернуть второе списание?",
    "questions": [
      {
        "type": "choice",
        "name": "department",
        "instructions": "Which department should handle this customer request?",
        "choices": [
          {
            "value": "billing",
            "description": "Payments, invoices, refunds and duplicate charges."
          },
          {
            "value": "technical",
            "description": "Errors or problems using the product."
          },
          {
            "value": "sales",
            "description": "Purchasing, plans and commercial terms."
          },
          {
            "value": "other",
            "description": "Requests outside these categories."
          }
        ]
      }
    ]
  }'
Дальше начинается та часть, которую нельзя заменить чтением документации: калибровка на собственных данных.
Допустим, billing с высокой уверенностью в тестовой выборке почти всегда маршрутизируется правильно, а sales регулярно смешивается с вопросами о действующем тарифе. Это уже сигнал не «повысить confidence», а проверить определения категорий, инструкции и реальные примеры.
OpenAI прямо рекомендует использовать размеченные примеры приложения для выбора thresholds и учитывать стоимость false positive и false negative. Универсального production-порога документация не задаёт.
confidence — управляющий сигнал, а не гарантия истины
Типичная ошибка — написать:
confidence >= 0.90 → решение правильноеИз значения 0.90 такой вывод не следует.
Правильная конструкция выглядит иначе:
если выбранная категория прошла наш проверенный threshold:
    разрешить автоматическую маршрутизацию
иначе:
    отправить на human review
Сам threshold появляется только после eval на ground truth.
Если ошибка billing → sales приводит лишь к небольшой задержке, её цена одна. Если ошибочная классификация автоматически запускает возврат денег, цена ошибки совсем другая. Во втором сценарии decision вообще не должен напрямую инициировать необратимое действие без дополнительной бизнес-политики.
Fallback должен проектироваться заранее
Категория other — не признак слабой системы. Это нормальная часть контракта.
Пользователь может прислать предложение о партнёрстве, жалобу на контент, запрос на удаление персональных данных или текст, в котором одновременно смешаны техническая проблема и вопрос об оплате.
Если система знает только три класса, принуждение модели выбрать один из них создаёт ложную определённость. Fallback позволяет честно вывести такой случай из автоматического маршрута.
Отдельно нужно обрабатывать refusal: официальные примеры SDK проверяют этот тип ответа до чтения результата predicate, choice или score.
Несколько решений за один запрос — только если они независимы
В questions можно передавать несколько независимых вопросов к одному общему input, причём их типы могут различаться.
Например, для одного обращения система способна отдельно определить:
- отдел через
choice; - наличие признаков срочности через
predicate; - степень влияния проблемы через
score.
Но есть важная граница. Если второй вопрос логически зависит от ответа на первый, OpenAI рекомендует делать отдельные запросы. Это позволяет приложению явно контролировать последовательность вместо скрытого каскада внутри одной операции.
Для production-архитектуры это полезное ограничение: Decisions выдаёт измеримые сигналы, а бизнес-политика остаётся в вашем коде.
Где заканчивается AI и начинается обычное бизнес-правило
Decisions API полезен именно там, где вход не удаётся надёжно описать одним if.
Текст «с меня списали оплату дважды» требует интерпретации языка. А поле формы reason=billing — уже нет.
Если приложение знает:
subscription_status = canceledто проверять моделью, отменена ли подписка, бессмысленно.
То же относится к:
- идентификатору тарифа;
- коду HTTP-ошибки;
- роли пользователя;
- явно выбранному типу заявки;
- стране из проверенного справочника;
- точному флагу состояния в базе.
Для таких признаков deterministic business rule быстрее проверить, проще протестировать и легче объяснить при аудите.
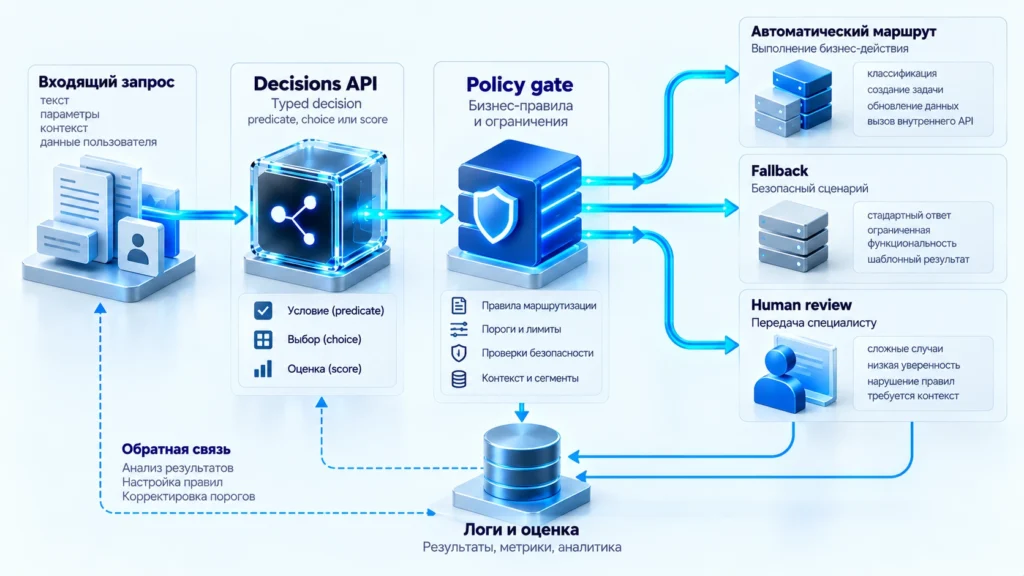
Полезная архитектура поэтому обычно не выглядит как «отдать всё AI». Сначала выполняются точные правила. Decisions получает только тот остаток, где требуется семантическая интерпретация. После него снова включается обычный код: thresholds, permissions, fallback, human review и разрешение конкретного действия.
Это особенно важно для систем, где модельное решение способно повлиять на деньги, доступ, юридический статус или необратимую операцию.
Скорость и стоимость: у endpoint отдельная экономика
На 11 октября 2026 года OpenAI указывает для /v1/decisions с gpt-6-luna цену $0.10 за 1 млн входных токенов. Для этого endpoint оплачиваются только input tokens: отдельных cache-read, cache-write и output-token charges нет. При этом могут применяться надбавки региональной обработки и множители для long context.
Это важнее сравнивать не с ценой «одного ответа ChatGPT», а с полным production-процессом.
Если раньше для простой классификации запускалась генерация ответа, затем JSON парсился, валидировался и иногда повторялся из-за нарушения формата, typed endpoint убирает часть ненужной работы.
Но низкая цена одного вызова не отменяет стоимость ошибок. Экономия на inference теряет смысл, если неправильная автоматическая маршрутизация создаёт ручную работу дальше по цепочке.
Поэтому метрики стоит разделять:
- latency самого decision;
- стоимость API;
- доля автоматических маршрутов;
- доля fallback;
- precision/recall или другая прикладная метрика по важным классам;
- число исправлений оператором;
- бизнес-стоимость ошибочного решения.
Данные, ZDR и региональная обработка
Для /v1/decisions OpenAI указывает отсутствие использования данных API для обучения моделей, стандартное хранение abuse-monitoring logs до 30 дней и возможность Zero Data Retention для подходящих клиентов. При включённом ZDR действуют отдельные условия и исключения.
Документация Decisions также указывает поддержку ZDR и HIPAA для eligible customers и региональную обработку в США и Европе. Для data residency действуют организационные требования OpenAI, а доступность конкретной комбинации endpoint, модели и региона следует проверять перед production-запуском.
Для image input есть ещё одно текущее ограничение: Decisions принимает изображения inline как base64 data URL; hosted HTTP/HTTPS image URLs и file_id для этого endpoint не поддерживаются.
То есть архитектуру хранения изображений и требования compliance лучше определять до интеграции, а не после того, как endpoint уже встроен в пользовательский workflow.
Что проверять перед production-запуском
Минимальный полезный eval должен состоять не из десяти удобных примеров, а из реального распределения входов.
В нём особенно нужны пограничные случаи:
- запрос одновременно про оплату и техническую ошибку;
- очень короткий текст без контекста;
- длинное обращение с несколькими проблемами;
- запрос, который не относится ни к одному классу;
- формулировки, которых не было в первоначальной выборке;
- примеры классов, для которых ошибка обходится особенно дорого.
После этого сравнивается не только общая accuracy. Для production-routing полезнее увидеть ошибки по отдельным маршрутам и понять, где автоматизация безопасна, а где нужен человек.
Нужно также хранить версию классификационной схемы. Если завтра sales разделится на new_business и account_expansion, старые результаты уже нельзя напрямую сравнивать с новыми.
Та же дисциплина пригодится при обновлении API и моделей. Планируя жизненный цикл интеграции, имеет смысл заранее учитывать миграцию OpenAI API при deprecation моделей, а не связывать критичную бизнес-логику с единственной неизменяемой реализацией.
Decisions API — слой решения, а не вся система
На практике сильная интеграция состоит из нескольких разных по ответственности частей:
input
  ↓
deterministic checks
  ↓
Decisions API
  ↓
policy / threshold
  ├─ automatic route
  ├─ fallback
  └─ human review
  ↓
logging + ground truth + eval
Такой контур не требует считать модель «правой». От неё требуется более узкая задача: выдать типизированный сигнал в заранее заданной форме.
predicate, choice и score дают для этого три разных инструмента. probability, распределение по вариантам и confidence помогают принимать дальнейшее решение, но сами не заменяют критерии качества. А thresholds становятся осмысленными только после проверки на размеченных данных приложения.
Именно в такой роли Decisions API наиболее интересен: не как ещё один способ поговорить с моделью, а как компактный decision-layer между неструктурированным входом и обычной программной логикой.
Практика
Как настроить маршрутизацию обращений через OpenAI Decisions API
Зафиксировать допустимые маршруты
Определите конечные категории, например billing, technical, sales и other, и дайте каждой непересекающееся описание.
Собрать ground truth
Возьмите реальные обращения и вручную разметьте правильный маршрут. Сохраните спорные случаи отдельно, чтобы они не искажали оценку.
Создать choice-запрос
Передайте текст обращения в POST /v1/decisions, задайте gpt-6-luna и перечислите разрешённые категории в questions.
Оценить качество на размеченной выборке
Сравните фактический choice с ground truth и отдельно посчитайте ошибки для каждой категории.
Настроить порог и fallback
Выберите порог автоматической маршрутизации исходя из стоимости ошибок. Низкоуверенные ответы, other и отказ модели отправляйте в безопасную очередь.
Включить логирование и повторные evals
Сохраняйте вход, решение, итоговый маршрут и последующую корректировку оператором, чтобы пересматривать пороги при изменении реального потока данных.
FAQ
Что важно проверить перед использованием Decisions API
Decisions API предназначен для ограниченного набора типизированных решений: проверки условия, выбора из заданных категорий и оценки по упорядоченной шкале. Responses API нужен, когда требуется генерация текста, собственная JSON-схема, объяснение результата или вызов инструмента.
Нет. Это модельный сигнал уверенности, который нужно проверять на собственной размеченной выборке. Порог автоматического действия выбирают с учётом реальной цены ложноположительных и ложноотрицательных решений.
Когда нужный признак уже формализован и однозначно доступен приложению: ID тарифа, код ошибки, тип формы, домен email или конкретное значение поля. В таких случаях обычное условие дешевле, предсказуемее и проще для аудита.
Заранее добавить fallback-категорию вроде other и определить политику обработки: общая очередь, дополнительная проверка или передача человеку. Это безопаснее, чем заставлять модель выбирать ближайший, но неверный маршрут.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.