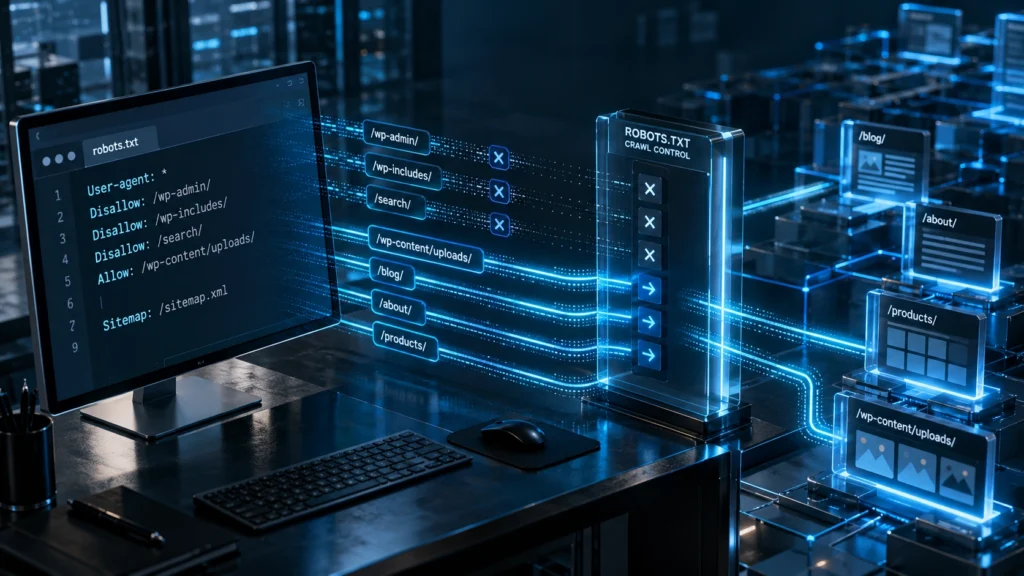
Crawl delay описывает ограничение частоты обращений робота к сайту. На практике под этим названием часто смешивают три разные вещи: директиву Crawl-delay в robots.txt, автоматическое регулирование частоты обхода поисковой системой и общий crawl budget сайта.
Разница принципиальна. Можно добавить строку Crawl-delay: 5 и не получить вообще никакого эффекта для нужного поисковика. Например, Google такую директиву не обрабатывает, а основной поисковый робот Яндекса перестал учитывать её ещё в 2018 году.
Поэтому задача SEO-специалиста — не подобрать «правильное число секунд», а сначала выяснить, кто именно обращается к сайту слишком часто и существует ли проблема вообще.
Что именно ограничивает Crawl delay
Идея проста: робот не должен отправлять новые запросы быстрее определённого темпа. Это может быть полезно на сервере с ограниченными ресурсами, при тяжёлой генерации страниц или во время необычно интенсивного обхода.
У поддерживающего директиву робота запись может выглядеть так:
User-agent: Bingbot
Crawl-delay: 5
Для Bing такое правило действительно имеет смысл: Bingbot поддерживает Crawl-delay. Но копировать эту запись для всех роботов через User-agent: * без проверки — плохая практика.
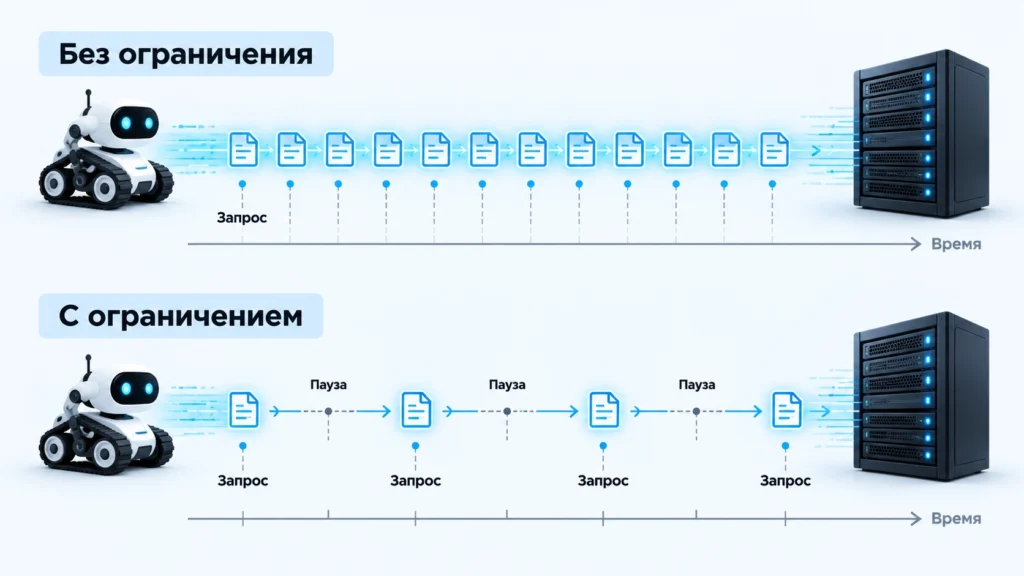
При этом Crawl delay не сообщает поисковой системе, какие страницы важнее. Он только воздействует на интенсивность обхода там, где робот вообще поддерживает такой механизм.
Это отличает его от оптимизации структуры сайта, удаления бесконечных комбинаций параметров, исправления цепочек редиректов или закрытия ненужных URL от обхода. Такие действия уменьшают количество бесполезной работы робота, а не просто заставляют его выполнять эту работу медленнее.
Почему Crawl delay не является универсальной SEO-настройкой
Поддержка различается даже между крупнейшими поисковыми системами.
| Система | Crawl-delay в robots.txt | Как управляется обход |
|---|---|---|
| Не поддерживается | Googlebot автоматически регулирует интенсивность с учётом состояния сервера и потребности в обходе | |
| Яндекс Поиск | Не учитывается с 22.02.2018 | Настройка скорости обхода в Яндекс Вебмастере |
| Bing | Поддерживается | Crawl-delay или Crawl Control в Bing Webmaster Tools |
Для Google отдельный инструмент ручного ограничения скорости обхода в Search Console также больше не является текущим способом настройки: старый Crawl Rate Limiter был отключён в январе 2024 года.
Googlebot сам реагирует на состояние сервера. Если ответы становятся заметно медленнее или сервер начинает стабильно возвращать ошибки, интенсивность обхода может снизиться.
У Яндекса логика похожа в том смысле, что поисковый робот по умолчанию самостоятельно подбирает скорость. Если её требуется изменить, это делается через Яндекс Вебмастер, а не через старую директиву в robots.txt.
Из этого следует практическое правило: прежде чем редактировать robots.txt, выясните, для какого робота предназначена настройка.
Как Crawl delay связан с обходом, индексированием и SEO
Сам по себе высокий crawl rate не является фактором ранжирования, а более частый обход не означает автоматического роста позиций.
Связь с SEO косвенная.
Если поисковый робот слишком сильно ограничен, новые и изменённые страницы потенциально могут обнаруживаться медленнее. Для большого интернет-магазина, агрегатора или новостного проекта это заметнее, чем для корпоративного сайта с несколькими десятками редко изменяемых страниц.
Обратная ситуация тоже вредна: если интенсивный краулинг перегружает сервер, увеличивает время ответа или приводит к ошибкам, робот физически получает страницы хуже.
Поэтому нормальная цель — не максимальная и не минимальная скорость обхода. Нужна такая интенсивность, при которой важные страницы регулярно доступны роботам, а сервер работает стабильно.
Для большинства небольших сайтов отдельная работа с crawl budget вообще не является первоочередной задачей. Сначала полезнее исправить технические дубли, ошибки сервера, ненужные URL и проблемы с доступностью страниц.
Как проверить реальную скорость обхода сайта
Начинать нужно не с robots.txt, а с фактических запросов.
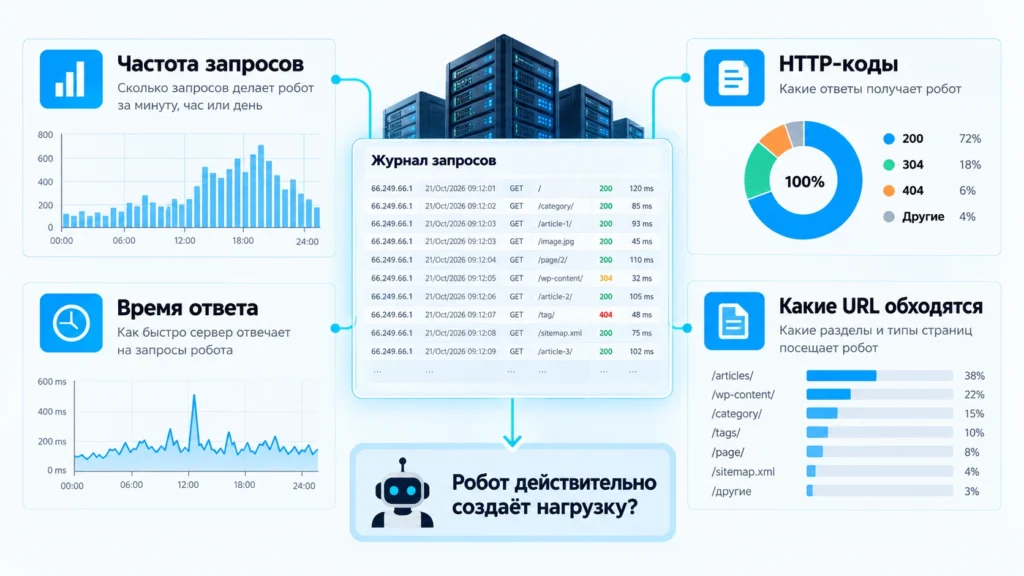
Самый точный источник — access-логи веб-сервера. Они показывают, какой робот обращался к сайту, какие URL запрашивал, когда это происходило и какой HTTP-код получил.
Для Nginx первичную выборку можно сделать, например, так:
grep -iE 'Googlebot|YandexBot|bingbot' /var/log/nginx/access.log | tail -n 200User-Agent сам по себе нельзя считать абсолютным доказательством личности робота: его способен подставить сторонний бот. Но для первичной диагностики лог показывает главное — частоту запросов и совпадение активности с моментами высокой нагрузки.
Дальше полезно сопоставить четыре показателя:
| Что смотреть | Что ищем |
|---|---|
| Запросы робота | резкие всплески или длительную высокую частоту |
| HTTP-коды | рост 429, 5xx, таймаутов |
| Время ответа | ухудшение одновременно с ростом обхода |
| Тип URL | обход полезных страниц или тысяч дублей и параметров |
В Google Search Console для этого есть статистика сканирования: она помогает увидеть число запросов Googlebot, состояние хоста и динамику времени ответа. В Яндекс Вебмастере можно использовать статистику обхода и отдельную настройку его скорости.
Что делать, если робот действительно перегружает сервер
Способ зависит от источника нагрузки.
Для Google добавление Crawl-delay бесполезно. При кратковременной реальной перегрузке сервер может отвечать кодом 429 Too Many Requests или временным 503 Service Unavailable. Использовать такой подход постоянно нельзя: продолжительная недоступность уже мешает нормальному обходу и обработке страниц.
До ограничений стоит проверить более фундаментальные причины: медленные SQL-запросы, отсутствие кеширования, тяжёлую генерацию страниц, неконтролируемые URL с параметрами и технические разделы, на которые робот зря расходует запросы.
Для Яндекса скорость основного поискового робота следует регулировать через Вебмастер. При этом заданное значение является рекомендацией: фактическая интенсивность может отличаться.
Для Bing Crawl-delay поддерживается, но слишком большое значение способно заметно сократить объём обхода. Поэтому задержку имеет смысл использовать только при доказанной необходимости и затем проверять, продолжают ли важные страницы нормально переобходиться.
Частые ошибки при настройке
Добавлять Crawl-delay для Googlebot. Google прямо относит это поле к неподдерживаемым, поэтому строка создаёт лишь иллюзию настройки.
Использовать старые рекомендации для Яндекса. В интернете до сих пор встречаются инструкции с Crawl-delay для YandexBot, хотя основной поисковый робот давно перешёл на управление скоростью через Вебмастер.
Ставить большое значение «на всякий случай». Если поддерживающий директиву робот делает слишком мало запросов, обновления сайта будут обнаруживаться медленнее.
Лечить задержкой бесконечные URL. Фильтры, параметры, внутренний поиск и другие генераторы дублей лучше исправлять на уровне архитектуры и правил обхода.
Ограничивать робота до анализа логов. Сервер может нагружать не поисковик, а сторонний парсер, вредоносный бот, плагин WordPress, резервное копирование или собственная фоновая задача.
Практический сценарий: робот создаёт нагрузку на WordPress
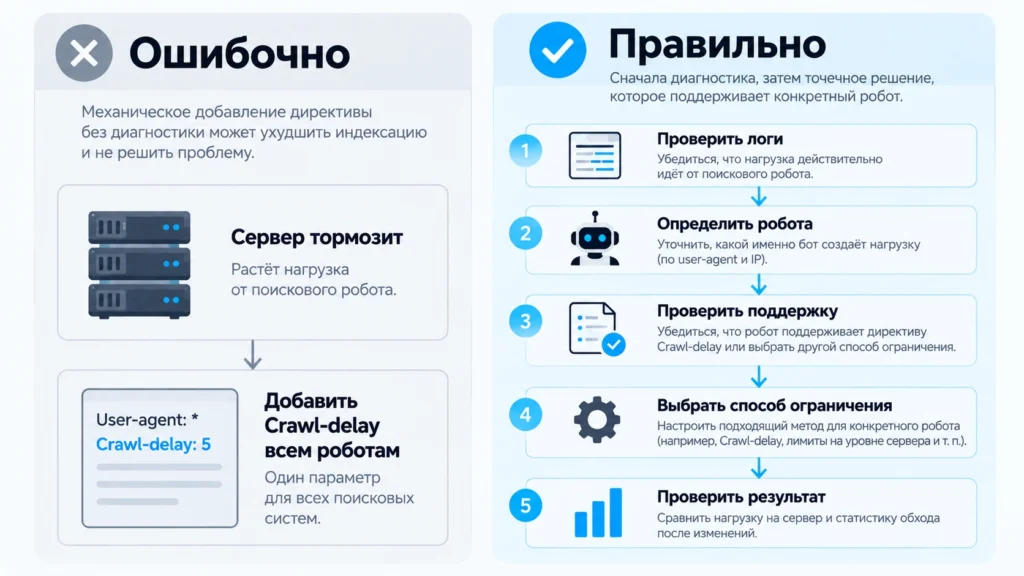
Представим сайт, где в определённые часы резко растёт CPU, а страницы начинают отвечать медленнее. В robots.txt при этом уже много лет стоит:
User-agent: *
Crawl-delay: 10
Считать проблему решённой нельзя.
Сначала в access-логах проверяем, совпадает ли рост нагрузки с активностью поисковых роботов. Допустим, основная масса запросов принадлежит Googlebot. Тогда существующий Crawl-delay к проблеме отношения не имеет — Google его игнорирует.
Следующий вопрос: какие страницы запрашиваются. Если робот получает тысячи комбинаций фильтров или параметров, правильнее устранить источник лишних URL. Если обходятся нормальные страницы, но даже несколько одновременных запросов перегружают WordPress, искать причину нужно в производительности самого сайта: кеше, PHP, базе данных и серверных ресурсах.
После исправления сравниваем те же показатели: время ответа, ошибки, нагрузку и статистику обхода. Только такое сравнение позволяет сказать, что проблема устранена.
First Input Delay: похожее название, другой показатель
First Input Delay, или FID, не связан с паузой между запросами поискового робота. Это была пользовательская метрика отзывчивости страницы: она измеряла задержку между первым взаимодействием посетителя и моментом, когда браузер мог начать его обрабатывать.
С 12 марта 2024 года FID больше не используется как Core Web Vital — его заменил Interaction to Next Paint, или INP.
Поэтому наличие слов delay и в Crawl delay, и в First Input Delay не означает технической связи. Первый термин относится к краулингу, второй относился к пользовательской производительности страницы.
Что делать на практике
Если в robots.txt найден Crawl-delay, сначала определите, для какого робота он записан и поддерживает ли тот его сейчас. Для Google и поискового робота Яндекса наличие такой строки не решает задачу управления скоростью обхода.
Если проблема действительно связана с краулингом, работайте от фактов: логи сервера → конкретный робот → характер запросов → состояние сервера → поддерживаемый механизм управления.
Главный критерий результата прост: сервер остаётся доступным и быстрым, важные URL продолжают регулярно обходиться, а технические дубли не расходуют ресурсы без необходимости.
FAQ
Когда Crawl-delay действительно нужен, а когда мешает
Это способ ограничить интенсивность запросов робота к сайту. В robots.txt директива обычно задаёт паузу или ограничение между обращениями поддерживающего её краулера. Однако правила зависят от конкретного робота: единой настройки для всех поисковых систем нет.
Само увеличение или уменьшение скорости обхода не является гарантией роста позиций. Косвенная проблема возникает, если чрезмерное ограничение мешает поисковику своевременно находить новые или обновлённые страницы. Поэтому оценивать нужно не значение директивы само по себе, а фактический обход и доступность важных URL.
Нет. Google прямо указывает, что crawl-delay относится к неподдерживаемым полям robots.txt. Скорость Googlebot регулируется автоматически с учётом состояния сервера и потребности в обходе.
Поисковый робот Яндекса перестал учитывать эту директиву 22 февраля 2018 года. Для управления скоростью обхода используется соответствующая настройка в Яндекс Вебмастере. У отдельных роботов других сервисов Яндекса правила могут отличаться, поэтому важно не переносить настройки одного робота на другой.
Сначала определите робота по логам и посмотрите частоту запросов, HTTP-ответы и время ответа сервера. Затем используйте способ управления, который официально поддерживает именно этот робот. После изменения снова сравните нагрузку и интенсивность обхода.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.