На сайте удалили старую статью.
Сам URL больше не нужен.
Но через полгода оказывается, что на него продолжают вести:
меню;
другая статья;
карточка товара;
старый баннер;
Sitemap;
внешняя ссылка.
Владелец открывает отчёт SEO-аудита и видит:
Найдено 380 ошибок 404.
Первая реакция:
Нужно срочно убрать все 404.
Но это неправильная постановка задачи.
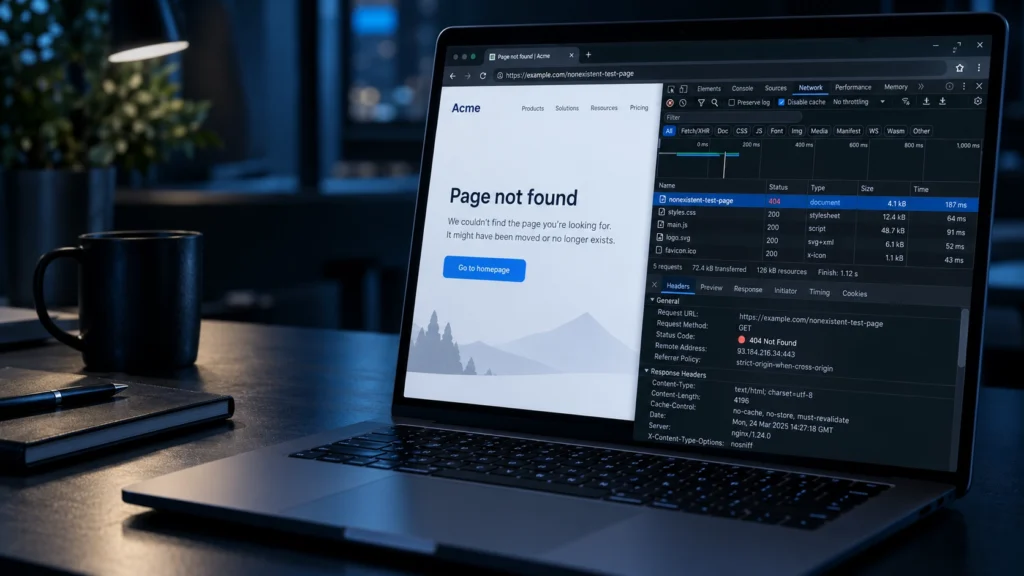
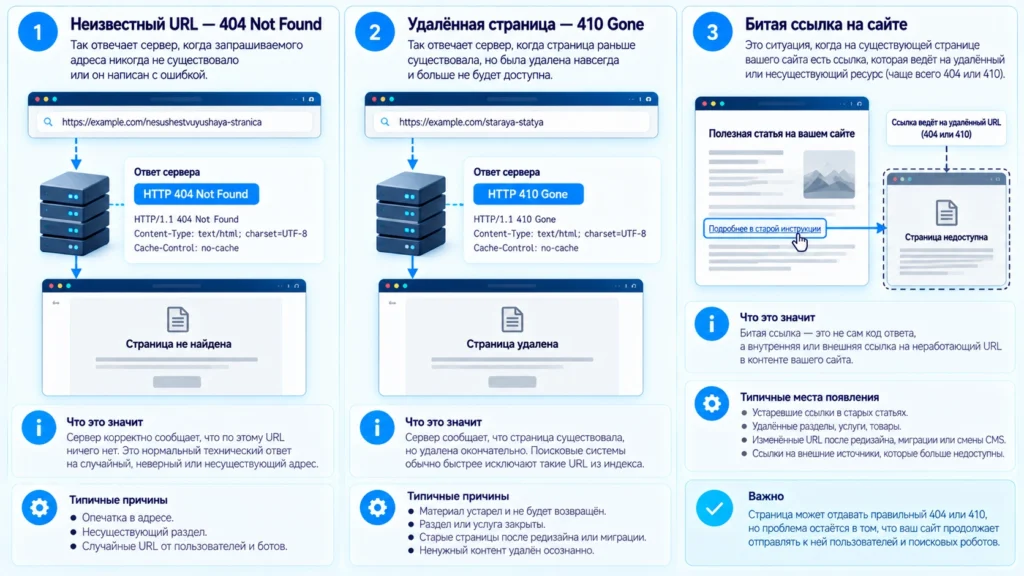
Удалённая страница и битая ссылка — не одно и то же.
Если страницы больше нет, сервер должен честно сообщить об этом поисковику.
Проблема начинается тогда, когда существующая часть сайта продолжает считать этот адрес рабочим.
Что такое битая ссылка
Допустим, существует статья:
/kak-vybrat-hosting/
В ней написано:
Подробнее о старых тарифах смотрите здесь.
Слово «здесь» ведёт на:
/hosting-tarify-2022/
А такой страницы больше нет.
Вот ссылка из первой статьи — битая.
Сам удалённый URL при этом вполне может работать технически правильно, отвечая:
404 Not Found
или:
410 Gone.
Именно поэтому задача аудита состоит не в том, чтобы уничтожить все коды 404.
Задача:
убрать неправильные маршруты к несуществующим ресурсам.
Какие ситуации считать проблемой
| Ситуация | Что происходит | Что делать |
|---|---|---|
| Ссылка ведёт на 404 | страницы нет | исправить или удалить ссылку |
| Ссылка ведёт на 410 | документ удалён навсегда | убрать ссылку на него |
| Ссылка ведёт на 500/502 | серверная ошибка | исправлять сервер |
| Ссылка ведёт через 301 | ресурс переехал | внутренний href лучше обновить на финальный URL |
| Несколько 301 подряд | цепочка редиректов | сократить маршрут |
| Страница показывает ошибку, но отвечает 200 | soft 404 | исправить HTTP-статус |
| Не загружается изображение | битый ресурс | восстановить или заменить файл |
#faq ведёт на отсутствующий ID | битый HTML-якорь | исправить anchor |
| Не существует домена назначения | внешняя битая ссылка | заменить источник |
Яндекс считает ссылку неработающей, если при переходе робот получает ошибку; Вебмастер отдельно показывает внутренние, внешние и исходящие проблемные ссылки с кодами 4xx и 5xx.
Почему появляются битые ссылки
Самая частая причина — сайт меняется.
Статьи удаляются.
URL переименовываются.
Товары исчезают.
Категории объединяются.
Меняется домен.
Происходит миграция.
Редактор вставляет URL с опечаткой.
А внешние сайты вообще живут своей жизнью: сегодня исследование доступно, через год его удалили.
Поэтому битые ссылки — это не обязательно признак плохого сайта.
Плохой сайт — тот, где их никто не контролирует.
Вредят ли битые ссылки SEO
Здесь важно не повторять старый миф:
Каждый 404 снижает позиции сайта.
Google так не говорит.
Корректный URL с 404 или 410, если ресурс действительно удалён, является нормальным техническим сигналом.
Google рекомендует возвращать именно 404 или 410, когда контент больше недоступен и подходящей новой страницы нет.
Проблема битой ссылки в другом.
Пользователь приходит в тупик
Особенно неприятно, если не работает:
Посмотреть цены;
Оформить заказ;
Скачать инструкцию;
Перейти к услуге.
Это уже непосредственная потеря пользовательского сценария.
Робот получает неправильную архитектуру
Google использует ссылки для обнаружения страниц и понимания связей между ними.
Яндекс тоже строит обход на переходах по ссылкам.
Если сайт продолжает вести робота к удалённому адресу, в архитектуре остаётся технический мусор.
Удалённый URL может продолжать появляться в Sitemap
Это уже прямое противоречие:
Sitemap сообщает:
этот URL важен и его стоит обходить,
а сервер отвечает:
такого документа больше нет.
Поэтому после удаления страниц важно не только вернуть корректный
404или410, но и убрать удалённые URL из Sitemap. Подробно о том, как правильно настроить Sitemap и убрать из него удалённые URL, я разобрал отдельно.
404 или 410: что я рекомендую для удалённых страниц
Здесь стоит разделять две ситуации.
URL просто не существует
Например, пользователь открыл:
/fdgdfgdfg/
Такого документа никогда не было.
Обычный:
404 Not Found
идеально описывает ситуацию.
Страница существовала, но сознательно удалена навсегда
Например:
старый тариф;
устаревшая акция;
удалённый товар без аналога;
материал, который решено полностью убрать.
Если мы точно знаем, что URL существовал и никогда больше не должен возвращаться, я предпочитаю:
410 Gone.
Почему?
Потому что 410 семантически говорит серверному клиенту точнее:
ресурс существовал, но удалён окончательно.
404 лишь сообщает:
сейчас ресурс не найден.
Это хорошая техническая дисциплина.
Но здесь важно не приписывать 410 магических SEO-свойств.
Google прямо группирует 404 и 410 вместе: оба статуса означают отсутствие содержимого. Для обнаруженного 404 частота сканирования постепенно снижается, а в рекомендациях по crawl budget Google предлагает возвращать 404 или 410 для окончательно удалённых страниц.
Поэтому формулировка:
410 гарантированно перестаёт обходиться Google быстрее, чем 404
не подтверждается актуальной документацией.
Тогда зачем 410
Потому что это более точный статус для известного окончательного удаления.
А реальная оптимизация обхода выглядит так:
удалили страницу → вернули 410 → убрали все внутренние ссылки → удалили из Sitemap → прекратили генерацию URL.
Вот эта последовательность уже очищает архитектуру.
Как это связано с crawl budget
Здесь тоже важно убрать крайность.
Google прямо пишет, что URL с обычными 4xx, кроме 429, не считаются растратой crawl budget сами по себе.
При этом Google отдельно рекомендует для окончательно удалённых страниц отдавать 404 или 410, устранять soft 404 и поддерживать Sitemap в актуальном состоянии.
То есть неверно говорить:
каждый 404 съедает краулинговый бюджет.
Но совершенно правильно бороться с ситуацией, когда сайт снова и снова сам предлагает роботу тысячи ненужных URL.
Например:
- фильтры создают миллионы адресов;
- старые ссылки остаются в шаблоне;
- Sitemap содержит удалённые страницы;
- параметры генерируют дубли;
- soft 404 продолжают отдавать
200.
Вот это уже архитектурная проблема.
Подробнее о том, как робот Яндекса обходит сайт и что влияет на краулинг, разобрано в отдельном материале.
Яндекс также прямо пишет, что обход ненужных страниц создаёт дополнительную нагрузку и может замедлять обнаружение целевых документов.
Почему soft 404 хуже обычного 404
Представим страницу:
/old-product/
На экране:
Товар не найден.
Но сервер отвечает:
HTTP 200 OK.
Для пользователя товар отсутствует.
Для сервера документ существует.
Это soft 404.
Google отдельно рекомендует устранять такие страницы, потому что они продолжают сканироваться и могут расходовать ресурсы обхода.
Поэтому честный:
410 Gone
для действительно навсегда удалённого URL значительно лучше, чем:
200 OK + "страница удалена".
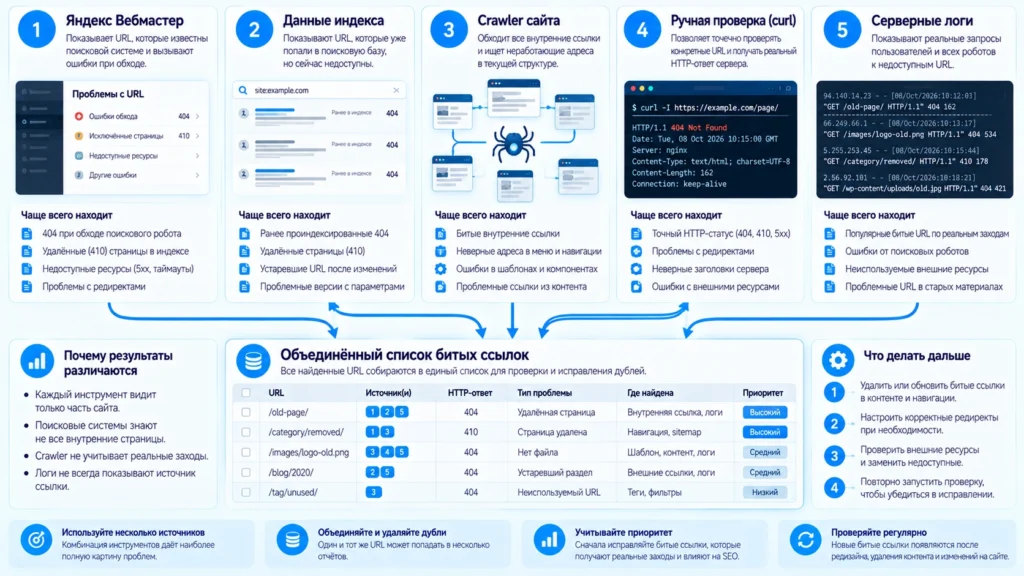
Способ 1. Яндекс Вебмастер
Для российского сайта я бы начинал именно отсюда.
В Вебмастере есть отдельный инструмент «Неработающие ссылки».
Он показывает:
- внутренние проблемные ссылки;
- внешние ссылки на несуществующие страницы вашего сайта;
- переходы пользователей по таким ссылкам.
Для внутренней ссылки доступны:
страница-источник;
URL назначения;
HTTP-статус;
анкор;
дата проверки.
Для одного сайта Яндекс может показать до 10 000 внутренних неработающих ссылок.
Кроме того, Яндекс отдельно показывает реальные переходы пользователей на несуществующие URL по обезличенным данным Яндекс Браузера. Это особенно полезно для приоритизации: можно увидеть не просто техническую ошибку, а маршрут, которым действительно пользуются люди.
Ограничение
Вебмастер не является полным crawler сайта.
Сам Яндекс предупреждает, что данные строятся только по страницам, известным его роботу, поэтому часть ссылок может отсутствовать.
Способ 2. Google Search Console
Search Console полезен, чтобы увидеть URL, которые Google уже обнаружил как:
Not found (404);
soft 404;
ошибки сервера;
проблемы индексирования.
Но это не полный инструмент поиска всех внутренних ссылок.
Он отвечает скорее:
какие проблемные URL известны Google?
а не:
откуда каждая страница моего сайта ссылается на этот URL?
Для второй задачи нужен crawler.
Способ 3. Screaming Frog
Screaming Frog — один из наиболее удобных вариантов полного технического обхода.
Бесплатная версия позволяет сканировать до:
500 URL.
Полная лицензия:
£199 в год на одного пользователя.
Главное преимущество для нашей задачи — crawler показывает не только:
/old-page/возвращает 404,
а и:
какая страница на него ссылается.
Например:
| Source | Anchor | Destination | Status |
|---|---|---|---|
/hosting/ | старые тарифы | /old-prices/ | 410 |
/blog/article/ | инструкция | /manual.pdf | 404 |
После этого проблему можно реально исправить.
Способ 4. Netpeak Spider
Альтернативный desktop crawler.
На дату проверки:
$20 в месяц;
$193 в год;
пожизненная лицензия — $496.
Подходит для:
- status codes;
- ссылок;
- редиректов;
- canonical;
- индексации;
- массовых технических ошибок.
Если задача только проверить небольшой сайт один раз, покупать оба crawler одновременно смысла нет.
Способ 5. Ahrefs Webmaster Tools
Для подтверждённого собственного сайта есть бесплатный вариант.
Ahrefs Free предоставляет Site Audit с лимитом:
5 000 crawl credits в месяц на каждый подтверждённый проект.
Это хороший вариант для небольшого или среднего сайта, если не хочется сразу ставить desktop crawler.
Важно только понимать:
любая сторонняя облачная система проводит собственный обход, то есть снова создаёт HTTP-запросы к вашему серверу.
Способ 6. Расширение браузера
Для одной страницы crawler часто вообще не нужен.
Например, вы только что обновили большую статью и хотите проверить двадцать ссылок.
Расширение браузера типа broken-link checker может пройти по всем ссылкам текущей страницы и подсветить проблемные.
Это удобно для редактора.
Но для сайта на тысячи страниц подход не масштабируется.
Способ 7. Проверка через curl
curl особенно полезен тогда, когда уже известен конкретный проблемный URL и нужно понять, что реально отвечает сервер.
Самая простая команда:
curl -I https://example.com/old-page/Для намеренно удалённой страницы я ожидаю:
HTTP/2 410или для обычного неизвестного URL:
HTTP/2 404Но curl -I выполняет HEAD-запрос, а некоторые сайты обрабатывают HEAD иначе.
Поэтому для более практичной проверки GET с переходом по редиректам:
curl -sS -L \
  -o /dev/null \
  -w '%{http_code}\n' \
  https://example.com/page/
Если нужно проверить редирект отдельно, не надо смотреть только финальный ответ.
Например:
301 → 301 → 404финально даст ошибку, хотя начало маршрута выглядело корректным.
Массовая проверка через curl
Иногда есть готовый список старых URL после миграции.
Тогда достаточно обычного файла:
https://example.com/old-1/
https://example.com/old-2/
https://example.com/old-3/
И безопасного последовательного цикла:
while IFS= read -r url; do
    code=$(curl -sS -L \
      --max-time 15 \
      -o /dev/null \
      -w '%{http_code}' \
      "$url")

    printf '%s %s\n' "$code" "$url"
    sleep 0.5
done < urls.txt
Да, это медленнее большого crawler.
Зато вы точно контролируете нагрузку.
Способ 8. Серверные access-логи
Crawler отвечает:
какие неправильные маршруты существуют на сайте?
Логи отвечают:
какими неправильными URL реально пользуются роботы и посетители?
Это принципиально другой источник.
Допустим, crawler нашёл:
380 удалённых URL.
В логах видно:
/old-service/ — 8 500 запросов;
/product-2019/ — 700;
/dfhgkjh234/ — 1.
Все три адреса технически отсутствуют.
Но бизнес-приоритет очевидно разный.
Для крупного сайта я всегда смотрел бы:
crawler + access.log,
а не только один SEO-отчёт.
Почему инструменты находят разное количество ошибок
Это нормально.
Яндекс видит те страницы и ссылки, которые обнаружил его робот.
Google знает собственный набор URL.
Crawler начинает с заданной точки и проходит по доступной структуре сайта сейчас.
Ahrefs использует собственного робота.
Логи содержат адреса, которые действительно кто-то запросил.
Поэтому отчёты:
Яндекс — 78 ошибок;
Screaming Frog — 143;
access.log — 2 400 уникальных 404;
могут одновременно быть правильными.
Вопрос не:
какой сервис врёт?
А:
откуда каждый получил свои данные?
Может ли crawler положить сайт
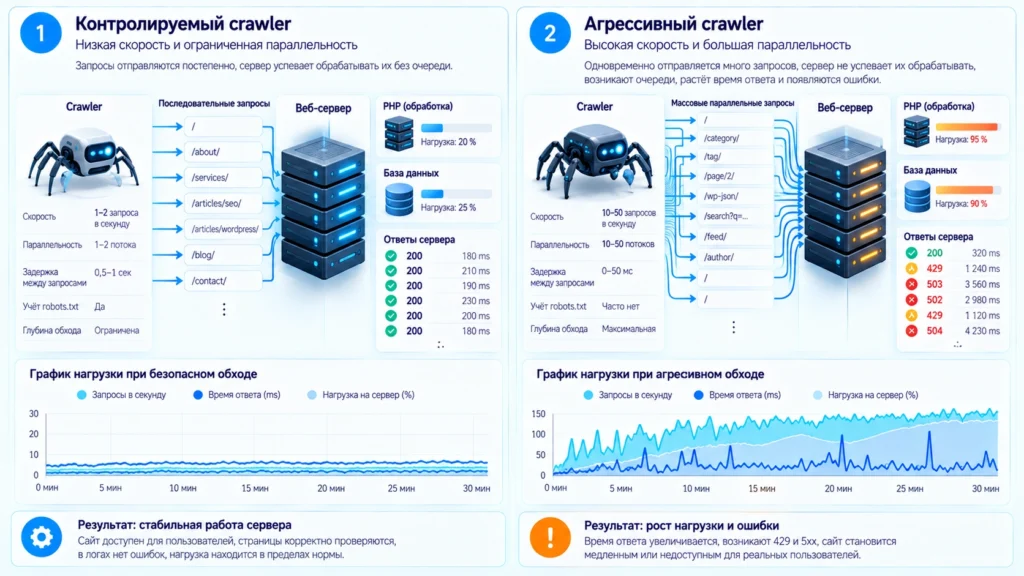
Да.
И это один из наиболее недооценённых рисков технического SEO-аудита.
Crawler — автоматический клиент.
Если он отправляет:
1 запрос в секунду,
нагрузка обычно небольшая.
Если:
100 запросов одновременно,
это уже совершенно другая история.
Screaming Frog позволяет управлять как количеством параллельных потоков, так и максимальным числом URL в секунду. По умолчанию используется пять потоков, а разработчики прямо предупреждают, что слишком высокая скорость способна ухудшить response time и в крайнем случае перегрузить сервер.
Почему WordPress особенно чувствителен
Каждый HTTP-запрос может запустить:
- nginx;
- PHP-FPM;
- WordPress bootstrap;
- плагины;
- SQL-запросы;
- шаблон;
- WooCommerce;
- динамические блоки.
Поэтому:
crawler просто скачивает HTML
не означает:
серверу почти ничего не нужно делать.
На слабом VPS агрессивный обход вполне способен создать нагрузку, которой не бывает от обычных пользователей.
Как безопасно запускать crawler
Я не использовал бы универсальное правило:
всегда ставьте 10 потоков.
Сервера разные.
Нормальная стратегия:
начать медленно → посмотреть нагрузку → увеличивать при необходимости.
Если технических данных о сервере нет, разумным стартом будет примерно:
1 URL в секунду.
Screaming Frog сам использует 1 URL/s как пример ограничения скорости.
Во время обхода стоит контролировать:
- response time;
- CPU;
- RAM;
- PHP-FPM;
- MySQL;
429;5xx.
Если после запуска crawler резко выросли 502 или 504, аудит уже сам создаёт техническую проблему.
Как Google регулирует собственный обход
Googlebot ведёт себя не так примитивно, как локальный crawler.
Google учитывает здоровье сервера.
Если растёт latency или сайт начинает массово отвечать 5xx и 429, Google автоматически снижает crawl capacity.
Ваш Screaming Frog ничего об этом не знает, если вы сами не ограничили скорость.
Поэтому аргумент:
Googlebot же обходит сайт, значит можно поставить 100 threads
не работает.
curl тоже способен перегрузить сервер
Сам по себе:
curl URL— один запрос.
Но если запустить сотни curl параллельно, результат будет таким же, как у агрессивного crawler.
Нагрузку определяет не название программы.
Её определяют:
частота запросов × параллельность × сложность обработки страницы.
Что делать, когда битая ссылка найдена
Самая важная часть всей работы — выбрать правильное действие.
| Ситуация | Что делать |
|---|---|
| Опечатка в href | исправить URL |
| Страница переехала | ссылка сразу на новый URL + постоянный редирект со старого |
| Страница удалена навсегда без аналога | удалить ссылку, убрать из Sitemap, вернуть 410 Gone |
| URL никогда не существовал | обычный 404 |
| Есть реальный новый аналог | постоянный 301/308 |
| Умерла внешняя ссылка | найти новый источник либо удалить ссылку |
| 500/502/503 | ремонтировать сервер |
| Soft 404 | вернуть корректный 404/410 либо нормальный контент |
| Ссылка ведёт через редирект | заменить href на конечный 200 |
Сломан #anchor | исправить ID или ссылку |
Почему я ставлю 410 для сознательно удалённых страниц
Не ради мифа:
Google моментально забудет страницу.
А ради корректной архитектуры.
Если система знает:
эта страница существовала, сознательно удалена и никогда не вернётся,
то 410 Gone точнее описывает реальность.
А затем мы убираем причины повторного обнаружения:
нет внутренних ссылок;
нет Sitemap;
нет генерации URL;
нет старого меню;
нет ссылок из шаблона.
Вот после этого удалённый URL постепенно перестаёт быть важной частью обхода.
Отдельно рекомендую посмотреть, как правильно настроить 404, 410 и редиректы для удалённых страниц — там разобрано, когда оставлять ошибку, когда использовать 410 Gone, а когда действительно нужен постоянный редирект.
В нём отдельно разобрано, что 410 предназначен именно для заведомо постоянного удаления.
Почему нельзя просто поставить 301 на главную
Представим удалённую статью:
/iphone-7-review/
Её отправляют:
301 → /
Но главная вообще не является заменой обзора iPhone 7.
Получается технически работающий, но бессмысленный переход.
Если релевантной замены нет, честный:
410 Gone
логичнее.
Если замена есть:
/iphone-reviews/iphone-7/
тогда постоянный редирект оправдан.
Это намного лучше схемы:
всё старое → главная.
Нужно ли после 410 закрывать URL в robots.txt
Не сразу.
Поисковому роботу сначала нужно увидеть сам HTTP-статус.
Для Google блокировка URL в robots.txt до получения ответа может, наоборот, оставить адрес в crawl queue дольше: Google прямо предупреждает, что заблокированные URL могут сохраняться в очереди обхода дольше, чем адреса, отдающие 404/410.
Поэтому базовая схема:
1. Отдать 410.
2. Удалить внутренние ссылки.
3. Убрать URL из Sitemap.
4. Дать поисковику увидеть состояние.
Для огромных технических пространств URL подход к robots.txt уже решается отдельно на уровне архитектуры сайта.
Как часто проверять битые ссылки
Зависит не от универсального SEO-правила, а от того, как часто сайт меняется.
| Сайт | Практичный режим |
|---|---|
| Небольшой сайт услуг | раз в месяц и после изменений |
| Корпоративный сайт | раз в месяц |
| Активный блог | раз в 1–2 недели |
| Интернет-магазин | еженедельно |
| Большой каталог | автоматический регулярный контроль |
| После миграции | сразу после запуска и повторно после переобхода |
| После смены URL | сразу |
| После массового импорта | сразу |
На статичном сайте из 30 страниц еженедельный crawl мало что даст.
На магазине, где ежедневно исчезают товары и меняются категории, месяц между проверками — слишком долго.
Практический пример: crawler нашёл 380 удалённых URL
Самая большая ошибка:
Нужно исправить все 380 одинаково.
Нет.
Разбиваем их по причине.
40 URL имеют внутренние входящие ссылки
Высокий приоритет.
Исправляем источники ссылок.
15 старых страниц имеют полноценные новые аналоги
Настраиваем:
301/308 → релевантный новый URL
и обновляем внутренние ссылки сразу на конечные страницы.
110 страниц сознательно удалены без замены
Убираем их:
из Sitemap;
из внутренних ссылок;
из шаблонов.
И возвращаем:
410 Gone.
180 случайных URL никогда не существовали
Пусть отвечают обычным:
404.
Никакой отдельной работы не требуется, если сайт сам на них не ссылается.
20 URL отвечают 200, хотя контента нет
Вот это настоящий технический приоритет.
Исправляем soft 404.
15 URL возвращают 5xx
Это вообще другая категория.
Их нельзя объявлять «битыми страницами и удалить».
Нужно искать серверную проблему.
Какой результат считать правильным
Не:
В отчёте больше нет ни одного 404.
Это практически бессмысленная цель.
Правильный результат:
внутренние рабочие страницы не ведут на удалённые URL;
Sitemap содержит только актуальные документы;
переехавшие страницы имеют прямой постоянный редирект на реальный аналог;
сознательно навсегда удалённые страницы отвечают 410;
случайные несуществующие URL корректно отвечают 404;
soft 404 отсутствуют;
5xx не маскируются под удаление;
crawler при повторной проверке не находит неправильных маршрутов.
Финальный вывод
Битые ссылки нельзя лечить правилом:
нашёл 404 — поставил 301.
И нельзя оценивать техническое здоровье сайта количеством страниц 404.
404 — это статус ресурса.
Битая ссылка — это неправильный маршрут к этому ресурсу.
Если URL никогда не существовал или просто запрошен с ошибкой, 404 Not Found абсолютно нормален.
Если существовавшая страница сознательно удалена навсегда и не имеет подходящей замены, я предпочитаю переводить её на:
410 Gone.
Это точнее сообщает состояние документа.
Но ключевой эффект для краулинга возникает только вместе с очисткой архитектуры:
410 → удалить внутренние ссылки → удалить из Sitemap → перестать генерировать URL.
Google прямо рекомендует 404 или 410 для окончательно удалённых страниц и указывает, что такие статусы служат сильным сигналом не продолжать активное сканирование URL; soft 404, наоборот, продолжают обходиться и действительно тратят ресурсы.
Яндекс также поддерживает 404 и 410 для удалённых страниц и предупреждает, что обход ненужных URL создаёт дополнительную нагрузку и может замедлять работу с полезными страницами.
Поэтому правильная цель аудита звучит не:
сделать ноль 404.
А:
не оставлять на сайте ни одного полезного маршрута, который ведёт в тупик, и как можно быстрее выводить действительно навсегда удалённые URL из активной архитектуры сайта.
Поиск битых ссылок полезно воспринимать не как разовую уборку сайта, а как часть регулярного технического контроля. После публикаций, удаления страниц, изменения URL, миграций и доработок появляются новые маршруты, которые нужно перепроверять: внутренние ссылки, редиректы, Sitemap, ответы
4xxи5xx, а на крупных проектах ещё и серверные логи. В рамках SEO-продвижения сайтов такая проверка должна заканчиваться не списком ошибок в отчёте, а исправлением источников битых ссылок, корректной обработкой удалённых URL и повторным crawl после внедрения.
Практика
Как проверить сайт на битые ссылки
Посмотрите данные поисковиков
Начните с Яндекс Вебмастера и Google Search Console, чтобы увидеть уже известные поисковым системам проблемные URL и внутренние ссылки.
Просканируйте сайт crawler
Запустите Screaming Frog, Netpeak Spider или другой crawler на безопасной скорости и выгрузите все внутренние ссылки, ведущие на 4xx и 5xx.
Проверьте спорные URL вручную
Используйте curl, чтобы увидеть первый HTTP-ответ, редиректы и финальный статус конкретного адреса.
Посмотрите серверные логи
Найдите 404 и 410 в access.log и определите, какие удалённые URL реально продолжают запрашивать пользователи и поисковые роботы.
Определите судьбу каждого URL
Если есть полноценный новый аналог — поставьте постоянный редирект. Если страница навсегда удалена без замены — используйте 410 Gone, удалите ссылки на неё и исключите из Sitemap.
Перепроверьте сайт
Повторите crawl и убедитесь, что внутренние страницы больше не ведут в тупики, а удалённые URL не продолжают генерироваться структурой сайта.
FAQ
Что делать с битыми ссылками и удалёнными страницами
Сам по себе корректный HTTP-код 404 для реально отсутствующей страницы не является причиной падения остальных страниц сайта. Проблемой становятся внутренние ссылки на этот URL, наличие удалённого адреса в Sitemap, soft 404, ошибочные редиректы и массовая генерация ненужных URL.
Если URL просто не найден или мог никогда не существовать, 404 Not Found корректен. Если вы точно знаете, что существовавшая страница удалена навсегда и не вернётся, 410 Gone семантически точнее, поэтому для таких адресов я предпочитаю 410. При этом Google сейчас рассматривает и 404, и 410 как сигнал отсутствия ресурса и постепенно снижает частоту повторного обхода; ожидать магического ускорения только от замены кода нельзя.
Косвенно — в правильной общей схеме. Сам статус 410 не является командой «никогда больше не заходить». Для экономии обхода нужно также удалить ссылки на URL, исключить его из Sitemap и прекратить генерацию адреса. Google прямо рекомендует возвращать 404 или 410 для окончательно удалённых страниц и устранять soft 404, которые продолжают сканироваться.
Да. Чем больше параллельных потоков и запросов в секунду, тем выше нагрузка на PHP, базу данных и веб-сервер. Screaming Frog по умолчанию использует пять потоков и позволяет ограничить число URL в секунду; разработчики прямо предупреждают, что чрезмерная скорость в крайнем случае способна перегрузить сервер.
Да. curl удобен для проверки конкретного URL или подготовленного списка адресов. Он показывает реальный HTTP-ответ сервера и позволяет проверить цепочки редиректов. Для полноценного поиска всех источников битых ссылок по сайту удобнее crawler, потому что он дополнительно показывает страницу, на которой расположен неправильный href.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.