Orphan page — это не «страница, которой нет в Google», а документ, на который не ведут нормальные внутренние ссылки с других страниц сайта. Это принципиальная разница: URL может отвечать 200 OK, находиться в Sitemap и даже участвовать в поиске, оставаясь сиротой внутри собственной архитектуры.
Поэтому диагностировать проблему только по индексу нельзя. В одном случае страница действительно неизвестна поисковому роботу, в другом Google или Яндекс уже нашли её обходным путём, но сам сайт никак не показывает, где этот документ находится и с какими материалами связан.
Почему orphan page может попасть в индекс — и всё равно оставаться проблемой
Поисковые роботы узнают о новых URL не из одного источника. Основной путь — ссылки на уже известных страницах, но дополнительно адрес может появиться в Sitemap, внешней ссылке, прежней версии сайта или другом источнике, доступном поисковой системе.
Google отдельно рекомендует делать важные страницы достижимыми по внутренним ссылкам и указывает, что каждая значимая страница должна иметь ссылку хотя бы с одной другой страницы сайта. Sitemap при этом помогает обнаруживать URL, но не гарантирует ни обход, ни индексирование.
Для Яндекса логика похожа: при формировании списка известных документов учитываются внутренние и внешние ссылки, Sitemap и другие сигналы. В документации Яндекс Вебмастера Sitemap прямо рекомендуется в том числе для страниц без навигационных ссылок.
Отсюда следует важный практический вывод: присутствие URL в поиске ещё не доказывает, что структура сайта исправна. И наоборот, отсутствие внутренних ссылок само по себе не доказывает, что документ никогда не индексировался.
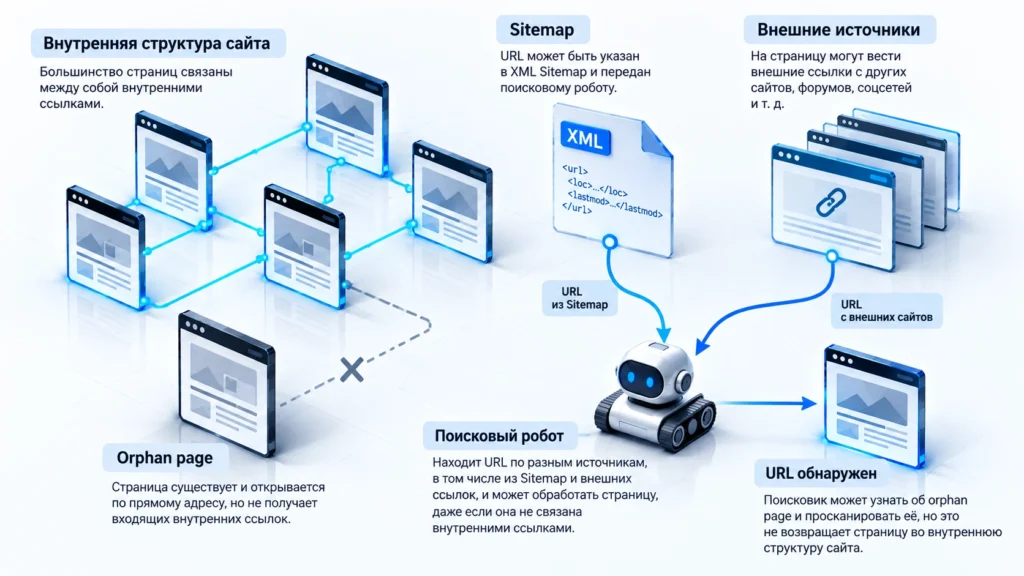
Есть ещё одно следствие. Внутренняя ссылка нужна не только роботу. Она формирует пользовательский маршрут и даёт окружающий контекст: из какого раздела пришёл человек, почему предлагается этот документ и о чём находится связанный материал. Поэтому просто добавить страницу в XML Sitemap — технически полезное действие, но не полноценная замена перелинковке.
Как найти страницы, которых не видит обычный краулер
Главная ловушка аудита orphan pages выглядит почти комично: запускается краулер от главной страницы, он проходит по внутренним ссылкам и не находит ни одной страницы-сироты. Формально всё чисто — именно потому, что до настоящих orphan pages краулер не смог добраться.
Поэтому нужен не один список URL, а сравнение источников.
| Источник | Что он даёт |
|---|---|
| Краулинг от главной | URL, реально достижимые по текущим внутренним ссылкам |
| XML Sitemap | Страницы, которые сайт заявляет поисковым системам |
| CMS или база данных | Опубликованные документы, даже если они выпали из навигации |
| Search Console и Яндекс Вебмастер | URL, уже известные конкретной поисковой системе |
| Серверные логи | Адреса, которые фактически запрашивали роботы и пользователи |
| Аналитика | Страницы с посещениями, которые могут не обнаруживаться обычным crawl |
Особенно важен полный список из CMS или базы. Search Console не может показать URL, которого Google вообще не знает: отчёт индексирования описывает известные Google адреса. Поэтому отсутствие документа в Search Console не является доказательством его отсутствия на сайте.
Рабочая логика простая: берём множество существующих или ранее обнаруженных URL и вычитаем из него страницы, имеющие входящие внутренние ссылки. Оставшиеся адреса — кандидаты на ручную проверку.
Если нужно отдельно пройти именно техническую методику сбора таких URL, в контент-плане уже предусмотрена отдельная проверка страниц без внутренних ссылок.
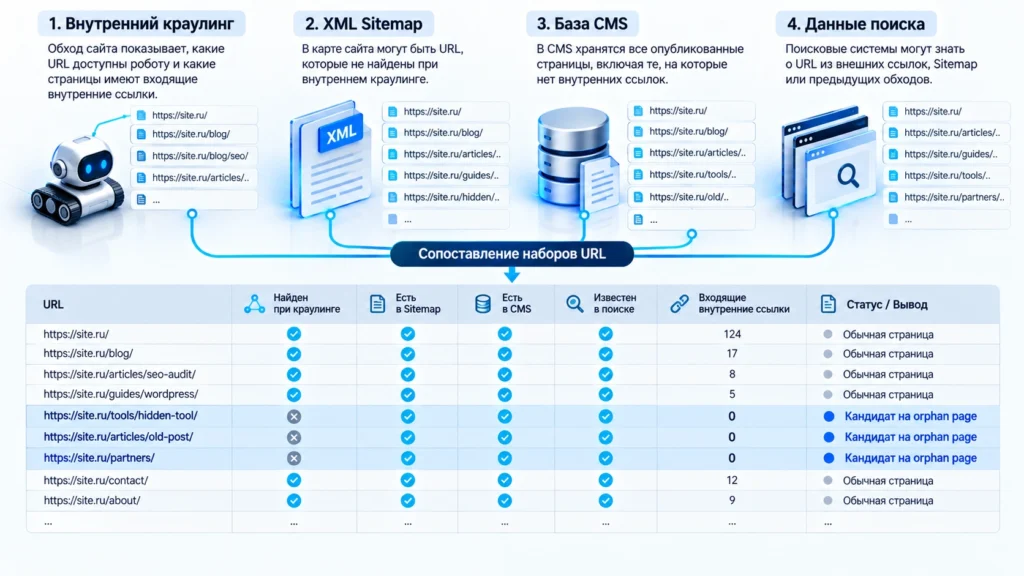
После обнаружения кандидата нужно проверить сам URL: отвечает ли он 200, разрешён ли обход, нет ли noindex, куда указывает canonical и должен ли этот документ вообще находиться в поиске. Страница без входящих ссылок и страница, намеренно исключённая из индекса, — разные задачи.
Что делать с найденными orphan pages
Автоматическое правило «нашли сироту — поставили ссылку» легко создаёт новую проблему: старые, дублирующиеся и служебные страницы начинают искусственно возвращаться в структуру.
Сначала определите назначение URL.
Если документ полезен, уникален и должен получать органический трафик, его логично встроить в существующий тематический маршрут: поставить содержательную ссылку из подходящей статьи, категории, хаба или другого документа. Не обязательно вести на него с главной — важнее, чтобы связь была естественной и доступной обычным <a href>.
Если страница устарела, а на сайте есть полноценная замена, разумнее использовать постоянный редирект на действительно эквивалентный документ, а не оживлять старый URL перелинковкой.
Если документ больше не нужен и релевантной замены нет, корректнее удалить его с правильным 404 или 410, чем отправлять все исчезнувшие страницы на главную.
Если URL нужен пользователю, но не должен участвовать в поиске, применяется отдельная политика индексирования. Например, для Google noindex должен быть доступен роботу для чтения: блокировка URL через robots.txt не является заменой noindex.
Когда orphan pages появляются десятками после миграций, смены шаблонов, удаления рубрик или нескольких лет публикаций, проблема обычно уже не в одной ссылке, а в архитектуре. В такой ситуации имеет смысл рассматривать SEO-продвижение сайта с техническим аудитом как системную работу: вместе с orphan pages проверяются индексация, редиректы, дубли, каноникализация и внутренняя структура, а не отдельный симптом.
Практический сценарий: статья есть в Sitemap, но не получает показов
Представим WordPress-сайт со статьёй /articles/example/. Она опубликована несколько месяцев назад, отвечает 200 OK, имеет self-canonical и присутствует в XML Sitemap. В Search Console URL известен, но показов почти нет.
При обычном обходе сайта от главной этот адрес не появляется. Проверка шаблонов показывает причину: старую рубрику удалили, блок похожих материалов заменили, а ручных ссылок на статью никогда не было. Получился классический orphan page.
На этом этапе нельзя утверждать: «показов нет именно из-за отсутствия ссылок». Для такого причинного вывода данных недостаточно. Но архитектурная ошибка установлена объективно: важный индексируемый документ не имеет маршрута из структуры сайта.
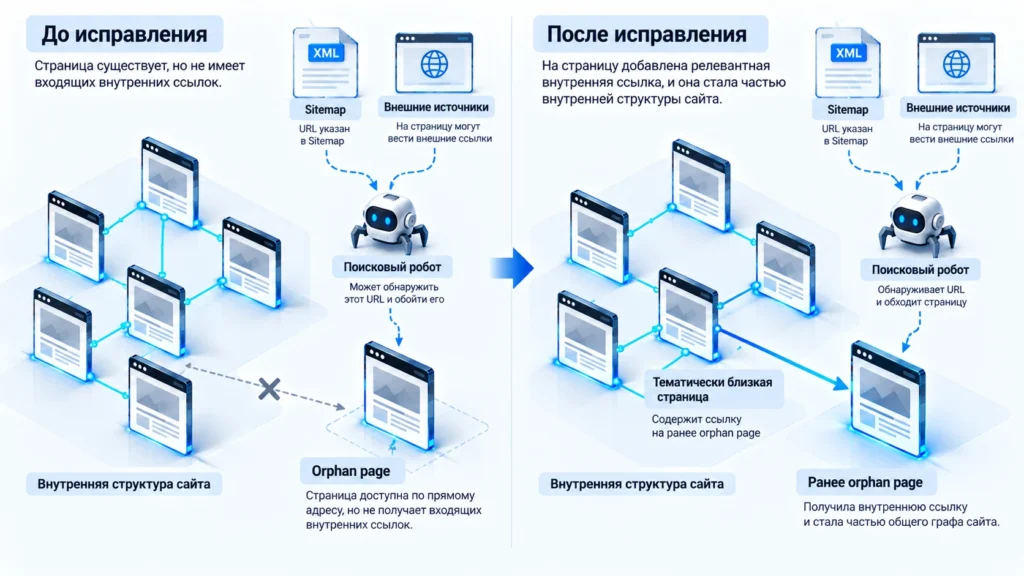
Исправление — не пять случайных ссылок из любых статей. Достаточно вернуть документ туда, где он действительно продолжает тему: например, добавить одну или несколько контекстных ссылок из близких материалов либо восстановить его участие в релевантном хабе.
Как проверить, что проблема действительно исправлена
Первая проверка выполняется не в поисковой выдаче, а на самом сайте. Повторный crawl должен находить страницу обычным переходом по внутренним ссылкам, а отчёт по inlinks — показывать реальный источник ссылки.
Затем стоит проверить HTTP-ответ, индексируемость, canonical и отсутствие случайного запрета на обход. Для конкретного URL в Google можно использовать URL Inspection: инструмент показывает известную Google версию страницы и позволяет выполнить live-проверку. В Яндекс Вебмастере полезно сопоставить данные об обходе и состоянии документа.
Изменение позиций не является критерием исправления orphan page. Технический критерий значительно строже и проще: нужный документ существует, доступен, индексируем при соответствующей задаче и больше не отделён от внутреннего графа сайта.
Именно поэтому orphan pages полезно рассматривать не как отдельный «SEO-фактор», а как диагностический признак. Он показывает, что фактический набор страниц сайта и его навигационная архитектура перестали совпадать. Сначала нужно восстановить или сознательно закрыть этот разрыв — и только после этого оценивать индексацию, показы и поисковый трафик.
FAQ
Когда страница без внутренних ссылок действительно требует исправления
Это существующие страницы сайта, на которые не ведут внутренние ссылки с других страниц. Пользователь может открыть такой URL напрямую, а поисковая система иногда обнаруживает его через Sitemap, внешнюю ссылку или собственную историю обхода. Однако внутри структуры сайта нормального маршрута к документу нет.
Сам факт отсутствия внутренних ссылок не является доказанной автоматической санкцией или причиной конкретной позиции. Но Google использует ссылки и для обнаружения новых URL, и как один из сигналов понимания страниц, а сам рекомендует давать каждой важной странице хотя бы одну внутреннюю ссылку. Поэтому проблема прежде всего архитектурная и может косвенно влиять на обнаружение, повторный обход и понимание документа.
Нужно сравнить два набора данных: все URL, которые реально существуют или известны поисковым системам, и страницы, найденные обычным краулингом внутренних ссылок. Источниками первого набора могут быть Sitemap, экспорт из CMS, Search Console, Яндекс Вебмастер, серверные логи и аналитика. URL, присутствующий в первом наборе, но не имеющий внутренних входящих ссылок во втором, требует проверки.
Нет. Сначала нужно решить, должна ли страница вообще существовать и участвовать в поиске. Полезный уникальный документ логично вернуть в структуру сайта, устаревший URL с подходящей заменой — перенаправить, ненужный документ — удалить корректным HTTP-ответом, а служебную страницу при необходимости оставить доступной пользователям, но исключить из индексации.
Sitemap помогает поисковой системе обнаружить URL, но не заменяет внутреннюю архитектуру сайта и не гарантирует обход или индексирование. Если страница действительно важна для пользователей и поиска, у неё должен быть логичный путь с других документов сайта, а не только запись в XML-файле.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.