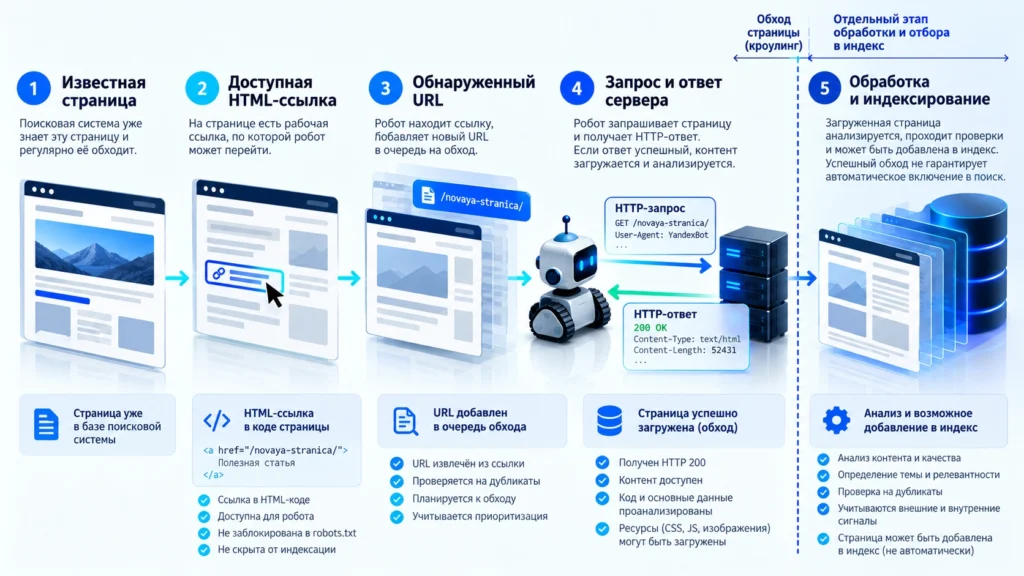
Обход по ссылкам начинается раньше индексирования. Поисковому роботу сначала нужно узнать адрес страницы — например, обнаружить его во внутренней или внешней ссылке, получить из Sitemap или другого поддерживаемого источника. Затем робот может запросить URL, получить ответ сервера и передать загруженные данные на дальнейшую обработку.
Поэтому ситуация «страница не находится в поиске» ещё не объясняет причину. Она могла вообще не быть обнаружена, робот мог знать URL, но не суметь его загрузить, либо успешно обойти страницу, после чего поисковая система не включила её в индекс.
Что означает обход по ссылкам на практике
Для поискового робота ссылка — это прежде всего адрес следующего ресурса. Google прямо указывает, что наиболее надёжно обрабатывает ссылку, когда она представлена обычным HTML-элементом <a> с атрибутом href. Яндекс также относит внутренние и внешние ссылки к источникам, из которых формируется список известных роботу страниц.
Простейший корректный вариант выглядит так:
<a href="/catalog/product/">Карточка товара</a>А конструкция, которая визуально работает для посетителя только через JavaScript, может оказаться значительно менее надёжным способом обнаружения адреса:
<span onclick="openProduct('/catalog/product/')">
  Карточка товара
</span>
Смысл обхода не в том, чтобы робот «кликал» по сайту как человек. Он анализирует доступный документ, извлекает адреса, которые способен распознать, и планирует дальнейшие запросы с учётом собственных правил и приоритетов.
Где ломается путь от ссылки до индекса
Для диагностики удобно разделить процесс на несколько независимых состояний.
| Этап | Что должно произойти | Типичная проблема |
|---|---|---|
| Обнаружение | робот узнаёт URL | на страницу нет доступных ссылок |
| Доступ | URL разрешён для обхода | запрет в robots.txt |
| Загрузка | сервер отдаёт страницу | 404, 5xx, цепочка редиректов |
| Обработка | поисковик анализирует документ | содержимое не удаётся корректно обработать |
| Индексирование | URL выбран для поискового индекса | дубль, иной canonical или другое решение поисковой системы |
Эта последовательность важна, потому что исправление должно соответствовать этапу проблемы. Отправлять URL на переобход бессмысленно, если сервер продолжает отвечать ошибкой или структура сайта снова оставляет страницу без нормальных внутренних ссылок.
Sitemap тоже не отменяет внутреннюю перелинковку. Google прямо предупреждает, что наличие URL в карте сайта не гарантирует ни обход, ни индексирование. Sitemap помогает поисковой системе обнаруживать адреса, особенно на крупных или сложных сайтах, но логически важные документы лучше делать достижимыми и через обычную структуру сайта.
Как проверить обход по ссылкам на сайте
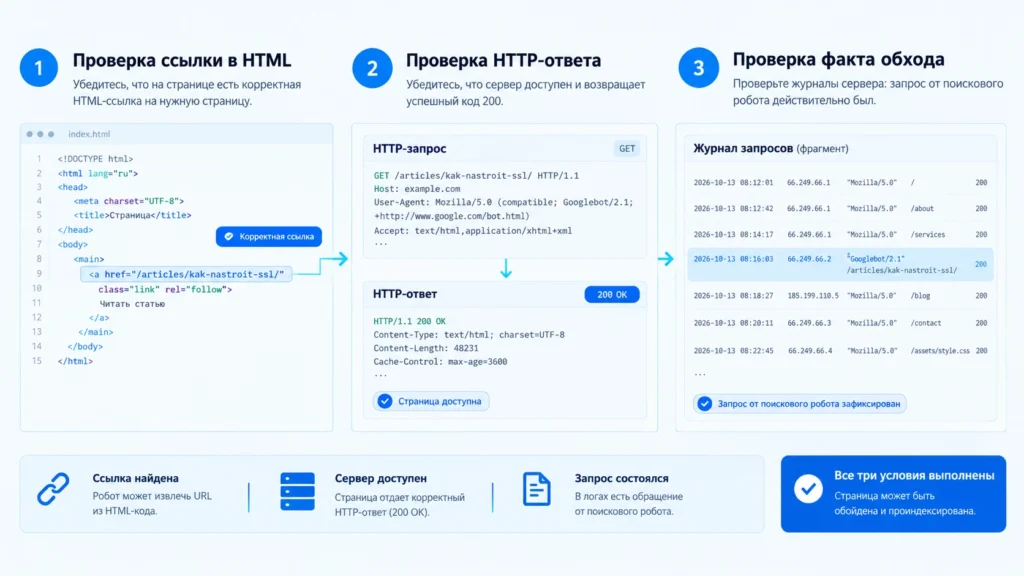
Начните с конкретного проблемного URL и пройдите путь назад.
- Найдите страницы, с которых на него должна вести внутренняя ссылка.
- Проверьте исходный HTML и убедитесь, что адрес действительно находится в
href. - Откройте целевой URL напрямую и проверьте итоговый HTTP-ответ.
- Убедитесь, что нужный путь не запрещён в
robots.txt. - Проверьте наличие URL в актуальном Sitemap, если он должен туда входить.
- Сопоставьте результат с данными поисковой системы и, при необходимости, с серверными логами.
Обход сайта роботом: что смотреть в данных
В Google Search Console инструмент проверки URL показывает сведения об известной Google версии страницы и позволяет выполнить проверку опубликованного URL. Для отдельной страницы можно запросить повторный обход, но Google отдельно подчёркивает: такой запрос не гарантирует немедленное или обязательное включение страницы в результаты поиска.
В Яндекс Вебмастере раздел «Индексирование → Статистика обхода» показывает посещённые роботом адреса, дату последнего обхода и HTTP-код, полученный при загрузке. Это позволяет отличить ситуацию «робот не знает страницу» от «робот пришёл, но сервер отдал ошибку».
Если статья или раздел регулярно обновляются, полезно сравнивать данные статистики обхода с серверными логами и состоянием самих URL. Так становится видно, проблема локальная у одной страницы или робот системно не доходит до целой части структуры.
Как исправить проблемы с обходом по ссылкам
Если URL невозможно нормально обнаружить из других страниц, первым исправлением должна быть не ручная отправка в панели поисковика, а восстановление нормального пути внутри сайта.
Для важных страниц проверьте:
- есть ли хотя бы одна логичная внутренняя ссылка с доступной роботу страницы;
- используется ли обычный адрес в
href; - не появляется ли ссылка только после пользовательского действия, которое робот может не воспроизвести;
- ведёт ли ссылка сразу на актуальный URL, а не через ненужную цепочку перенаправлений;
- возвращает ли целевая страница ожидаемый ответ сервера;
- нет ли противоречия между
robots.txt, индексирующими директивами и фактической задачей страницы; - соответствует ли Sitemap текущей структуре.
Для Google особенно важно не использовать robots.txt как способ гарантированно удалить HTML-страницу из поиска: официальная документация разделяет управление обходом и управление индексированием. Закрытый от обхода URL при определённых условиях всё равно может быть известен поисковой системе по внешним сигналам.
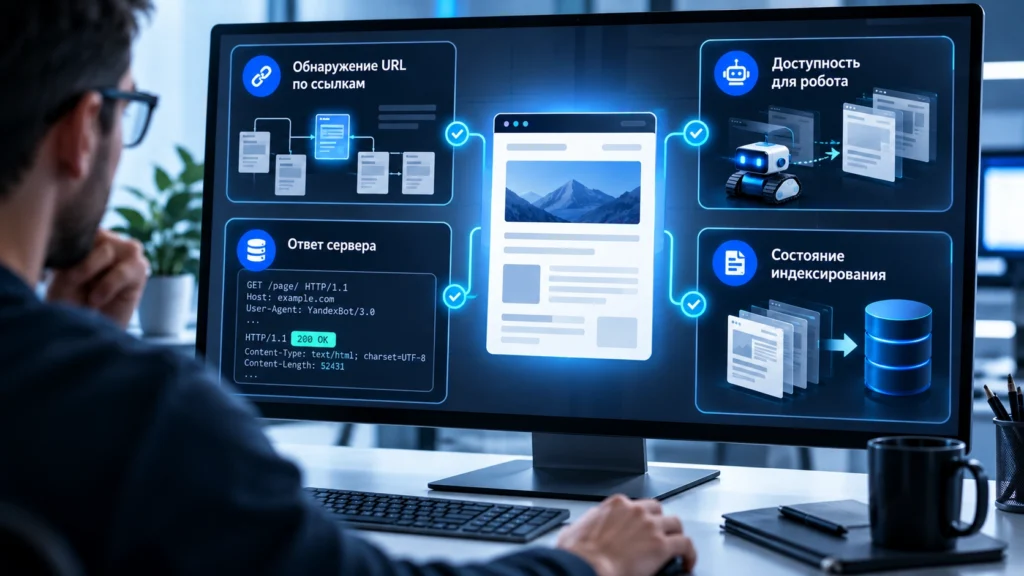
Если проблемы с обнаружением URL повторяются на уровне разделов, шаблонов или тысяч страниц, это уже не единичная правка перелинковки. В таком случае комплексное поисковое продвижение сайта уместно рассматривать вместе с техническим аудитом структуры: требуется сопоставить архитектуру сайта, доступность страниц, внутренние связи и фактическое поведение поисковых роботов.
Практический сценарий: страница есть в Sitemap, но робот до неё почти не доходит
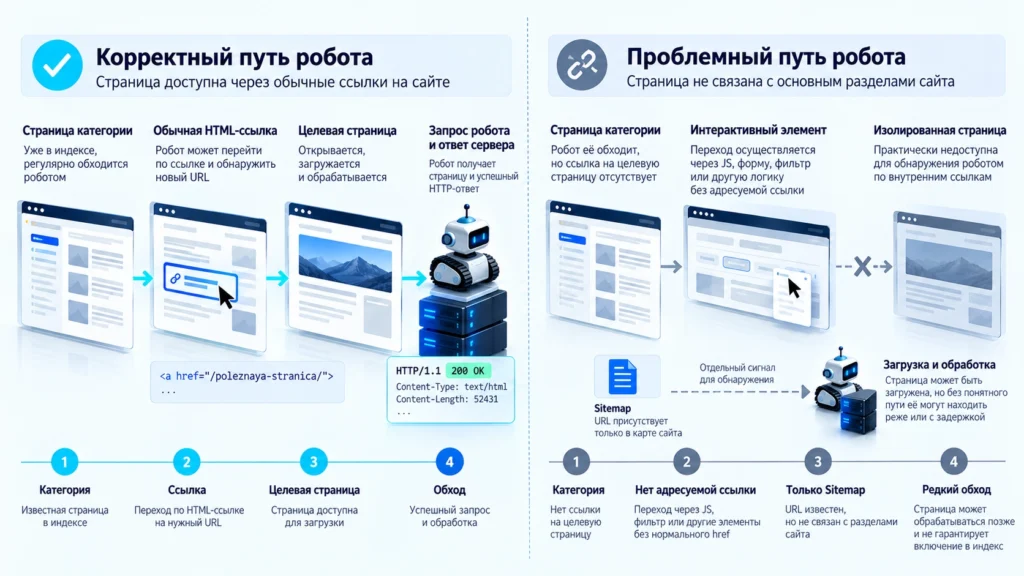
Представим новый раздел сайта. Все карточки добавлены в sitemap.xml, но ссылки на них доступны только после выбора нескольких фильтров в JavaScript-интерфейсе. В обычном HTML категории прямых ссылок нет.
На первый взгляд всё настроено: URL существует, сервер отвечает 200 OK, Sitemap обновляется. Но внутренняя структура почти не даёт роботу маршрута к карточкам.
Исправление состоит не в массовой отправке адресов на переобход, а в создании доступной навигации: категория или листинг должны содержать обычные ссылки на важные страницы. После публикации изменений нужно снова проверить HTML, HTTP-ответы и фактические обращения робота.
Нормальный результат здесь — не мгновенный рост позиций, а подтверждение технической цепочки: важные URL обнаруживаются, сервер стабильно отвечает, поисковый робот начинает посещать страницы, а в инструментах индексирования больше нет проблемы именно на этапе обхода.
Ручной запрос на переобход можно использовать после исправления для нескольких важных URL. Для большого набора страниц Google рекомендует Sitemap, а Яндекс предоставляет Sitemap и собственный инструмент «Переобход страниц». Но ни один из этих механизмов не делает слабую структуру сайта правильной автоматически.
Частые ошибки, из-за которых робот теряет страницы
Ссылка существует только визуально. Кнопка или JavaScript-событие открывают страницу для пользователя, но в исходной структуре нет нормального href.
Страница-сирота присутствует только в Sitemap. Карта сообщает поисковику URL, однако никакая страница сайта логически на него не ссылается.
Используется противоречивая блокировка. Страница одновременно должна индексироваться и при этом закрыта от нормального обхода.
После изменения URL остались лишние переходы. Внутренние ссылки ведут через старые адреса и несколько редиректов вместо прямой ссылки на актуальную страницу.
Проверяется индекс вместо этапа обхода. Отсутствие URL в выдаче сразу трактуется как проблема краулинга, хотя робот уже успешно посещает страницу.
Что считать успешным исправлением
Проблема обхода по ссылкам считается решённой не тогда, когда URL один раз отправлен поисковику, а когда устранена сама причина.
Для важной страницы должны одновременно выполняться несколько условий: робот может обнаружить её через нормальную структуру сайта, адрес доступен для запроса, сервер возвращает корректный ответ, настройки не запрещают нужный обход, а поисковые инструменты или логи подтверждают посещение.
Если эти условия выполнены, но URL всё равно не участвует в поиске, дальнейшую диагностику нужно переносить с краулинга на следующий уровень — каноникализацию, дублирование, качество и обработку страницы поисковой системой. Это уже другая причина, и увеличение числа внутренних ссылок само по себе её не исправит.
FAQ
Как понять, почему робот не доходит до страницы
Это обнаружение URL поисковым роботом через ссылки на уже известной ему странице. Робот извлекает адрес ссылки, добавляет его в процесс обхода и при необходимости запрашивает целевую страницу. Обнаружение URL при этом не означает автоматическое попадание страницы в поиск.
Возможность обнаружить и загрузить страницу необходима для нормальной работы поиска с её содержимым, поэтому плохая доступность для робота может косвенно ограничить SEO-результат. Но сам факт перехода робота по ссылке не является гарантией индексирования или роста позиций. Ранжирование происходит уже после обхода и обработки страницы.
Для Google проверьте URL через URL Inspection в Search Console, а для Яндекса — данные раздела «Индексирование → Статистика обхода» и инструменты проверки страницы. Дополнительно изучите серверные логи: они позволяют подтвердить реальный запрос робота и полученный им HTTP-код.
Sitemap полезен как дополнительный источник URL и особенно важен для крупных, новых или глубоко структурированных сайтов. Но он не заменяет нормальную внутреннюю навигацию и не гарантирует обход или индексирование каждого указанного URL. Важная страница должна быть логично связана с другими материалами сайта.
Проверьте последовательно саму ссылку, доступность URL, HTTP-код, robots.txt, директивы индексирования, канонический адрес и состояние страницы в инструментах поисковой системы. Если робот уже успешно загружает страницу, проблема находится не на этапе обнаружения по ссылке, а дальше — при обработке или выборе URL для индекса.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.