YandexBot важен не потому, что его нужно «привлечь на сайт» любой ценой. Для технического SEO важнее понять, видит ли робот нужные URL, может ли их загрузить и не расходуется ли значительная часть обхода на дубли, параметры и ошибочные страницы.
При этом три события нельзя смешивать: обход страницы, её индексирование и ранжирование — разные этапы. Запрос YandexBot со статусом 200 OK подтверждает, что сервер отдал документ роботу, но не доказывает, что URL обязательно окажется в поиске или получит определённую позицию.
Что именно делает YandexBot и где заканчивается его роль
В официальном списке роботов Яндекса YandexBot/3.0 указан как основной индексирующий робот. Кроме него существуют отдельные агенты для изображений, видео, проверки доступности, рендеринга ресурсов и других задач. Поэтому наличие слова Yandex в User-Agent ещё не означает, что конкретный запрос выполнялся основным поисковым роботом.
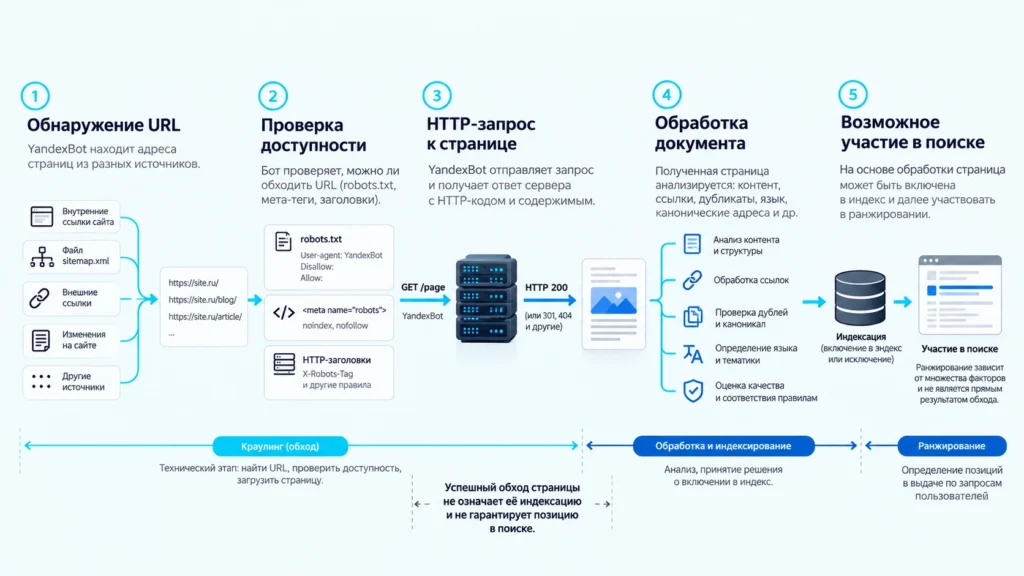
Упрощённо цепочка выглядит так:
- поисковая система узнаёт об URL;
- робот определяет, разрешён ли обход;
- сервер получает HTTP-запрос;
- страница, редирект или ошибка возвращаются роботу;
- полученный документ обрабатывается поисковой системой;
- после обработки URL может появиться в поиске, быть исключён или конкурировать с другим каноническим документом.
Для более подробного объяснения самого механизма обнаружения URL и краулинга полезен разбор работы робота Яндекса. Здесь же важнее практическая диагностика: какие данные смотреть, если кажется, что YandexBot работает неправильно.
Как проверить YandexBot: логи, Вебмастер и DNS отвечают на разные вопросы
Самая полезная проверка начинается не с общего графика, а с конкретного URL.
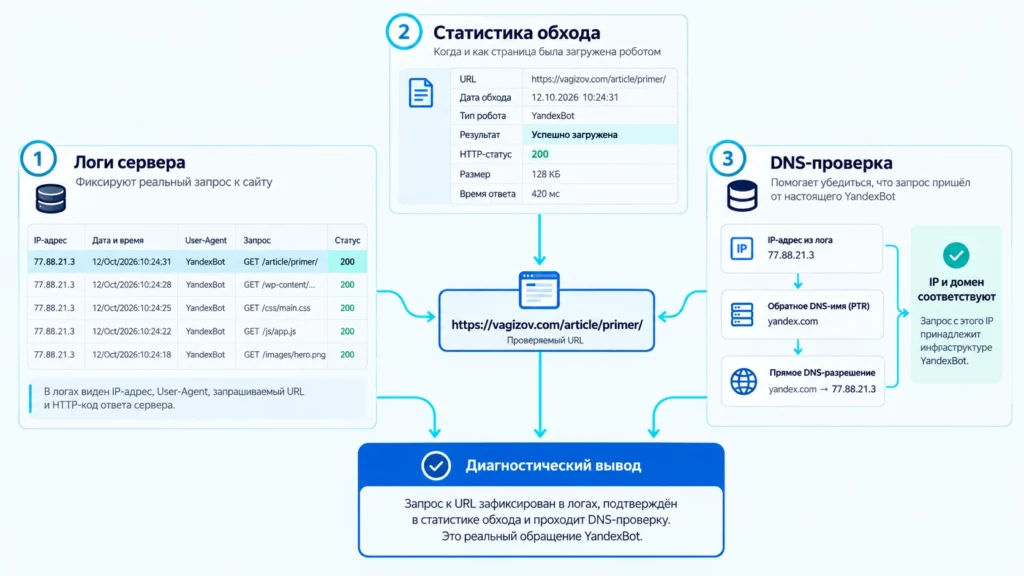
Серверные логи показывают фактический запрос
Access-log позволяет увидеть время обращения, URL, IP, HTTP-код и User-Agent. Для первичной выборки можно искать YandexBot, но не стоит привязывать фильтр к версии браузерного движка: Яндекс прямо предупреждает, что она может меняться.
Упрощённая строка может выглядеть так:
203.0.113.10 - - [13/Oct/2026:10:42:18 +0300]
"GET /catalog/product/ HTTP/1.1" 200 18452
"-" "Mozilla/5.0 (compatible; YandexBot/3.0; +http://yandex.com/bots)"
Такой лог подтверждает лишь то, что запрос с указанным User-Agent дошёл до сервера и получил 200. Он ещё не доказывает происхождение IP.
Яндекс Вебмастер показывает обход со стороны поисковой системы
В разделе «Индексирование → Статистика обхода» можно сопоставить URL, дату последнего посещения и код ответа сервера. Это удобно для поиска групповых проблем: например, серии 404, недоступного раздела или большого количества технических адресов.
Отдельно полезна «Проверка страницы»: она помогает посмотреть доступность конкретного URL для выбранного робота. Если нужно понять не только обход, но и дальнейшее состояние документа, проверяют уже данные об индексировании страницы.
User-Agent нельзя использовать как единственное доказательство
Строку YandexBot/3.0 может отправить любой клиент. Если требуется убедиться, что IP действительно принадлежит роботу Яндекса, схема проверки строже:
IP из лога → reverse DNS → hostname → forward DNS → исходный IP.
По документации Яндекса имя настоящего робота должно оканчиваться на yandex.ru, yandex.net или yandex.com, а прямое разрешение найденного hostname должно вернуть исходный IP. Фильтрация только по опубликованному списку IP ненадёжна: адреса роботов могут меняться.
Что в robots.txt действительно влияет на обход
Для общих правил роботов Яндекса используется секция:
User-agent: Yandex
Disallow: /private/
Если правила предназначены для конкретного агента, их можно задавать отдельно. При этом важно проверить, какая секция фактически будет применена: наличие более конкретных правил меняет выбор группы директив.
Типичная ошибка — пытаться удалить уже известную страницу из поиска только через Disallow. robots.txt прежде всего регулирует обход. Если поисковой системе нужно увидеть noindex, закрывать загрузку этой же страницы в robots.txt обычно противоречит цели.
Ещё одна устаревшая настройка — Crawl-delay. Яндекс перестал учитывать её в 2018 году; скорость обращений индексирующего робота настраивается через Вебмастер.
Если нужен сравнительный взгляд на то, как устроен краулинг сайта в Google и других поисковых системах, важно сохранять разделение между общими принципами HTTP-обхода и правилами конкретной поисковой системы.
Какие симптомы действительно требуют диагностики
Не каждое изменение графика обхода — ошибка. Яндекс прямо указывает, что число посещаемых роботом страниц может меняться по дням и само по себе такое колебание не означает ухудшение индексирования или ранжирования.
Полезнее смотреть на конкретный симптом:
| Симптом | Что проверить первым | Что считать проблемой |
|---|---|---|
| Нужный URL давно не посещался | внутренние ссылки, Sitemap, robots.txt, Вебмастер | URL недоступен роботу или плохо обнаруживается |
Много ответов 404 | источники ссылок и удалённые URL | робот регулярно получает ненужные несуществующие адреса |
| Много URL с параметрами | фильтры, сортировки, UTM, генерацию ссылок | обход расходуется на многочисленные однотипные варианты |
Растут 5xx | серверные логи и нагрузку | робот систематически не может получить нужные документы |
| В логах слишком много «YandexBot» | IP и DNS | часть запросов может лишь имитировать User-Agent |
| Страница обходится, но её нет в поиске | состояние индексирования | причина уже может находиться после этапа краулинга |
Именно такое разделение полезно и при анализе работы поискового робота на реальном сайте: сначала устанавливается технический факт, а уже затем делается SEO-вывод.
Практический сценарий: YandexBot обходит тысячи параметрических URL
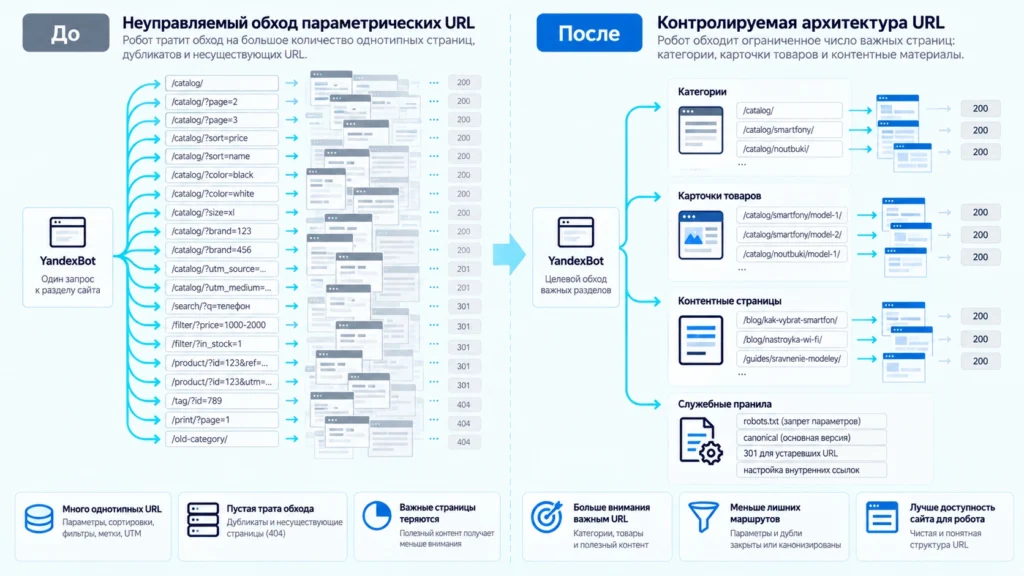
Представим интернет-магазин с 8 000 полезных страниц. В логах видно, что значительная доля запросов YandexBot приходится на адреса вида:
/catalog/?sort=price
/catalog/?sort=price&utm_source=...
/catalog/?color=black&size=42
Одновременно новые карточки товаров обходятся заметно реже.
Неправильный вывод — «нужно заставить YandexBot заходить чаще». Сначала следует определить, почему параметры доступны по внутренним ссылкам и какие из этих URL действительно должны существовать для поиска.
Проверка выглядит так: сгруппировать запросы робота по шаблону URL, сравнить HTTP-коды и объём обращений к полезным и техническим страницам, проверить генерацию ссылок, robots.txt и архитектуру фильтров. После исправления нужно снова посмотреть логи и статистику обхода: доля технических вариантов должна сократиться, а нужные страницы оставаться доступными.
Когда проблема YandexBot становится задачей SEO
Разовые колебания частоты обхода обычно недостаточны для вывода. Повод для работы появляется, когда можно связать технический симптом с конкретными страницами: важные URL закрыты, сервер возвращает ошибки, робот массово ходит по дублям либо структура сайта затрудняет обнаружение новых документов.
На проектах, где такие проверки являются частью регулярной технической работы, диагностику краулинга логично включать в комплексное SEO-продвижение сайта вместе с контролем индексации, структуры URL, Sitemap, внутренних ссылок и серверных ошибок. Само изменение настроек YandexBot не является самостоятельной гарантией роста позиций.
Что считать исправленной проблемой
Хороший результат измеряется не тем, что YandexBot стал появляться в логах чаще. Для конкретной группы страниц должны одновременно выполняться более содержательные условия:
- важные URL разрешены для обхода;
- сервер стабильно возвращает ожидаемые HTTP-коды;
- робот не упирается в систематические
5xx; - технические дубли и бесполезные параметры не доминируют в обходе;
- источник необычного User-Agent подтверждён, если его подлинность важна для диагностики;
- после изменения серверные логи и Вебмастер подтверждают ожидаемое поведение.
Такой подход позволяет отделить реальную техническую проблему от нормальных колебаний работы поискового робота и не менять конфигурацию сайта только ради красивого графика обхода.
FAQ
Как отличить проблему YandexBot от нормального поведения поиска
YandexBot — основной индексирующий робот Яндекса. Он обращается к страницам сайта, получает их содержимое и передаёт данные для дальнейшей обработки поисковой системой. Посещение страницы роботом ещё не гарантирует её присутствие или высокую позицию в поиске.
Прямой зависимости вида «больше запросов робота — выше позиции» Яндекс не заявляет. Более того, в документации Вебмастера указано, что изменение количества обходов само по себе не влияет на индексирование и ранжирование. Проблемой становится не число запросов как таковое, а ситуация, когда важные страницы недоступны или значительная часть обхода уходит на ненужные URL.
User-Agent недостаточен, поскольку его можно подделать. Яндекс рекомендует получить IP из серверного лога, выполнить reverse DNS lookup, проверить окончание имени хоста на yandex.ru, yandex.net или yandex.com, а затем прямым DNS-запросом убедиться, что имя снова разрешается в исходный IP. Также в Вебмастере доступен инструмент проверки IP-адреса.
На практике стоит проверять ошибочные запреты в robots.txt, ответы 4xx/5xx на нужных страницах, лишние редиректы, большое число параметрических и дублирующих URL, а также перегрузку сервера. Отдельная ошибка — считать любой запрос с YandexBot доказательством того, что обращался настоящий робот Яндекса.
Сначала проверьте доступность URL для робота, правила robots.txt и HTTP-ответ сервера, затем убедитесь, что страница доступна по внутренним ссылкам и при необходимости присутствует в Sitemap. После исправления страницу можно отправить на переобход и контролировать последующие обращения по Вебмастеру и серверным логам.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.