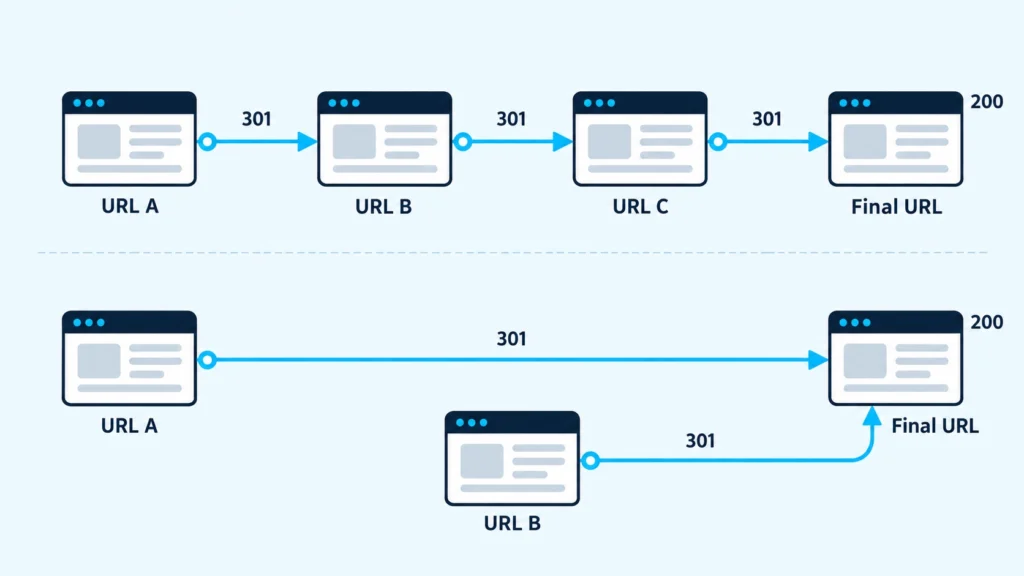
Если адрес A перенаправляет на B, а B — на C, запрос к A уже образует redirect chain. При следующем редизайне или смене структуры легко появляется ещё одно звено: A → B → C → D. Пользователь обычно видит только конечную страницу, поэтому проблема долго остаётся незаметной.
Для поискового робота и браузера каждое звено — отдельный HTTP-запрос. Оно должно получить ответ, прочитать Location, обратиться к следующему адресу и только после этого загрузить конечный документ. Поэтому рабочая задача при аудите редиректов — не «запретить любые цепочки», а убрать ненужные промежуточные переходы и сохранить правильное соответствие старого URL новой странице.
Google рассматривает постоянные серверные редиректы 301 и 308 как сильный сигнал в пользу конечного URL. При этом рекомендации Google по миграциям прямо предлагают вести на конечный адрес сразу и избегать цепочек. Это важное различие: корректный постоянный редирект помогает перенести URL, но дополнительные звенья сами по себе ничего не улучшают.
Где появляется redirect chain
Чаще всего цепочка возникает не из одного ошибочного правила, а из истории сайта.
Предположим, карточка услуги сначала находилась по адресу:
/services/site/После изменения структуры её перенесли:
/services/web-development/А через год раздел снова реорганизовали:
/development/website/Если каждое изменение просто добавлялось поверх предыдущего, получится:
/services/site/
301 → /services/web-development/
301 → /development/website/
200
Функционально переход работает. Но первое правило уже знает только о втором адресе, хотя актуальная страница находится по третьему.
После исправления логика должна выглядеть так:
/services/site/
301 → /development/website/
200

/services/web-development/
301 → /development/website/
200
То есть каждый устаревший адрес самостоятельно ведёт на действующую страницу.
Redirect loop — другая ситуация. Например:
/a/
301 → /b/

/b/
301 → /a/
Конечного документа здесь нет вообще. Клиент продолжает ходить по кругу, пока не остановит попытки. Именно поэтому при диагностике важно видеть всю последовательность, а не проверять только первый статус 301.
Почему лишние переходы важны для обхода и SEO
Самый простой эффект цепочки — задержка. Каждый дополнительный переход требует ещё одного запроса. На быстром сервере разница для одной страницы может быть небольшой, но при массовом обходе сайта эти обращения складываются.
Google отдельно предупреждает, что длинные redirect chain отрицательно влияют на эффективность сканирования. Технически Googlebot обычно способен пройти до десяти переходов, однако это не целевое значение. В документации по переносу сайтов Google рекомендует направлять запрос сразу на конечный URL, а если полностью избежать цепочки нельзя — держать её максимально короткой.
Второй аспект — обработка самого переноса. Для постоянного изменения адреса Google рекомендует серверные 301 или 308. Оба кода сигнализируют о постоянном перемещении; в стандарте HTTP для 308 дополнительно зафиксировано сохранение метода запроса, тогда как при 301 пользовательский агент в некоторых сценариях может преобразовать POST в GET.
Для обычного переноса индексируемой HTML-страницы принципиальнее другое: временный и постоянный редирект имеют разный смысл. 302 и 307 нужны, когда исходный URL предполагается сохранить как основной после временной ситуации. Использовать временный код просто потому, что «он тоже перенаправляет», — плохая замена осознанному выбору статуса.
Важно и не приписывать цепочкам неподтверждённый эффект. Google прямо указывает, что постоянные редиректы сами по себе не приводят к потере PageRank. Поэтому тезис «каждый 301 отнимает фиксированный процент веса» некорректен. Причина сокращать chain — чистая архитектура, эффективный обход, меньшая задержка и снижение количества точек отказа, а не попытка вернуть некий фиксированный процент «ссылочного веса».
Как проверить redirect chain на сайте
Один URL удобно начинать проверять с HTTP-заголовков. Например:
curl -IL https://example.com/old-url/В ответе интересуют три вещи:
- последовательность кодов
301,302,307или308; - значение
Locationпосле каждого редиректа; - статус и адрес конечного ответа.
Условный результат:
HTTP/2 301
location: https://example.com/old-section/page/

HTTP/2 301
location: https://example.com/new-section/page/

HTTP/2 200
Это уже две переадресации перед получением страницы.
Для одного URL такой способ удобен, но сайт нужно проверять краулером или собственным скриптом: задача состоит в том, чтобы найти все исходные страницы, которые проходят больше одного перенаправления, а также loop, ответы 4xx/5xx внутри цепочки и редиректы на неожиданный хост или протокол.
Если сервер по-разному обрабатывает HEAD и обычный GET, результат стоит дополнительно проверить полноценным запросом. Это особенно актуально при нестандартных приложениях, CDN и защитных прослойках.
Google Search Console тоже может помочь обнаружить проблему с конкретными URL. Статус Redirect error используется, в частности, когда Google сталкивается со слишком длинной цепочкой, циклом, некорректным или пустым адресом внутри неё либо URL, который в процессе перенаправлений становится чрезмерно длинным. Но Search Console не заменяет собственный технический краул: для массовой диагностики нужна полная карта переходов.
Как исправить цепочку, не сломав существующие URL
Начинать с редактирования rewrite-правил рискованно. Сначала нужна таблица соответствий.
Redirect map SEO: сначала определить конечные адреса
Минимальная redirect map содержит:
| Старый URL | Текущий маршрут | Конечный URL | Действие |
|---|---|---|---|
/old-a/ | /old-a/ → /mid-a/ → /new-a/ | /new-a/ | вести сразу на /new-a/ |
/mid-a/ | /mid-a/ → /new-a/ | /new-a/ | оставить |
/old-b/ | /old-b/ → /new-b/ | /new-b/ | без изменений |
Такая карта отделяет бизнес-решение «куда должна попасть старая страница» от технической реализации «каким правилом это сделать». Это особенно важно при миграции тысяч URL, где массовая настройка 301-редиректов без заранее проверенной карты легко создаёт неверные цели, дубли правил и новые цепочки.
Если структура менялась несколько раз, полезно отдельно проверить цепочки редиректов при миграции: старый домен, HTTP/HTTPS, www, изменение каталогов и новая структура могут наслаиваться друг на друга.
После определения конечных URL правила переписывают так, чтобы все известные старые варианты указывали непосредственно на актуальный адрес.
Для Nginx упрощённый принцип выглядит так:
location = /old-url/ {
    return 301 https://example.com/new-url/;
}

location = /intermediate-url/ {
    return 301 https://example.com/new-url/;
}
А не так:
location = /old-url/ {
    return 301 https://example.com/intermediate-url/;
}

location = /intermediate-url/ {
    return 301 https://example.com/new-url/;
}
На WordPress источник цепочки не обязательно находится в одном месте. Один переход может выполнять CDN, второй — Nginx или Apache, третий — плагин редиректов, а четвёртый появляться из-за нормализации URL самим приложением. Поэтому проверять нужно фактический HTTP-маршрут снаружи, а не только список правил в админке.
После исправления обновите собственные внутренние ссылки. Если меню или статья продолжает ссылаться на /old-url/, редирект останется рабочим, но сайт сам будет создавать лишний запрос при каждом переходе пользователя и робота. Sitemap и canonical также должны использовать конечные канонические URL.
Ошибки, из-за которых цепочка появляется снова
Одновременная нормализация нескольких параметров.
Например, запрос сначала переводится с HTTP на HTTPS, затем с www на вариант без www, а потом исправляется слеш. Эти действия часто можно объединить так, чтобы исходный вариант сразу получал правильный канонический адрес.
Старое правило не обновили после второго переноса.
URL A когда-то отправлялся на B. После переноса B на C добавили новый редирект, но правило A → B осталось прежним.
Разные уровни инфраструктуры не знают друг о друге.
CDN, веб-сервер и WordPress независимо меняют URL. По отдельности каждое правило выглядит правильным, вместе получается chain или loop.
Массовый редирект на главную страницу.
Если удалённые документы не имеют релевантной замены, перенаправлять их все на главную только ради сохранения 301 не стоит. Google предупреждает, что нерелевантное массовое перенаправление может восприниматься как soft 404. Иногда корректный 404 или 410 точнее описывает состояние ресурса.
Исправление только первого перехода.
После изменения правила нужно снова пройти весь маршрут. Новый первый hop может оказаться прямым, но конечный адрес сам продолжит перенаправлять из-за canonical-нормализации, языковой версии или старого правила приложения.
Практический сценарий: три изменения URL за несколько лет
Допустим, в 2023 году страница находилась по адресу:
/catalog/seo/Затем:
/services/seo/А актуальная версия:
/seo-promotion/Краул показывает:
/catalog/seo/
301 → /services/seo/
301 → /seo-promotion/
200
Сначала фиксируем, что содержимое старой страницы действительно заменено /seo-promotion/. Затем меняем первое правило:
/catalog/seo/
301 → /seo-promotion/
200
Правило для /services/seo/ сохраняем, потому что этот адрес тоже существовал публично и на него могут вести старые внешние ссылки:
/services/seo/
301 → /seo-promotion/
200
После этого заменяем внутренние ссылки и запись в Sitemap на /seo-promotion/, проверяем self-canonical конечной страницы и повторяем краул.
Итоговый критерий здесь не «редиректов стало меньше вообще». На сайте может быть сколько угодно старых URL, если каждый корректно ведёт на нужную замену. Критерий — каждый исходный адрес достигает правильной конечной страницы без ненужных промежуточных остановок.
Как понять, что исправление завершено
После внедрения пройдите контрольный список:
- старые URL возвращают ожидаемый постоянный редирект;
Locationсразу указывает на окончательную релевантную страницу;- конечный URL отвечает
200; - redirect loop отсутствуют;
- внутри цепочки нет
404,410или5xx; - внутренние ссылки ведут на конечные адреса;
- Sitemap содержит актуальные индексируемые URL;
- canonical конечной страницы согласован с её фактическим адресом;
- HTTP/HTTPS,
wwwи правила слеша не создают дополнительные переходы; - после повторного обхода не появляются новые неожиданные цепочки.
При переносе сайта постоянные редиректы не стоит удалять сразу после того, как новый URL появился в поиске. Google рекомендует сохранять их как можно дольше и для миграций указывает ориентир не менее года, чтобы системы успели повторно обойти старые адреса и перенести связанные с ними сигналы.
Главная цель работы с redirect chain поэтому довольно практична: сохранить полезные старые точки входа, но убрать из маршрута всё, что больше не нужно. Старый URL остаётся доступным через перенаправление, а пользователь и робот получают актуальную страницу настолько прямым маршрутом, насколько позволяет архитектура сайта.
Практика
Как убрать redirect chain без разрыва перенаправлений
Зафиксируйте текущую карту URL
Соберите исходные адреса, промежуточные переходы и фактические конечные URL, чтобы изменение правил не потеряло действующие перенаправления.
Снимите HTTP-цепочки
Проверьте каждый важный исходный URL краулером или HTTP-инструментом и сохраните коды ответа и значения Location.
Определите конечные страницы
Для каждого старого URL выберите единственную релевантную актуальную страницу, которая должна возвращать конечный ответ без дополнительного перенаправления.
Сверните правила редиректа
Измените правила так, чтобы исходные URL сразу указывали на конечные адреса вместо последовательного прохождения устаревших версий.
Обновите внутренние ссылки
Замените ссылки сайта на старые или промежуточные адреса прямыми ссылками на актуальные URL, чтобы собственная навигация не запускала редирект.
Проверьте результат повторно
Повторите краул и убедитесь, что конечные страницы возвращают 200, цепочки и циклы исчезли, а canonical и Sitemap используют актуальные адреса.
FAQ
Когда цепочка редиректов уже требует исправления
Это ситуация, когда браузер или поисковый робот попадает с исходного URL не сразу на конечную страницу, а проходит несколько перенаправлений. Например: /old/ → /catalog/old/ → /catalog/new/. Рабочим целевым состоянием обычно является прямой переход /old/ → /catalog/new/.
Само наличие дополнительного перехода не означает автоматическую потерю позиций. Google прямо указывает, что постоянные редиректы могут передавать сигналы на новый URL, однако длинные цепочки отрицательно влияют на эффективность обхода и добавляют задержку. Поэтому их сокращение — техническая оптимизация, а не гарантия роста трафика.
Googlebot обычно способен пройти до 10 редиректов, но это технический предел, а не рекомендуемая архитектура. Google советует по возможности перенаправлять сразу на конечный URL; если цепочка неизбежна, держать её короткой, предпочтительно в пределах нескольких переходов.
При chain последовательность в итоге заканчивается рабочей страницей. При loop один из URL снова отправляет запрос на уже пройденный адрес, поэтому конечная страница не достигается. Такой цикл является технической ошибкой и должен быть устранён.
Проверьте HTTP-коды и Location, конечный статус 200, внутренние ссылки, canonical и Sitemap. Для важных URL дополнительно просмотрите данные обхода и индексирования в инструментах поисковых систем после повторного посещения страниц роботами.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.