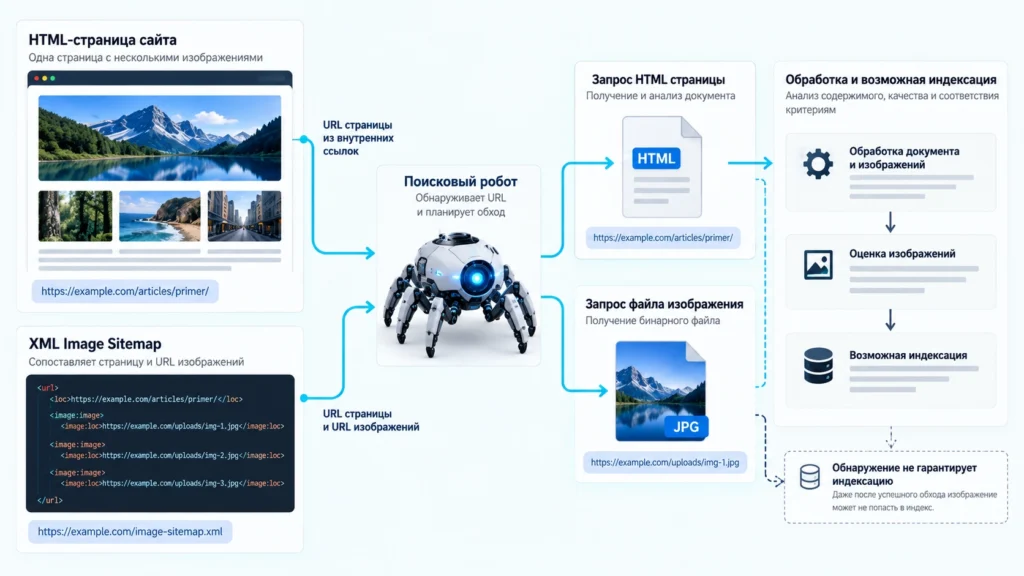
Image Sitemap — это расширение обычного XML Sitemap, с помощью которого поисковой системе можно явно указать изображения, связанные с конкретными страницами сайта. На практике он особенно полезен там, где важные изображения сложно обнаружить обычным обходом: например, при нестандартной загрузке медиаконтента, использовании JavaScript или сложной структуре большого проекта.
Для Google отдельный файл необязателен: изображения можно добавить в существующую XML-карту либо сформировать самостоятельный Image Sitemap. Оба способа допустимы. Главное — чтобы поисковый робот мог получить саму карту, посадочную страницу и указанный файл изображения.
При этом Sitemap остаётся подсказкой для обнаружения URL. Google прямо предупреждает: присутствие URL в карте не означает, что объект обязательно будет просканирован или проиндексирован. Поэтому исправная карта изображений — это только один слой технической настройки, а не способ автоматически повысить позиции.
Когда Image Sitemap действительно решает проблему
Обычный обход начинается со страниц и ссылок. Для изображений Google также рекомендует использовать стандартные HTML-элементы: робот умеет находить URL в атрибуте src элемента <img>, в том числе внутри <picture>. CSS background-image для этой задачи Google не индексирует как обычное изображение.
Image Sitemap становится особенно полезен, если:
- на сайте много изображений и часть из них расположена глубоко в структуре;
- медиаконтент появляется только после выполнения клиентской логики;
- изображения размещены на отдельном CDN;
- сайт недавно запущен и робот ещё плохо знает его структуру;
- изображения имеют самостоятельную поисковую ценность: товары, схемы, фотографии объектов, инструкции, иллюстрации статей;
- нужно системно контролировать соответствие страниц и их основных медиаресурсов.
Это не означает, что в карту нужно автоматически отправлять каждый технический файл. Иконки интерфейса, декоративные фоны, пиксели, служебные изображения темы и десятки одинаковых миниатюр редко имеют самостоятельную ценность для поиска.
Google формулирует назначение Sitemap именно как помощь в обнаружении важных страниц и файлов. Карта может улучшить процесс обхода большого или сложного сайта, но не заменяет внутренние ссылки, нормальную HTML-разметку и доступность контента.
Как должен выглядеть актуальный Image Sitemap
Для Google используется стандартное пространство имён Sitemap и дополнительное пространство имён изображений. Минимальная рабочая запись выглядит так:
<?xml version="1.0" encoding="UTF-8"?>
<urlset
  xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"
  xmlns:image="http://www.google.com/schemas/sitemap-image/1.1">

  <url>
    <loc>https://example.com/catalog/product/</loc>

    <image:image>
      <image:loc>https://example.com/uploads/product-front.webp</image:loc>
    </image:image>

    <image:image>
      <image:loc>https://cdn.example.com/product-detail.webp</image:loc>
    </image:image>
  </url>

</urlset>
<loc> указывает страницу, на которой находится изображение. Каждый <image:image> описывает отдельный медиаресурс, а обязательный <image:loc> содержит полный URL самого файла. По актуальной документации Google внутри одного элемента <url> допускается до 1000 элементов <image:image>.
Важно не копировать старые примеры из давно опубликованных инструкций. Google удалил из актуальной документации теги <image:caption>, <image:geo_location>, <image:title> и <image:license>. Сейчас для Image Sitemap обязательны именно image:image и image:loc.
Для самой карты продолжают действовать общие ограничения Sitemap: не более 50 000 URL и 50 МБ в несжатом виде на один файл. Если объём больше, карты разделяют и при необходимости объединяют через sitemap index.
Что делать с изображениями на CDN
Google разрешает указывать в <image:loc> изображение с другого домена. Это удобно, когда HTML находится на www.example.com, а медиатека — на cdn.example.com.
Но CDN не должен превращаться в слепую зону диагностики. Google рекомендует подтвердить оба домена в Search Console и проверить, что robots.txt медиадомена не запрещает нужный контент.
Также желательно не генерировать для одного и того же изображения постоянно меняющиеся URL без причины. Стабильный адрес упрощает повторный обход и кэширование ресурса.
Проверка начинается не с Search Console
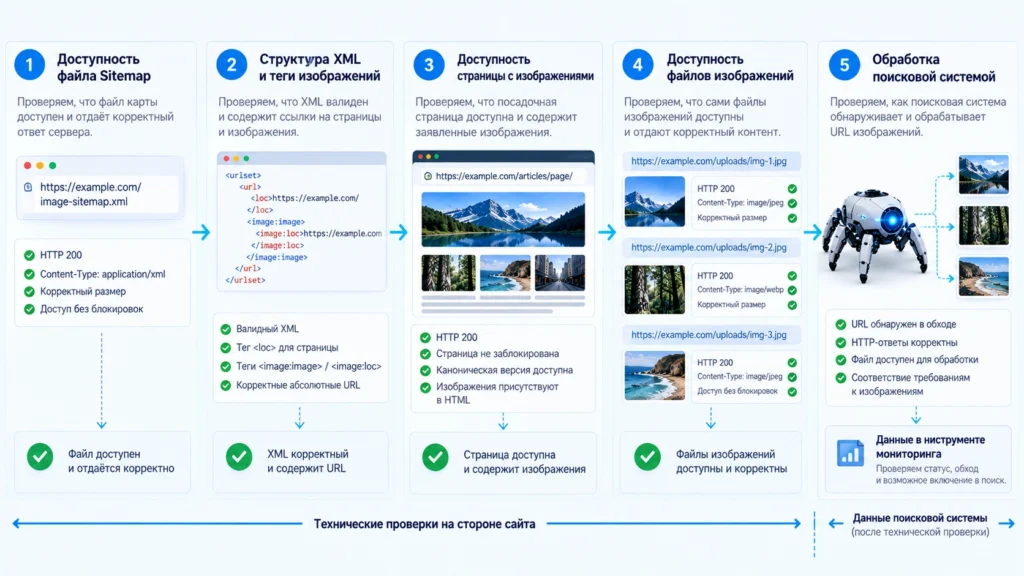
Частая ошибка — сразу отправить новый sitemap-файл и ждать изменения статуса. Сначала стоит доказать, что техническая цепочка работает без участия поисковой панели.
Минимальная проверка состоит из нескольких уровней:
| Что проверяем | Нормальное состояние | Проблема |
|---|---|---|
| Sitemap | HTTP 200, корректный XML | 404, 5xx, редирект, битый XML |
| URL страницы | доступен роботу | закрыт, удалён или требует авторизацию |
image:loc | абсолютный рабочий URL | относительный, устаревший или ошибочный адрес |
| Файл изображения | отдаётся сервером | 403, 404, 5xx |
| robots.txt | не запрещает нужный ресурс | закрывает каталог изображений или Sitemap |
| Связь с контентом | изображение действительно относится к странице | карта содержит случайные или технические файлы |
Полезно проверить XML не только визуально в браузере, но и краулером или XML-валидатором. У большого динамического сайта наиболее опасны не синтаксические ошибки, а рассинхронизация: страница уже изменилась, а генератор продолжает публиковать старый URL файла.
После этого карту можно добавить в раздел Sitemaps Google Search Console. Успешный статус означает, что Google смог получить и обработать Sitemap. Он не означает, что каждое указанное изображение уже попало в индекс.
Здесь есть ещё одно важное ограничение интерфейса: Google прямо указывает, что через Sitemap можно передавать URL изображений, но отчёт Sitemaps сейчас не показывает отдельные данные по таким URL. Поэтому искать в нём показатель вроде «проиндексировано 684 изображения из 700» не нужно.
Практический сценарий: изображения загружаются через JavaScript и CDN
Представим интернет-каталог, в котором карточка товара открывается быстро, а дополнительные фотографии появляются только после выполнения JavaScript. Сами файлы лежат на отдельном CDN.
Краулер сайта показывает 20 000 индексируемых карточек. У каждой есть основное изображение в обычном <img>, но дополнительные фотографии не всегда обнаруживаются при первичном обходе.
В такой ситуации имеет смысл не создавать отдельные страницы под каждую картинку, а добавить важные изображения в Sitemap как ресурсы существующей карточки товара.
Для одной страницы итоговая логика будет такой:
/product/model-x/
├── /model-x-front.webp
├── /model-x-side.webp
└── https://cdn.example.com/model-x-detail.webp
Все три адреса можно связать с одной страницей через элементы image:image.
После генерации нужно взять не весь каталог, а ограниченную выборку: например, товары с локальными изображениями, изображения с CDN и страницы с динамической загрузкой. Для каждой выборки проверяются XML, HTTP-ответы и фактическое присутствие нужного изображения на странице.
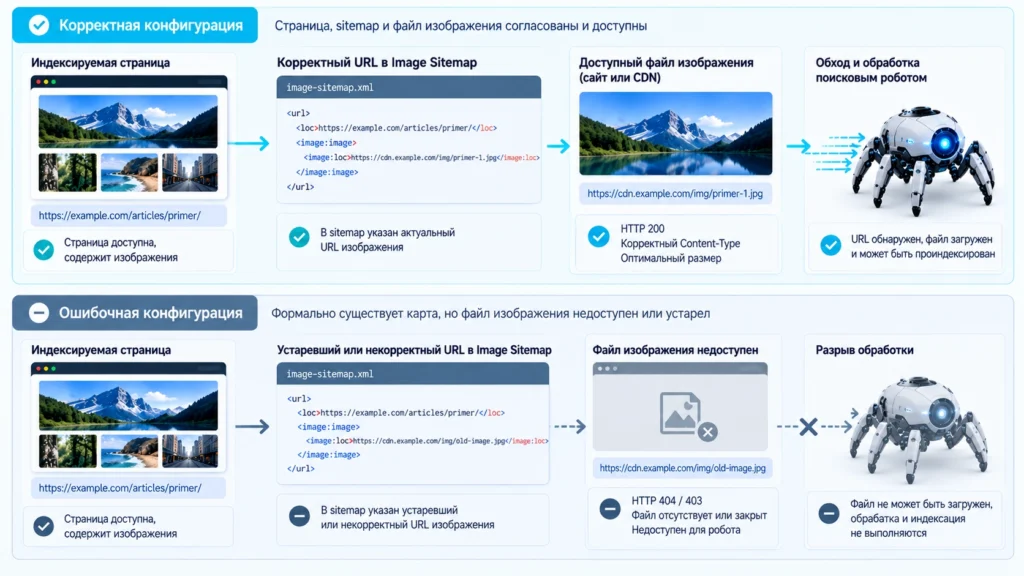
Если тест прошёл, изменение масштабируется на весь тип страниц. Если же image:loc возвращает 403 с CDN, отправка Sitemap в Search Console проблему не исправит — сначала нужно восстановить доступ поискового робота к файлу.
Такая последовательность важна и для больших проектов: сначала ограниченный rollout, затем проверка логов и только после этого массовое включение.
Что проверить отдельно на WordPress
Наличие стандартного wp-sitemap.xml ещё не означает, что сайт уже передаёт поисковику изображения через Image Sitemap.
В актуальном WordPress Core штатный XML-рендерер работает с базовыми полями Sitemap — loc, lastmod, changefreq и priority. Произвольные поля расширений, включая структуру image:image, штатным рендерером не формируются.
Поэтому на WordPress нужно смотреть фактический XML, а не наличие самого файла Sitemap. Если расширение изображений действительно требуется, его обычно формирует SEO-плагин, отдельный генератор либо собственная серверная логика.
Перед установкой ещё одного плагина полезно проверить:
- какая система сейчас генерирует sitemap index;
- нет ли одновременно двух конкурирующих Sitemap;
- включает ли существующий SEO-модуль изображения;
- какие типы изображений он добавляет;
- не попадают ли туда служебные размеры и вложения без поисковой ценности;
- сохраняются ли корректные URL после регенерации миниатюр или переноса CDN.
Особенно опасно поддерживать два независимых генератора, которые по-разному определяют canonical URL или набор индексируемых страниц. В этом случае проблема уже шире Image Sitemap.
Если аудит Sitemap, индексации, robots.txt, шаблонов и технических ограничений входит в регулярную работу над проектом, это обычно становится частью SEO-продвижения сайта с техническим внедрением, а не отдельной разовой настройки XML-файла. Сама карта имеет смысл только внутри общей системы обхода и индексирования сайта.
Ошибки, из-за которых карта не выполняет свою задачу
В Sitemap попадают изображения, которых уже нет. Это типично после миграции медиатеки, смены CDN или массовой конвертации форматов. XML остаётся валидным, но image:loc возвращает 404.
Изображение закрыто в robots.txt. Карта сообщает поисковику URL, однако одновременно серверная конфигурация запрещает его обход.
Используется устаревшая XML-разметка. Старые инструкции по Image Sitemap всё ещё содержат image:title, image:caption, image:license и image:geo_location. В актуальной документации Google эти элементы уже помечены как удалённые из спецификации документации.
Генератор добавляет всё подряд. Десятки иконок, логотипов, технических thumbnail-размеров и декоративных ресурсов увеличивают карту, но не делают основной медиаконтент страницы понятнее.
Sitemap пытаются использовать вместо нормальной HTML-разметки. Если основное изображение можно вывести обычным <img src="...">, это остаётся более фундаментальным способом сделать ресурс обнаруживаемым. Карта дополняет такой механизм, а не отменяет его.
Проверяют только статус «Success». Успешная обработка Sitemap подтверждает чтение файла, но не индексацию каждого изображения.
Что считать успешной настройкой
Рабочий Image Sitemap — это не просто XML без синтаксических ошибок. У него должны совпадать сразу несколько условий:
- в карте находятся актуальные индексируемые страницы;
image:locсодержит реальные абсолютные URL;- изображения соответствуют странице и имеют поисковую ценность;
- страницы и файлы доступны роботу;
- CDN не блокирует получение контента;
- карта возвращает стабильный успешный HTTP-ответ;
- поисковая система принимает Sitemap без ошибок;
- после изменений серверные логи подтверждают повторный обход нужных ресурсов.
Google рекомендует Image Sitemap прежде всего как способ сообщить об изображениях, которые иначе могут остаться незамеченными. Яндекс также указывает, что Sitemap можно использовать для труднодоступного контента и передачи информации об изображениях. Но ни одна из этих рекомендаций не превращает карту в гарантию индексации.
Поэтому критерий простой: если робот и без неё стабильно обнаруживает все важные изображения, отдельная сложная инфраструктура может не понадобиться. Если же часть ценного медиаконтента теряется из-за JavaScript, CDN или масштаба проекта, Image Sitemap становится полезным дополнительным каналом обнаружения.
Практика
Как настроить и проверить Image Sitemap
Проверьте текущее состояние
Зафиксируйте текущие sitemap-файлы и выберите несколько страниц с важными изображениями, чтобы после внедрения сравнить результат.
Соберите URL изображений
Сопоставьте индексируемые страницы с реальными URL изображений и исключите удалённые файлы, технические миниатюры и ошибочные адреса.
Сформируйте XML
Добавьте пространство имён Image Sitemap и для каждого нужного изображения сформируйте связку image:image → image:loc.
Проверьте доступность
Убедитесь, что Sitemap, страницы и файлы изображений отвечают корректными HTTP-кодами и не запрещены для нужных поисковых роботов.
Отправьте Sitemap
Передайте URL карты через Google Search Console и при необходимости Яндекс Вебмастер, затем дождитесь успешной обработки без ошибок XML.
Контролируйте переобход
После внедрения проверяйте серверные логи, состояние посадочных страниц и появление важных изображений в поиске, не считая один статус Sitemap доказательством индексации.
FAQ
Когда Image Sitemap помогает, а когда проблема находится не в карте
Это XML-карта, которая связывает URL страницы с размещёнными на ней изображениями. Google разрешает создать отдельный Image Sitemap или добавить теги изображений в обычный XML Sitemap. Такой файл прежде всего помогает обнаруживать изображения, а не заменяет оптимизацию самих страниц.
Наличие Image Sitemap само по себе не даёт подтверждённого бонуса к позициям. Google описывает Sitemap как подсказку для обнаружения и обхода URL и прямо не гарантирует, что перечисленный контент будет просканирован или проиндексирован. Польза возникает тогда, когда карта действительно помогает роботу находить важные изображения.
Не обязательно. Для Google допустимы оба варианта: отдельный Image Sitemap и расширение уже существующего XML Sitemap тегами изображений. Выбор лучше делать по архитектуре сайта и удобству поддержки генератора.
Отчёт Sitemaps показывает получение и обработку самой карты, но Google отдельно предупреждает, что сейчас не выводит в этом отчёте данные по переданным URL изображений. Поэтому успешный статус Sitemap нельзя считать доказательством индексации каждого изображения.
Проверьте доступность самих файлов для робота, robots.txt, HTTP-коды, URL CDN, способ вывода изображения в HTML и доступность посадочной страницы. Карта не исправляет запрет обхода, удалённый файл, ошибочный URL или страницу, которую поисковая система не может нормально обработать.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.