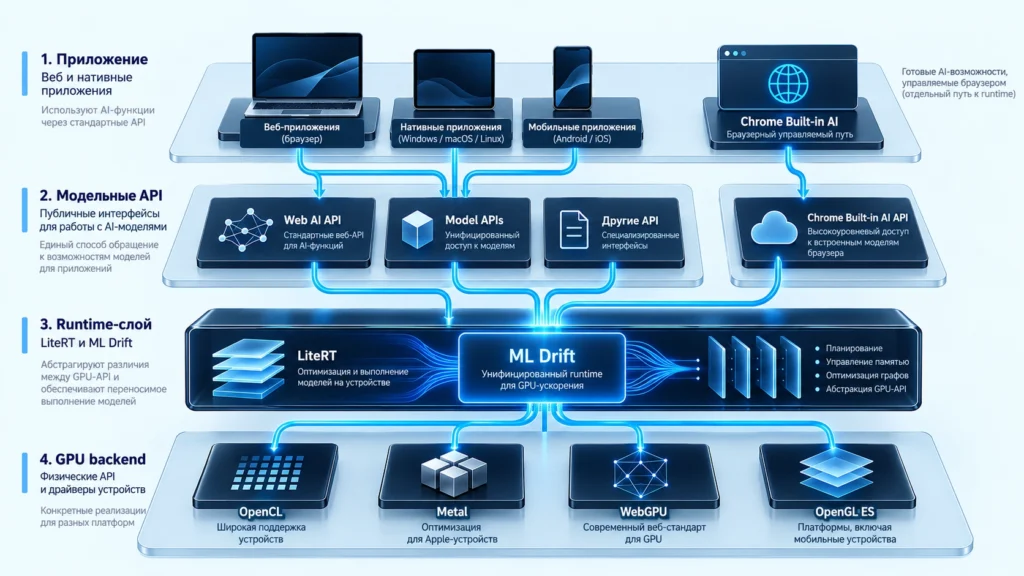
Google представила ML Drift 8 октября 2026 года как open-source GPU compute engine для on-device AI. Это важное уточнение: перед нами не очередная модель семейства Gemini и не JavaScript API для сайта, а инфраструктурный слой, который должен выполнять AI/ML workloads на разнородных GPU через OpenCL, Metal, WebGPU и OpenGL ES. ML Drift распространяется под Apache 2.0, является основным GPU acceleration engine внутри LiteRT и одновременно доступен как отдельная библиотека для собственных runtime.
Для веб-разработки интереснее всего не само появление ещё одного runtime, а границы между его слоями. Chrome Built-in AI, LiteRT, WebGPU и ML Drift решают разные задачи. Если их смешать, легко сделать неверный вывод вроде «сайт теперь вызывает ML Drift через Gemini Nano» или «WebGPU автоматически означает ML Drift». Реальная архитектура сложнее.
Почему GPU inference на пользовательских устройствах трудно унифицировать
В дата-центре инфраструктура заранее известна: можно подобрать accelerator, драйверы и runtime под определённый парк серверов. На пользовательском устройстве приложение получает комбинацию GPU-архитектуры, драйвера, операционной системы, доступного low-level API, ограничений памяти и особенностей конкретной модели.
Google описывает именно эту фрагментацию как одну из причин создания ML Drift. Его задача — отделить вычислительный граф и оптимизированные операции от конкретного способа физического размещения данных и исполнения shader-кода.
В репозитории ML Drift перечислены четыре основных GPU backend:
| Backend | Типичная среда |
|---|---|
| OpenCL | прежде всего Android |
| Metal | устройства Apple |
| WebGPU | браузеры и cross-platform execution через Dawn |
| OpenGL ES 3.1+ | совместимые GPU-среды |
Над ними находится единая модель исполнения. Центральным представлением вычислительного графа служит GpuModel, отдельные вычисления оформляются как GpuOperation, а Unified Compute Language абстрагирует shader-код от конкретных GLSL, MSL и WGSL-представлений.
Это не означает, что различия между GPU исчезают. Они перемещаются ниже по стеку — туда, где runtime может выбрать layout, kernel, распределение workgroups и формат хранения данных с учётом конкретного backend.
Что ML Drift Google меняет внутри GPU runtime
Одно из ключевых изменений Google называет tensor virtualization. В старом TFLite GPU delegate логическое представление tensor было теснее связано с физическими GPU-объектами вроде textures и buffers. Из-за этого оптимизированные shader-пути приходилось поддерживать с большим количеством backend-specific различий.
ML Drift отделяет логическое представление tensor от его физического размещения. Координаты и storage mapping разрешаются при подготовке вычисления, а единый shader-шаблон может адаптироваться к backend. По заявлению Google, такая схема уменьшает необходимость поддерживать отдельные реализации одного и того же вычисления для разных GPU API.
Второй уровень оптимизации — сам граф. Runtime может выполнять transformations, fusion операций, менять layout и сокращать количество отдельных kernel launches. Это особенно важно на edge-устройстве: производительность определяется не только арифметической мощностью GPU, но и количеством промежуточных перемещений памяти и синхронизаций.
Третий уровень — динамическая генерация kernels. В README проекта Google указывает, что shaders могут формироваться с учётом модели, входов и конкретного GPU. Там же перечислены memory reuse, rearrangement весов, workgroup tuning и поддержка FP16/INT8/INT4 как части набора оптимизаций.
Именно поэтому ML Drift корректнее описывать как execution engine. Он не решает, что пользователь спросил у AI и какой ответ нужно сформировать. Его зона ответственности начинается значительно ниже: как физически выполнить вычислительный граф на доступном GPU.
Prefill и decode требуют разных оптимизаций
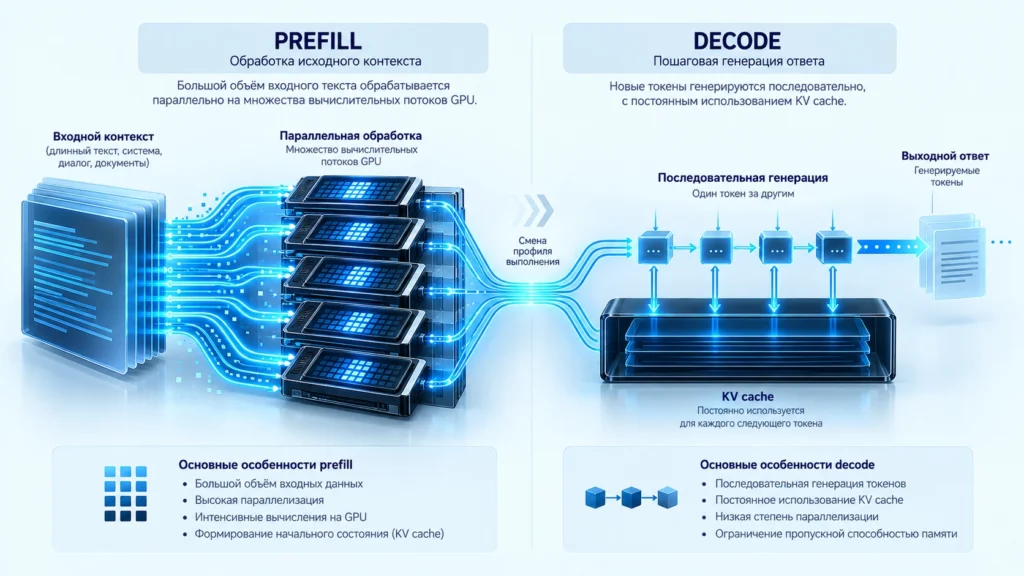
У генеративной модели есть принципиально разные фазы работы.
Во время prefill модель обрабатывает уже существующий контекст: system prompt, пользовательский запрос, историю или большой документ. Это относительно большой объём вычислений, который можно хорошо распараллелить.
Во время decode новые tokens появляются последовательно. Здесь характер нагрузки меняется: приходится многократно обращаться к весам и KV cache, а пропускная способность памяти может стать важнее чистой вычислительной мощности.
Google прямо пишет, что ML Drift использует stage-aware execution и может менять kernels и layout в зависимости от того, находится workload в prefill или decode. Для decode отдельно описаны оптимизированное размещение KV cache и in-kernel activation quantization, уменьшающая лишние memory roundtrips.
Отсюда следует важное правило для собственных benchmarks: нельзя сводить LLM к одному числу в миллисекундах или tokens/s.
В опубликованном Google тесте мобильных LLM отдельно зафиксированы prefill 512, decode 128, итоговый context length 640, 4-bit weights с block size 32, fp16 KV cache, argmax sampling и синхронизация после каждого token. Для desktop-таблицы использован уже другой workload: prefill 8192, decode 1024, context 9216. Эти результаты полезны только внутри указанного test context.
По той же причине фраза Google об «up to 12% lower memory overhead» относится к их Gemma benchmarks, а не к любому сайту, любой модели и любому GPU. Переносить такое число в SLA собственного приложения нельзя.
Где здесь LiteRT, WebGPU и Chrome Built-in AI
На уровне LiteRT ML Drift используется как GPU acceleration engine. Сам LiteRT шире: он отвечает за deployment модели, runtime API, выбор и подключение accelerators и другие части on-device inference stack. В текущем репозитории LiteRT GPU-путь прямо обозначен через ML Drift.
Для браузерной разработки есть как минимум два принципиально разных сценария.
Сценарий 1. Собственная модель через LiteRT.js
LiteRT.js позволяет загрузить конвертированную модель и выбрать WebGPU как accelerator:
const model = await loadAndCompile('/models/model.tflite', {
  accelerator: 'webgpu',
});
Официальная документация также рекомендует отдельно проверять модель на GPU и CPU, поскольку покрытие операций у hardware backend может отличаться. Если операция не поддерживается WebGPU, возможен CPU/WASM-путь; документация отдельно предупреждает, что LiteRT.js не поддерживает произвольное частичное выполнение одной модели одновременно на CPU и GPU.
Здесь разработчик контролирует собственный model artifact и pipeline.
Сценарий 2. Chrome Built-in AI
У Summarizer, LanguageModel, Writer и других Built-in AI API другая граница ответственности. Модель предоставляет и управляет ею сам браузер. Сайт обращается к task API или Prompt API, а не загружает свой .tflite и не выбирает kernel.
Google сообщает, что Chrome интегрировал ML Drift в AI runtime infrastructure для аппаратного ускорения Gemini Nano, используемого Built-in AI APIs. Но это внутренняя часть реализации Chrome, а не обещание API вроде new MLDrift() для страницы.
Именно это разделение важно для архитектуры. Summarizer — интерфейс продукта. Gemini Nano — модель. ML Drift — один из execution/runtime-компонентов ниже неё. WebGPU — ещё более низкоуровневый GPU API/backend.
Практический сценарий: локальное резюме статьи с безопасным fallback
Представим веб-приложение, где пользователь открывает длинный внутренний документ и нажимает «Сделать краткое резюме».
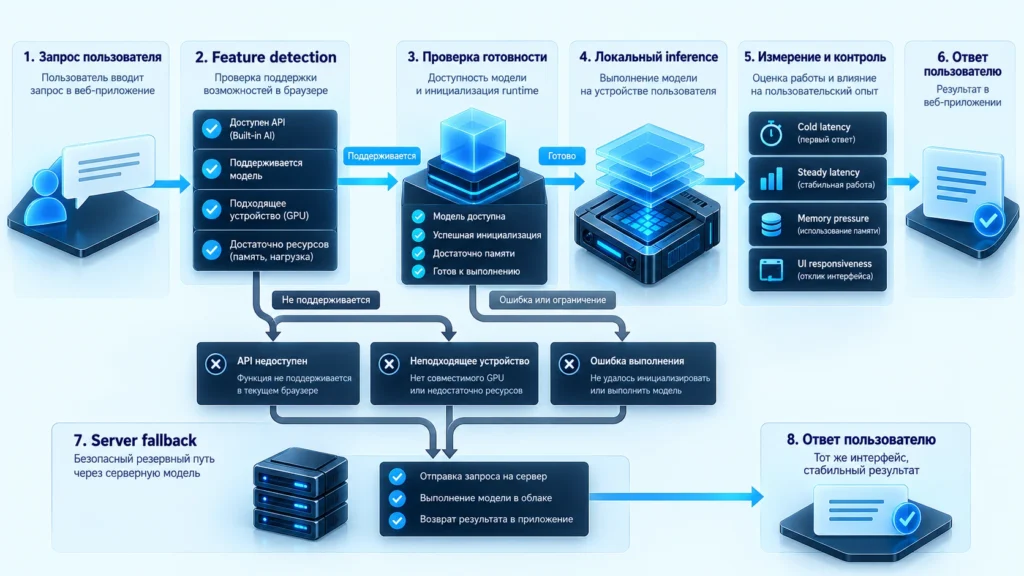
Для такого сценария Chrome Summarizer API доступен в stable начиная с Chrome 138. Перед использованием документация требует feature detection, затем проверку Summarizer.availability(). Модель может потребовать отдельной загрузки, поэтому UI должен уметь показывать это состояние, а не зависать в ожидании неизвестной операции.
Минимальная схема может выглядеть так:
async function summarizeLocally(text) {
  if (!('Summarizer' in self)) {
    return summarizeOnServer(text);
  }

  const availability = await Summarizer.availability({
    type: 'key-points',
    format: 'markdown',
    length: 'short',
  });

  if (availability === 'unavailable') {
    return summarizeOnServer(text);
  }

  const summarizer = await Summarizer.create({
    type: 'key-points',
    format: 'markdown',
    length: 'short',
    monitor(monitor) {
      monitor.addEventListener('downloadprogress', ({ loaded }) => {
        updateDownloadProgress(loaded);
      });
    },
  });

  return summarizer.summarize(text);
}
Для production этого недостаточно. Нужна минимум ещё одна ветка ошибок вокруг create() и summarize(), timeout на собственном уровне продукта, отмена устаревшей операции при смене документа и понятное состояние интерфейса.
Важно и то, что наличие глобального Summarizer ещё не гарантирует готовность модели. Проверка поддержки API и проверка availability() отвечают на разные вопросы.
Google указывает для API, использующих foundation model, конкретные desktop requirements: Windows 10/11, macOS 13+, Linux или Chromebook Plus; на текущей странице Chrome Android и iOS для этой группы API не заявлены как поддерживаемые. Для GPU указано требование более 4 GB VRAM, а для CPU-пути — 16 GB RAM и минимум четыре CPU cores. Эти условия меняются вместе с реализацией Chrome, поэтому их нельзя зашивать в собственную бизнес-логику как вечную константу.
Что измерять вместо одного красивого benchmark
Первый показатель — cold latency: время от действия пользователя до первого реально доступного результата, когда модель или runtime ещё не подготовлены. Сюда могут войти model download, initialization, compilation и выделение памяти.
Второй — steady-state latency: повторный запуск после прогрева. Именно этот показатель чаще выглядит впечатляюще в демо, но сам по себе плохо описывает пользовательский опыт первого запуска.
Третий — память. Нужно измерять не размер файла модели, а пиковое потребление процесса во время реального workload. На слабом устройстве функция может быть быстрой в изолированном тесте и одновременно вытеснять другие ресурсы страницы.
Четвёртый — responsiveness интерфейса. Пользователь не должен получать быстрое AI-резюме ценой зависшего scroll, input lag или крупных long tasks.
Пятый — процент реально поддерживаемых устройств. Если локальный путь работает только на части desktop-аудитории, server fallback остаётся частью основной архитектуры, а не временной заглушкой.
Шестой — качество результата. Локальное выполнение не делает генеративный ответ автоматически правильным. Для Summarizer стоит проверять сохранение ключевых фактов, отсутствие добавленных утверждений и устойчивость на тех типах текстов, с которыми работает конкретный продукт.
Локальный runtime не отменяет архитектуру приложения
On-device AI часто подают как выбор «локально или в облаке», но в веб-приложении практичнее рассматривать несколько execution paths одновременно.
Небольшая операция над чувствительным текстом может хорошо подходить встроенному browser AI. Собственная специализированная модель может выполняться через LiteRT/WebGPU. Более тяжёлая модель или неподдерживаемое устройство отправит задачу на сервер. Один продукт способен использовать все три варианта в зависимости от возможности устройства и характера данных.
В той же архитектуре локальный semantic retrieval может быть отдельным слоем. Например, локальный мультимодальный поиск через EmbeddingGemma 2 отвечает за получение релевантных объектов, а генеративная модель — за дальнейшую работу с выбранным контекстом. Это две разные задачи, и объединять их в одну абстрактную «локальную нейросеть» не стоит.
Если подобный AI-контур становится частью продукта, архитектура веб-приложения и техническая доработка сайта должны учитывать fallback, загрузку ресурсов, состояние интерфейса и ограничения клиентского устройства ещё до подключения конкретной модели.
Ограничения ML Drift, о которых нельзя забывать
Открытый runtime не означает одинаковую поддержку любой модели на любом GPU.
Даже официальная документация LiteRT.js отдельно рассматривает ошибки неподдерживаемых операций, различия coverage между CPU и hardware backends, ограничения tensor types и ситуации, когда модель слишком велика для среды выполнения. Перед интеграцией необходимо проверить не только то, что модель конвертируется, но и то, что нужный граф корректно исполняется на целевом accelerator.
Второе ограничение — backend не превращает слабое устройство в мощное. ML Drift может уменьшать overhead и эффективнее использовать доступное железо, но физическая память, bandwidth и вычислительные блоки устройства остаются конечными.
Третье — оптимизация зависит от workload. Улучшение decode не гарантирует такого же выигрыша в prefill. Ускорение vision-модели не переносится автоматически на LLM. Результат на одном GPU не становится характеристикой другого.
Четвёртое — уровень абстракции не нужно пробивать без причины. Разработчику обычного приложения разумнее начинать с LiteRT или browser API. Прямые C++ API ML Drift нужны прежде всего тогда, когда действительно требуется собственный GpuModel, нестандартный shader или управление execution graph ниже стандартного runtime. Google сама разделяет эти пути на application developers через LiteRT accelerator и GPU/system engineers через standalone ML Drift APIs.
Что происходит с прежним TFLite GPU delegate
Google называет ML Drift преемником legacy GPU delegate TensorFlow Lite. После запуска ML Drift старый delegate больше не должен получать новые feature updates, а разработчикам рекомендуется переходить на LiteRT ML Drift GPU accelerator.
Это не повод механически менять runtime в production без тестов. Миграцию имеет смысл проверять тем же способом, что и любую другую замену вычислительного backend:
- одинаковая модель и входные данные;
- корректность outputs относительно reference path;
- cold initialization;
- repeated inference;
- peak memory;
- энергопотребление на мобильном устройстве;
- устойчивость на нескольких GPU и версиях драйверов;
- поведение при unsupported operation или нехватке памяти.
Главное изменение ML Drift не в том, что «AI теперь работает на GPU». GPU inference существовал и раньше. Существеннее попытка Google сделать один execution layer пригодным одновременно для классических моделей, generative workloads и нескольких GPU API, а затем использовать этот слой внутри более высокоуровневых продуктов вроде LiteRT и Chrome AI runtime.
Для веб-разработчика это делает локальный AI практичнее, но не отменяет инженерную проверку. Реальный production-контур всё ещё начинается с feature detection и заканчивается измерением того, что видит пользователь: сколько он ждёт при первом запуске, сколько памяти занимает функция, остаётся ли интерфейс отзывчивым и что происходит на устройстве, где локальный inference недоступен.
FAQ
Что важно понимать перед внедрением ML Drift и локального AI
Нет. ML Drift — GPU compute/inference engine. Он исполняет вычислительные графы моделей и оптимизированные GPU-операции, но сам не является LLM, embedding-моделью или аналогом Gemini.
Нет. При использовании Chrome Built-in AI сайт работает с браузерным API, а модель, runtime и аппаратное выполнение управляются Chrome. Google сообщает, что ML Drift интегрирован во внутреннюю AI runtime infrastructure Chrome, но веб-приложение не управляет им напрямую.
Нет. WebGPU — низкоуровневый веб-интерфейс к GPU. ML Drift — inference/runtime-слой, который среди прочего имеет WebGPU backend и скрывает от более высоких уровней часть различий между GPU API и устройствами.
Нет. Результат зависит от устройства, backend, размера модели, первого запуска, памяти, состояния кэша и характера задачи. Для продукта нужно отдельно сравнивать cold и steady-state сценарии с сетевым fallback.
Нет. Их корректно использовать только вместе с указанной моделью, устройством, режимом quantization, длиной prefill/decode и другими условиями теста. Производительность своей системы нужно измерять на целевых устройствах.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.