SEO crawler помогает понять, что происходит между публикацией страницы и её возможным появлением в поиске. Но здесь важно сразу разделить два понятия: поисковый crawler получает страницы для поисковой системы, а диагностический crawler вроде Screaming Frog SEO Spider обходит сайт по внутренним ссылкам и собирает технические данные для специалиста.
Оба могут обнаружить URL, увидеть код ответа, ссылки и часть метаданных, но только поисковая система решает, будет ли документ обработан, выбран как основная версия и включён в её индекс. Поэтому ситуация «crawler открыл страницу без ошибок» и ситуация «страница индексируется» — не одно и то же.
SEO crawler: где заканчивается обход и начинается индексирование
Для поисковой системы путь документа удобнее рассматривать как цепочку:
обнаружение URL → запрос робота → HTTP-ответ → обработка документа → выбор основной версии → возможность попадания в индекс → показ по подходящим запросам.
URL поисковик может обнаружить по внутренней или внешней ссылке, Sitemap и другим известным ему источникам. После обнаружения робот может запросить документ, но даже успешный ответ сервера не гарантирует следующий этап.
Google официально разделяет crawling, indexing и serving. Яндекс также описывает отдельные стадии обхода, загрузки и обработки данных, формирования базы страниц и выдачи результатов. Именно поэтому число URL, которые робот посетил, может быть выше количества страниц, реально участвующих в поиске.
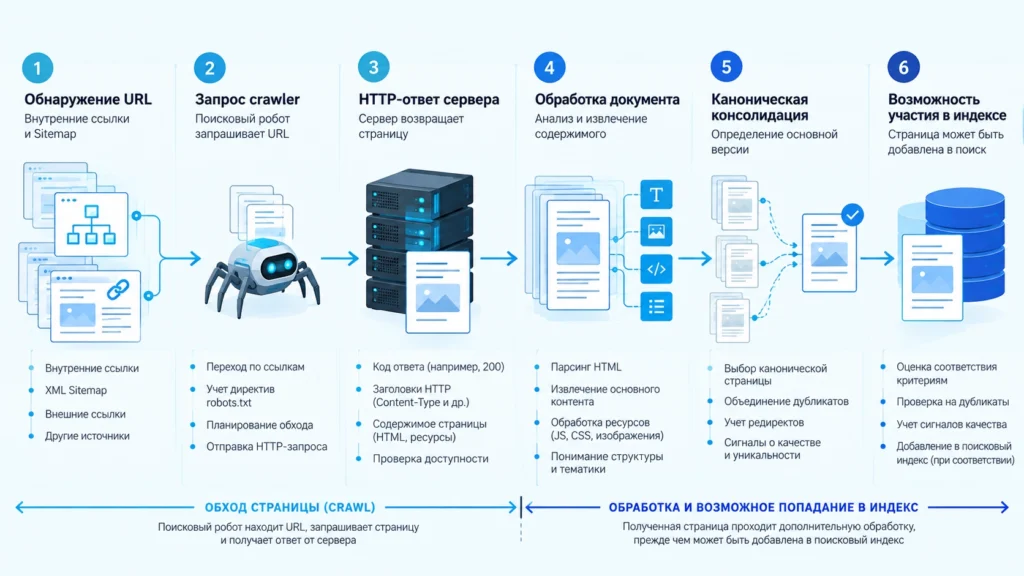
Это различие важно и для технического SEO. Успешный 200 OK означает, что сервер смог отдать документ, но не означает «страница проиндексирована». С другой стороны, ошибочный 4xx, постоянный 5xx, блокировка доступа или отсутствие содержимого способны остановить процесс ещё раньше.
Диагностировать нужно не «индексацию вообще», а конкретный слой
Самая полезная проверка — пройти путь URL сверху вниз и найти первую стадию, на которой фактический результат перестаёт совпадать с ожидаемым.
| Что проверяем | Нормальное состояние | Что искать при проблеме |
|---|---|---|
| Обнаружение URL | на страницу есть доступный путь | сиротская страница, отсутствующие внутренние ссылки |
| HTTP | конечная страница отвечает 200 | 3xx-цепочки, 4xx, 5xx, soft 404 |
robots.txt | нужный URL разрешён для обхода | случайный Disallow |
| robots meta/header | индексирование не запрещено | noindex в HTML или X-Robots-Tag |
| Canonical | указывает на ожидаемую основную страницу | canonical на другой URL, конфликт сигналов |
| Sitemap | содержит актуальный индексируемый URL | старый, редиректящий или ошибочный адрес |
| Содержимое | основной материал доступен роботу | пустой HTML, ошибки JS, заглушка |
| Поисковая система | URL обработан как ожидается | дубль, другой canonical, исключение из индекса |
Проверять только Sitemap недостаточно. Карта сайта помогает сообщить поисковой системе о нужных URL, но сама по себе не заставляет индексировать документ. Аналогично внутренний SEO crawler может показать идеальную техническую страницу, но не знает окончательного решения поискового индекса.
Что проверить в HTTP и исходном документе
Быструю диагностику можно начать непосредственно с ответа сервера:
curl -I https://example.com/page/Для индексируемой HTML-страницы ожидается корректный конечный ответ. После этого полезно посмотреть инструкции для роботов и canonical:
curl -s https://example.com/page/ \
  | grep -iE 'robots|canonical'
Если есть доступ к серверу, следующий источник фактов — access-log:
grep -E 'Googlebot|YandexBot' /var/log/nginx/access.log \
  | grep '/page/'
Логи позволяют отделить предположение «робот должен был прийти» от реального запроса к URL. При этом один только User-Agent нельзя считать доказательством подлинности поискового робота: его можно подделать.
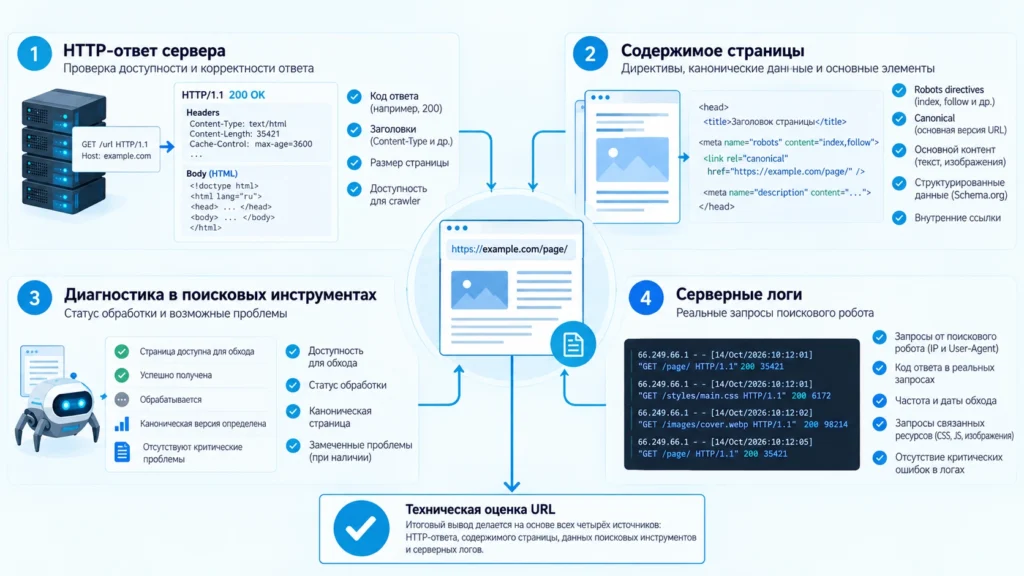
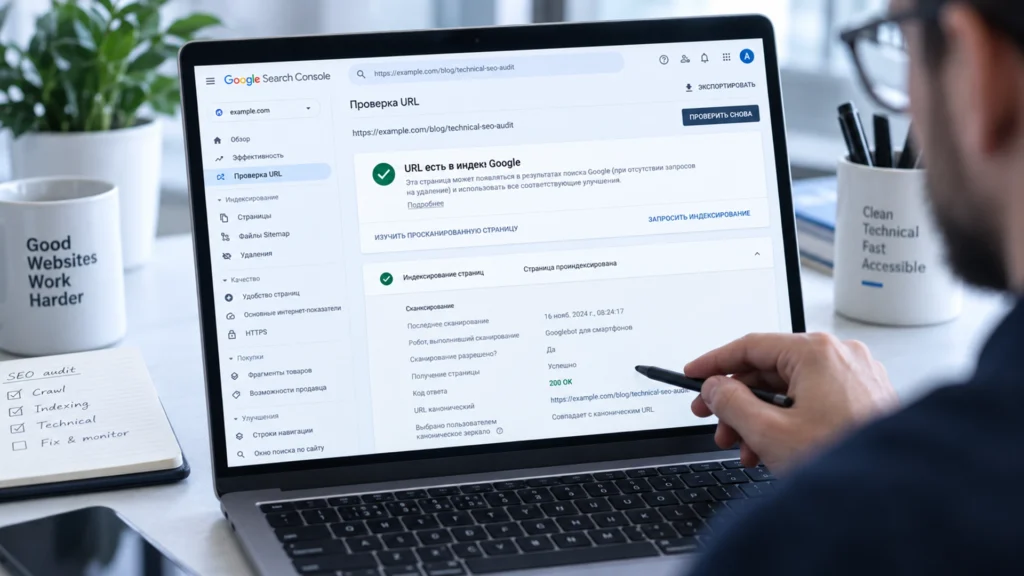
Для Google отдельный URL имеет смысл проверять через URL Inspection: инструмент показывает сведения о проиндексированной версии и позволяет протестировать опубликованную страницу. Но live-тест отвечает прежде всего на вопрос, может ли Google получить URL сейчас. Он не способен гарантировать последующее индексирование и не воспроизводит все решения, принимаемые во время обработки документа.
В Яндекс Вебмастере аналогично полезно сопоставлять проверку ответа сервера, правила robots.txt, сведения об обходе и статус страницы в поиске. Сам факт присутствия URL в истории обхода не означает, что он обязан участвовать в выдаче.
Crawled — currently not indexed: почему повторный crawl не решает проблему
Статус Crawled — currently not indexed особенно хорошо показывает разницу между обходом и индексом. В Search Console он означает, что Google уже загрузил страницу, но не добавил её в индекс на момент формирования данных.
Поэтому бессмысленно начинать с бесконечных запросов на повторное индексирование. Официальная справка Google прямо указывает, что для этого статуса повторно отправлять URL на crawl не требуется.
Проверять стоит другое:
- действительно ли нужный URL является самостоятельной страницей, а не вариантом уже существующего документа;
- совпадает ли заявленный canonical с тем URL, который должен участвовать в поиске;
- нет ли практически одинаковых страниц под другими адресами;
- есть ли на документ нормальные внутренние ссылки;
- доступен ли основной контент после рендеринга;
- отличается ли страница содержательно от уже имеющихся материалов;
- не является ли проблема массовой для одного шаблона, раздела или типа URL.
Canonical при этом нельзя воспринимать как безусловную команду поисковой системе. Для Google это один из сигналов выбора основной версии, и поисковик может определить другой canonical.
Что показывает Screaming Frog и другие SEO crawler
Диагностический crawler особенно полезен для массовой проверки сайта. Он позволяет быстро собрать URL по внутренним ссылкам, увидеть статусы ответа, редиректы, canonical, метаданные, глубину страниц и ошибки перелинковки.
Например, Screaming Frog SEO Spider в обычном Spider Mode начинает обход со стартового адреса и продолжает переходить по найденным внутренним ссылкам. Для сайтов, где критический контент появляется после выполнения JavaScript, доступен отдельный режим рендеринга.
Но результат такого обхода нельзя читать как копию Googlebot или Яндекс-робота. Локальный crawler отвечает на вопрос «что обнаружил и получил этот инструмент с такими настройками», а Search Console, Вебмастер и серверные логи — на вопрос «что происходило с конкретной поисковой системой».
Практический сценарий: страница отдаёт 200, но не появляется в поиске
Представим опубликованный материал, который открывается пользователю и возвращает 200 OK, но в поиске его нет.
Первый шаг — убедиться, что страница действительно доступна для crawl. Затем проверить robots.txt, noindex, canonical и конечный URL после редиректов. Если технических запретов нет, нужно сравнить страницу с URL, который поисковик считает основной версией, и проверить внутренние ссылки на материал.
Дальше полезно посмотреть серверные логи. Если Googlebot или робот Яндекса страницу уже посещал, причина находится не на стадии обнаружения. Если Search Console одновременно показывает Crawled — currently not indexed, повторный запрос URL не устраняет саму причину: нужно оценивать содержимое, дубли и сигналы canonical.
Если же нужного URL нет ни в логах, ни в данных обхода, диагностика возвращается на уровень discovery: внутренняя архитектура, доступные ссылки, Sitemap и ограничения crawler.
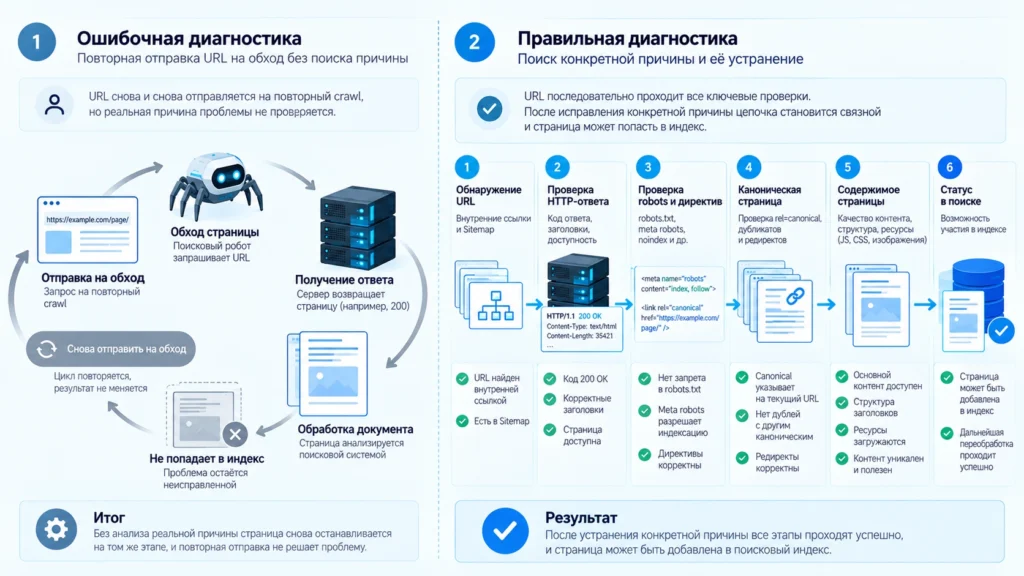
После устранения причины уже имеет смысл ускорить индексацию на практике: сообщить поисковой системе об обновлённом важном URL и дождаться нового обхода. Критерий успеха — не нажатая кнопка переобхода, а новый корректный запрос робота и ожидаемое изменение статуса страницы.
Когда проблема находится не в одной странице
Если из индекса выпадает сразу большая группа URL, проверять их по одному малоэффективно. Сначала ищите общий признак: один шаблон, каталог, тип записи, правило robots, canonical, параметры URL, JavaScript-рендеринг или период серверных ошибок.
Здесь особенно полезно объединять данные технического crawler с поисковыми консолями и логами сервера. Например, crawler способен обнаружить сотни страниц с одинаковым canonical, а Search Console покажет, как Google фактически консолидировал эти URL. Логи позволяют понять, насколько активно робот обращался к проблемному разделу.
Если проблема охватывает архитектуру сайта, шаблоны и большое число посадочных страниц, уместно рассматривать SEO-продвижение сайта с технической диагностикой. В таком случае задача состоит не в простом запуске crawler, а в сопоставлении обхода, индексирования, внутренней структуры и поискового спроса.
Главный критерий исправления прост: нужный URL должен быть обнаруживаемым, доступным, возвращать корректный документ, не конфликтовать с правилами индексирования и передавать поисковой системе согласованные сигналы о своей основной версии. Но даже после выполнения этих условий нельзя обещать автоматическое включение страницы в индекс или рост позиций — обход лишь создаёт техническую возможность для дальнейшей обработки.
FAQ
Когда робот страницу видит, а в поиске её всё равно нет
Это программа, которая переходит по URL и собирает данные о страницах сайта. Поисковые crawler вроде Googlebot и роботов Яндекса используют обход как одну из стадий работы поиска, а диагностические инструменты вроде Screaming Frog имитируют обход для технического аудита. Диагностический crawler сам не добавляет страницы в индекс поисковой системы.
Сам факт обхода не является гарантией высоких позиций. Страница сначала должна быть обнаружена, успешно загружена и обработана, после чего поисковая система может включить её в индекс. Уже затем к показу по конкретному запросу применяются отдельные механизмы ранжирования.
Проверьте HTTP-код, правила robots.txt, meta robots или X-Robots-Tag, canonical и доступность основного содержимого. Для Google используйте URL Inspection и отчёты Search Console, для Яндекса — проверку ответа сервера, анализ robots.txt и данные об индексировании. Серверные access-логи дополнительно показывают реальные обращения роботов к URL.
Google уже обошёл URL, но пока не добавил его в индекс. В официальной справке Search Console этот статус не трактуется как обязательная техническая ошибка, а повторная отправка URL на обход сама по себе не требуется. Стоит проверить canonical, дублирование, содержимое страницы, внутренние связи и общую ценность URL относительно других страниц сайта.
Это недоступные URL, 4xx и 5xx, лишние редиректы, случайный noindex, блокировки robots.txt, неправильные canonical, слабая внутренняя связность и различия между исходным HTML и отрендеренным содержимым. Но наличие ошибки в диагностическом crawler ещё нужно сопоставить с тем, что фактически видит конкретная поисковая система.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.