Яндекс Wordstat прекрасен, когда нужно проверить несколько запросов. Открыли сервис, ввели ремонт холодильников, посмотрели связанные формулировки, переключили регион, выгрузили данные и пошли дальше. Для десяти запросов никакого специального парсера вообще не требуется — быстрее сделать руками, чем выбирать способ автоматизации.
Ситуация меняется, когда исходных направлений уже не десять.
Представим интернет-магазин бытовой техники. Нужно изучить спрос по холодильникам, стиральным машинам, пылесосам, кофемашинам, телевизорам, брендам, размерам, технологиям и десяткам других свойств. Вместо двадцати исходных фраз появляется тысяча. Для каждой нужно открыть результаты, собрать дополнительные запросы, перейти к следующей фразе и при этом каким-то образом не потерять место, на котором вы остановились вчера вечером.
В этот момент работа SEO-специалиста постепенно превращается в эксперимент: сколько раз взрослый человек способен нажать «Показать ещё» до того, как начнёт серьёзно переосмысливать выбор профессии.
Именно эту механическую часть я и автоматизировал в Wordstat Collector.
Что сам Wordstat уже умеет без каких-либо расширений
Сначала важно не придумывать проблему, которой нет. Современный Wordstat сам по себе является довольно мощным инструментом. Яндекс позволяет смотреть топ популярных и похожих запросов, историю спроса, региональное распределение и данные по типам устройств. Отчёты можно выгружать в CSV. В динамике доступны месяцы, недели и дни: месячная и недельная история может охватывать до пяти лет, дневная — до 60 дней.
Поэтому Collector появился не потому, что стандартный Wordstat «плохой» или чего-то принципиально не умеет.
Проблема возникает на уровне масштаба.
Есть большая разница между задачами:
посмотреть спрос по фразе
замена розетки
и:
последовательно проверить 700 исходных направлений и собрать из каждого максимум связанных поисковых формулировок.
В первом случае интерфейс Wordstat идеален. Во втором основные расходы уже состоят не в сложной аналитике, а в количестве одинаковых действий человека.
Где ручная работа начинает проигрывать автоматизации
Представим сайт электрика. Есть десять услуг, несколько типичных неисправностей и один город. Можно вручную проверить:
электрик
замена розетки
ремонт проводки
установка автомата
подключение электроплиты
и ещё несколько формулировок. Никакой трагедии не происходит.
Теперь представим контентный сайт про бытовую технику. Нужно исследовать темы:
холодильник не
почему холодильник
как холодильник
стиральная машина не
почему стиральная машина
как почистить стиральную машину
и сотни аналогичных веток.
Человеку приходится для каждой seed-фразы повторять один и тот же цикл: открыть запрос, дождаться выдачи, раскрыть дополнительные результаты, сохранить данные, перейти к следующей фразе. Работа технически проста, но плохо масштабируется.
А именно такие задачи и лучше всего отдавать автоматике. Не потому, что компьютер умнее человека, а потому, что человеку совершенно необязательно доказывать свой интеллект, четыреста раз выполняя одинаковое действие.
Зачем я сделал Wordstat Collector
Мне нужен был инструмент не для того, чтобы заменить Wordstat собственной базой данных, а для того, чтобы снять с человека повторяющиеся действия внутри нормального рабочего процесса.
Источник спроса остаётся тем же — Яндекс Wordstat.
Меняется способ работы.
Вместо последовательности:
ввёл seed → открыл результаты → нажал «ещё» → сохранил → ввёл следующий seed
появляется очередь.
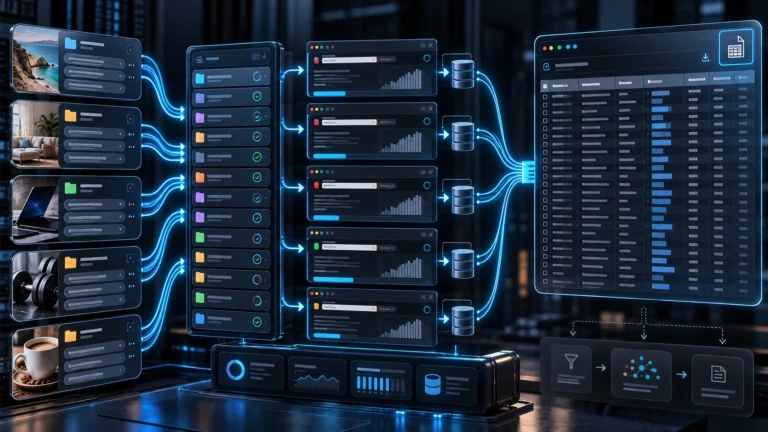
Человек заранее определяет исходные направления, после чего Collector проходит по ним автоматически, сохраняет состояние и отдаёт результат для следующего этапа анализа.
Это принципиально важное разделение. Я не пытался автоматизировать решение:
нужна ли сайту отдельная страница под этот запрос?
Я автоматизировал другое:
собери мне исходные данные, чтобы я мог это решение принять.
Что такое Wordstat Semantic Collector — Vagizov
Wordstat Semantic Collector — Vagizov — браузерное расширение для массового сбора поисковых запросов из Яндекс Wordstat.
В текущей публичной версии расширение поддерживает:
- очередь seed-фраз;
- 1–4 параллельных потока;
- автоматическое раскрытие дополнительных результатов;
- паузу и продолжение;
- пропуск отдельного задания;
- сохранение прогресса;
- экспорт результатов в CSV.
Именно эти возможности указаны в публичной карточке расширения Chrome Web Store. Там же разработчиком заявлено, что расширение не собирает и не использует пользовательские данные.
Установить расширение: Wordstat Semantic Collector — Vagizov в Chrome Web Store
Это и есть официальный публичный инструмент, о котором идёт речь в этой статье.
Почему очередь важнее красивой кнопки «Парсить»
Большая задача редко состоит из одной фразы.
Допустим, нужно исследовать спрос по ремонту холодильников. Можно подготовить:
ремонт холодильника
холодильник не морозит
холодильник шумит
холодильник течет
ремонт компрессора холодильника
заправка холодильника
замена термостата
и десятки других направлений.
Если вводить их руками, человек сам становится очередью заданий.
Collector позволяет сформировать очередь заранее. После этого процесс уже не зависит от того, помнит ли специалист, что он вчера дошёл до строки №187.
Это особенно полезно в длинных сборах. Через несколько сотен seed-фраз сохранение рабочего состояния становится намного ценнее ещё одной красивой диаграммы в интерфейсе.
Почему в Collector 1–4 потока, а не 128
Параллельность помогает ускорить обработку, но у неё есть простая физика: четыре одновременные операции создают большую интенсивность запросов, чем одна.
Поэтому максимальная скорость не должна быть самоцелью.
Можно было бы сделать кнопку:
SEO ULTRA TURBO — 128 потоков.
Название выглядело бы прекрасно.
Практический результат мог бы оказаться значительно менее праздничным.
Любой внешний сервис имеет ограничения, временные ошибки и защитные механизмы. В официальном Wordstat API, например, отдельно существуют общая квота и персональные ограничения по числу запросов в секунду и сутки. При превышении персональной квоты API возвращает 429, а при общей перегрузке сервиса возможен 503.
Браузерная автоматизация и API устроены по-разному, но инженерный принцип одинаковый: если система начинает ограничивать слишком агрессивный поток, бессмысленно считать максимальную параллельность главным показателем качества парсера.
Поэтому 1–4 потока — это управляемый диапазон, а не соревнование за самое большое число в настройках.
Почему сохранение прогресса важнее, чем кажется
Допустим, вы запустили 1 500 seed-фраз.
Инструмент работает несколько часов.
Потом браузер закрылся, соединение оборвалось или на одном из заданий возникла проблема.
Если программа не хранит состояние, есть два варианта: начать весь процесс заново или вспоминать вручную, какие строки уже обработаны.
Оба варианта довольно быстро объясняют, зачем существует resume.
В больших автоматизированных задачах надёжность обычно важнее секундной скорости. Хороший collector должен уметь не только быстро начать работу, но и нормально пережить паузу, пропустить проблемное задание и продолжить с того места, где остановился.
Именно поэтому очередь, pause/resume и сохранение состояния — не дополнительные украшения интерфейса, а основа массового рабочего процесса.
Что значит «Показать ещё» в автоматическом режиме
В Wordstat одна исходная формулировка способна привести к целой ветке связанных запросов. При ручной работе пользователь постепенно раскрывает результаты и переносит найденные фразы дальше.
Collector делает эту повторяющуюся часть автоматически.
Здесь важно не спутать два разных процесса:
расширение выдачи и расширение смысла.
Инструмент способен последовательно собрать больше фраз из Wordstat. Но он не обязан автоматически считать каждую найденную строку полезной для бизнеса.
Если по seed холодильник Wordstat принёс:
ремонт холодильника
купить холодильник
холодильник авито
вакансии ремонт холодильников
холодильник своими руками
инструмент сделал свою работу правильно.
Теперь наступает работа человека: понять, какие из этих веток вообще относятся к вашему проекту.
Самая опасная метрика — «мы собрали 100 000 запросов»
Большие числа производят впечатление.
В ядре 87 423 запроса.
Звучит серьёзно.
Но сама длина CSV не является SEO-результатом.
Возьмём интернет-магазин новых холодильников в Перми. Если из 100 тысяч строк половину составляют:
- ремонт;
- запчасти;
- инструкции;
- б/у;
- Москва;
- вакансии;
- модели, которых магазин не продаёт;
то огромный массив в первую очередь сообщает, что сбор был широким.
Он пока ничего не говорит о качестве семантики.
Ценность появляется после другого вопроса:
Какая часть собранного спроса действительно соответствует бизнесу и какие решения на сайте из него следуют?
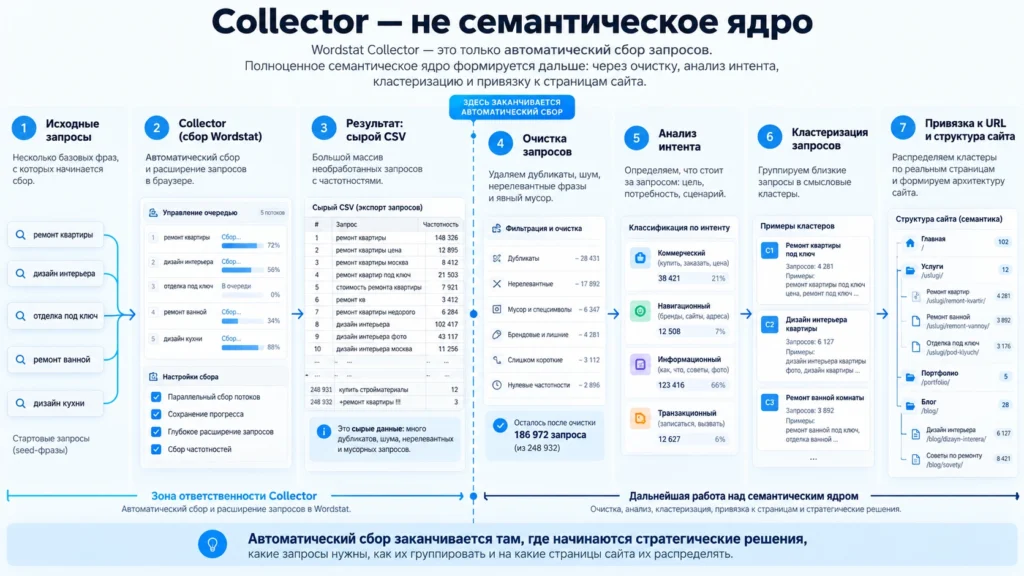
Вот здесь Wordstat Collector заканчивает свою основную работу.
CSV после Collector ещё не является семантическим ядром
Это принципиальный момент.
Есть:
сырой поисковый массив.
И есть:
рабочее семантическое ядро.
Между ними находится заметный объём работы.
После массового сбора обычно нужно убрать дубли, очистить чужую тематику и ненужные регионы, проверить частотность, определить пользовательские задачи, разделить коммерческий и информационный спрос, кластеризовать запросы и сопоставить группы с существующими или будущими URL.
Именно поэтому на Vagizov.com семантическое ядро определено не как «большой список ключей», а как структурированный набор поисковых формулировок, связанных с задачами пользователей и страницами сайта.
Подробно весь процесс после сбора разобран отдельно: как собрать, очистить и кластеризовать семантическое ядро.
Collector помогает получить сырьё быстрее.
Архитектуру сайта из него всё ещё нужно построить.
Хорошая работа начинается ещё до запуска Collector
Автоматизацию очень легко обвинить в плохом результате, хотя ошибка появилась раньше.
Например, специалист берёт seed:
ремонт.
Что именно ему нужно?
Ремонт квартиры?
Телефона?
Холодильника?
Автомобиля?
Крыши?
Wordstat честно попытается описать огромный спрос вокруг слова.
Collector так же честно автоматизирует эту задачу.
Потом человек получает десятки тысяч строк и жалуется, что половина нерелевантна.
Проблема не в Collector.
Проблема в seed.
Для магазина холодильников намного полезнее начинать с осмысленных веток:
купить холодильник
холодильник no frost
встраиваемый холодильник
узкий холодильник
двухкамерный холодильник
холодильник 60 см
холодильник [бренд]
Каждая такая seed-фраза уже описывает понятное направление.
На Vagizov.com этому посвящён отдельный материал о масках ключевых слов: исходные формулировки полезно строить из категорий, услуг, товаров, характеристик, проблем пользователей и реальной терминологии бизнеса.
Операторы не становятся ненужными после появления автоматизации
Wordstat поддерживает операторы:
-
!
+
" "
[]
()
|
Они позволяют исключать слова, фиксировать словоформу, учитывать стоп-слова, ограничивать количество слов, фиксировать порядок и объединять варианты.
Например, если вас интересует конкретное направление, минус-слова способны убрать очевидно чужие ветки ещё до того, как они попадут в огромный массив.
Это важная инженерная мысль:
автоматизация не исправляет неправильную постановку задачи — она позволяет выполнить её значительно быстрее.
Если seed плохой, четыре потока просто быстрее соберут плохой результат.
Поэтому сначала формулировка, регион и операторы.
Потом очередь.
Подробно про сами операторы и их влияние на выборку: как работают операторы Wordstat и что именно они меняют.
Регион нужно определить до массового сбора
Для локального бизнеса общероссийская статистика может быть почти бесполезна.
Допустим, электрик работает только в Перми.
Его интересует реальный локальный спрос, а не суммарная популярность темы по всей стране.
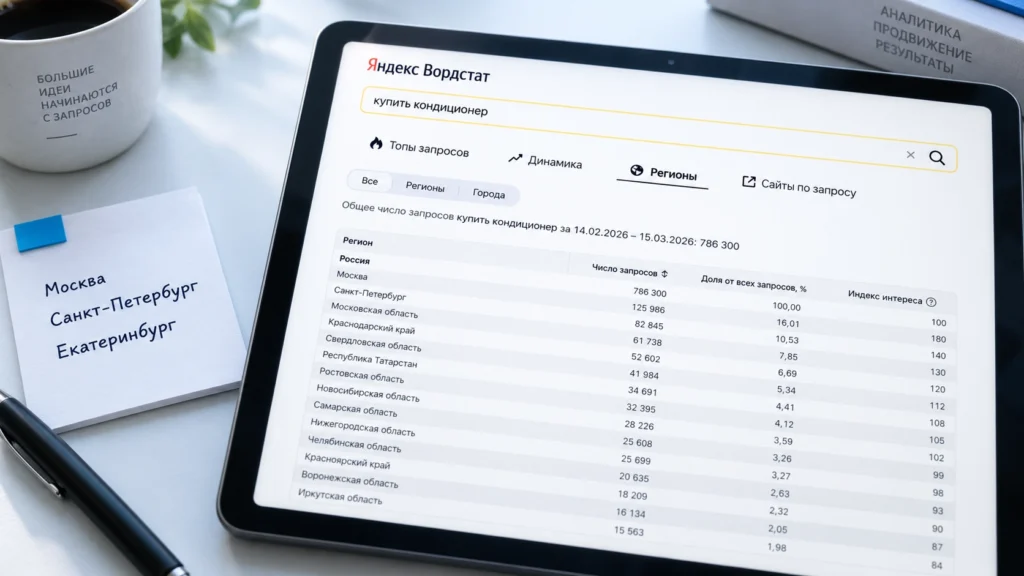
Wordstat позволяет смотреть данные по регионам и городам, а также сравнивать число запросов, долю и индекс интереса. Эти данные относятся к последним 30 дням и могут фильтроваться по устройствам.
Это важно учитывать до начала больших задач.
Собрать огромный CSV по всей России и только потом вспомнить, что услуга оказывается в одном городе, технически возможно. Практически это немного напоминает закупку продуктов для ресторана до того, как решили, что будет в меню.
Если проект локальный, сначала определяем географию.
Подробнее: как анализировать спрос Wordstat по городам и регионам.
А зачем Collector, если появился официальный Wordstat API
Очень хороший вопрос.
В 2026 году у Яндекса есть официальный Wordstat API. Он предоставляет методы для получения топа популярных и похожих запросов, динамики, регионального распределения и дерева регионов. Запросы передаются программно, ответы приходят в структурированном формате.
После выхода API в общую доступность Yandex Cloud установил следующие тарифы:
| Метод | Стоимость |
|---|---|
| GetTop | 20 ₽ / 1 000 вызовов |
| GetDynamics | 20 ₽ / 1 000 вызовов |
| GetRegionsDistribution | 50 ₽ / 1 000 вызовов |
| GetRegionsTree | бесплатно |
На первый взгляд возникает логичный вопрос:
Тогда браузерное расширение вообще зачем?
Потому что API и расширение решают разные задачи.
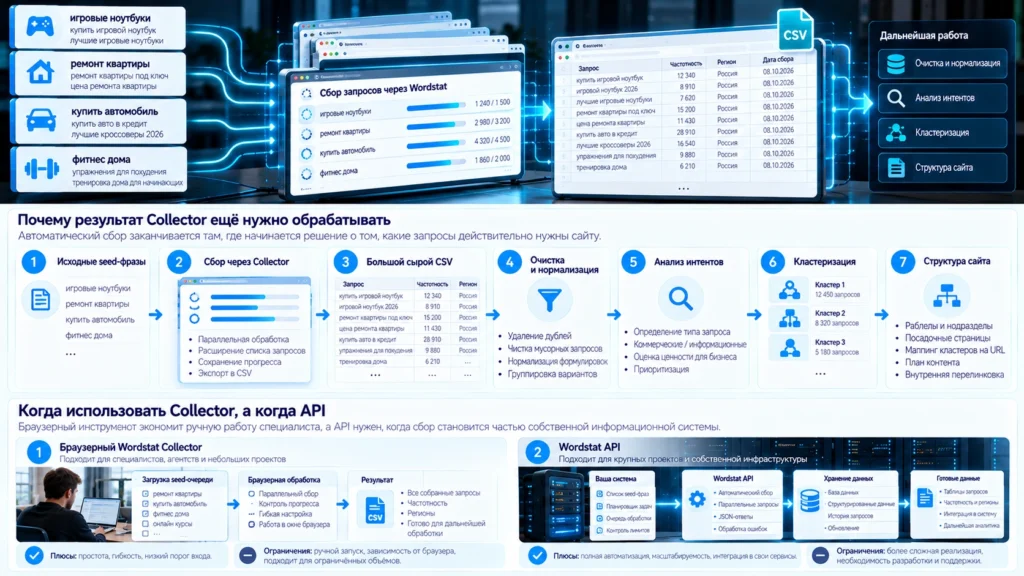
Collector удобен специалисту. API удобен системе
Представим SEO-специалиста.
У него есть 300 seed-фраз.
Он хочет:
- загрузить их;
- запустить сбор;
- получить CSV;
- продолжить работу в таблице.
Ему не обязательно для этого создавать приложение, токены, очередь заданий, базу данных, планировщик и интерфейс.
Collector закрывает именно такой рабочий сценарий.
Теперь представим веб-студию, которая каждую ночь автоматически обновляет спрос по сотням проектов, записывает результаты в БД, сравнивает динамику и сама формирует задачи.
Вот здесь расширение браузера уже выглядит как неподходящий уровень архитектуры.
Нужен API.
Он рассчитан именно на программную интеграцию.
Поэтому правильный вопрос не:
Что лучше — Collector или Wordstat API?
А:
Где выполняется задача и насколько она должна быть автоматизирована?
Для человека в браузере — Collector.
Для backend-процесса — API.
API тоже не означает бесконечную скорость
Даже у официального программного интерфейса есть квоты.
Документация Wordstat API разделяет их на общую квоту сервиса и персональные ограничения OAuth-токена. Ограничивается как число запросов в секунду, так и объём за сутки. При превышении персонального лимита возвращается 429, при общей недоступности — 503.
То есть переход на API не отменяет очередь заданий, обработку ошибок и повторные попытки.
Он просто переносит всё это из пользовательского браузера в программную инфраструктуру.
И это ещё одна причина, почему «парсер» — значительно более широкое понятие, чем кнопка запуска.
При серьёзных объёмах важны:
- очередь;
- лимиты;
- повторные попытки;
- сохранение уже полученных данных;
- контроль дубликатов;
- устойчивость после сбоя.
Скорость без надёжности прекрасно выглядит первые десять минут.
Потом наступает один 429, и начинается настоящее знакомство с архитектурой.
А что предлагают готовые платные сервисы
Собственный инструмент не существует в вакууме. На рынке давно есть профессиональные системы для работы с Wordstat, и делать вид, что их нет, было бы довольно странной формой продуктового маркетинга.
Рассмотрим несколько разных подходов.
Rush Analytics
Rush Analytics включает сбор ключевых слов и частотности Wordstat в общий набор SEO-инструментов.
На текущих тарифах подписка начинается с 500 ₽ в месяц, затем идут уровни Start — 999 ₽, Pro — 3 499 ₽ и более крупные командные тарифы. Сам сбор ключевых слов Wordstat расходует 0,05 внутреннего лимита на младших тарифах и 0,03 на старших.
Здесь пользователь платит не только за Wordstat.
Он получает целую среду:
- семантику;
- позиции;
- кластеризацию;
- поисковые подсказки;
- другие массовые SEO-инструменты.
Это хороший вариант для человека, который уже живёт внутри Rush Analytics.
Для разового сбора нескольких сотен seed-фраз возможностей может быть больше, чем нужно.
ARSENKIN TOOLS
ARSENKIN TOOLS тоже умеет массово получать ключевые слова, частотность и сезонность Wordstat. Сервис заявляет работу без необходимости самостоятельно настраивать прокси и антикапчу. Базовый тариф сейчас стоит 990 ₽ в месяц и включает 28 000 внутренних лимитов, Standard — 2 490 ₽ с 85 000 лимитов.
Для парсинга ключевых фраз Wordstat операция расходует 2 лимита, а максимальное число масок одной задачи зависит от тарифа: до 50, 250 или 500.
Опять же, это уже не один инструмент.
Это полноценная SEO-платформа.
Key Collector
Key Collector использует другую модель.
Это desktop-программа для постоянной работы с семантикой.
Первая бессрочная лицензия для физического лица сейчас стоит 2 200 ₽, для организации — 2 300 ₽. Лицензия привязана к одному компьютеру, включает обновления и поддержку.
Главное различие здесь даже не в цене.
Key Collector — большой профессиональный инструмент для семантических процессов, а не небольшое расширение под одну конкретную механическую операцию.
Если человек ежедневно работает с огромными ядрами, ему может быть нужен именно такой комбайн.
Если нужно убрать ручное «Показать ещё» из Wordstat — задача значительно уже.
Сравнение вариантов
| Вариант | Стоимость входа | Основная модель | Когда разумно использовать |
|---|---|---|---|
| Wordstat вручную | 0 ₽ | ручная работа | несколько запросов |
| Wordstat Collector — Vagizov | отдельная подписка в карточке не заявлена | browser automation | десятки и сотни seed-фраз |
| Wordstat API | от 20 ₽ / 1 000 вызовов | программный API | серверная автоматизация |
| Rush Analytics | от 500 ₽/мес. | SEO SaaS | постоянная работа с несколькими инструментами |
| ARSENKIN TOOLS | от 990 ₽/мес. | SEO SaaS | массовая семантика и API |
| Key Collector | от 2 200 ₽ разово | desktop software | регулярная профессиональная работа |
Цель таблицы не выбрать чемпиона.
У каждого решения разный масштаб.
Если нужно проверить 15 запросов, лучший инструмент называется «обычный Wordstat».
Если нужно прогнать очередь из нескольких сотен направлений и продолжить работу в CSV, browser Collector становится удобным.
Если нужно обновлять данные автоматически каждый день без участия человека — пора смотреть на API.
Может ли ChatGPT заменить Wordstat Collector
Нет — если речь идёт именно о получении статистики Wordstat.
ChatGPT способен отлично помочь на соседних этапах.
Например, перед сбором можно попросить сформировать логическую карту seed-фраз для магазина диванов:
- тип;
- форма;
- материал;
- размер;
- механизм;
- цвет;
- назначение.
После выгрузки ChatGPT может помочь классифицировать найденные запросы, найти очевидный мусор или подготовить предварительные группы.
Но если вопрос звучит:
сколько реальных запросов в Яндексе связано с этой формулировкой в конкретном регионе?
ответ должен приходить из поисковых данных Яндекса, а не из языковой модели.
Поэтому я воспринимаю AI и Wordstat не как конкурентов, а как соседние компоненты процесса.
Нормальная цепочка может выглядеть так:
бизнес → seed-фразы → Wordstat Collector/API → реальные запросы → AI-очистка → SERP-кластеризация → страницы сайта.
На предыдущем этапе мы подробно разбирали, почему AI хорошо понимает смысл запросов, но не заменяет реальную поисковую выдачу при кластеризации.
Практический пример: сайт электрика
Допустим, нужно развивать сайт частного электрика.
Начинаем не с одной маски электрик, а с нескольких направлений:
замена розетки
ремонт проводки
установка автомата
электрик срочно
подключение электроплиты
замена выключателя
выбивает автомат
Wordstat Collector расширяет каждый seed и собирает реальные пользовательские формулировки.
Дальше может выясниться, что люди ищут:
сколько стоит заменить розетку
электрик замена розетки цена
как заменить розетку
искрит розетка что делать
выбивает автомат при включении чайника
Все фразы полезны?
Возможно.
Но по-разному.
Первые две относятся к коммерческой услуге.
Как заменить розетку — информационный материал.
Искрит розетка может стать статьёй, из которой человек поймёт, когда нужен мастер.
То есть один Collector дал сырьё сразу для:
- страницы услуги;
- статьи;
- FAQ;
- анализа пользовательских проблем.
Но он не должен сам решать, что всё это нужно запихнуть на один URL.
Практический пример: контентный сайт
Теперь предположим, что мы развиваем информационный раздел про бытовую технику.
Вместо товарных seed можно использовать проблемные конструкции:
почему холодильник
холодильник не
как холодильник
что делать если холодильник
можно ли холодильник
Wordstat начинает показывать язык реальных пользователей.
Появляются:
почему холодильник не морозит
почему холодильник шумит
можно ли ставить холодильник рядом с батареей
как правильно разморозить холодильник
что делать если холодильник течет
Из такого массива уже можно строить карту информационного спроса.
Именно здесь массовый Collector особенно интересен: не для производства гигантского списка ключей, а для обнаружения реальных вопросов, которые люди формулируют иначе, чем автор сайта придумал бы за столом.
Это существенная разница.
Автор способен придумать десять тем.
Поисковый спрос показывает сотни способов, которыми люди описывают реальные проблемы.
Wordstat Collector и SEO-продвижение
Массовый сбор Wordstat полезен только тогда, когда после него кто-то принимает решения. CSV на 50 тысяч строк не улучшает позиции сайта просто фактом своего существования; он становится ценным, когда из него выделяются реальные направления спроса, нужные страницы, новые статьи и проблемы текущей структуры.
Поэтому в рамках SEO-продвижения сайтов Wordstat и другие источники семантики используются как начальный слой анализа. После сбора мы ещё проверяем интент, SERP, существующие URL, индексацию и фактическую поисковую видимость. Автоматизировать поиск данных полезно, но архитектурное решение всё равно должно опираться на весь проект, а не на одну таблицу частотности.
Нужно ли собирать миллион запросов
Если у вас маркетплейс или огромный контентный проект — возможно.
Если у вас стоматология с двадцатью услугами в одном городе — скорее всего, нет.
Здесь действует довольно простой критерий:
Собрали ли мы достаточно данных, чтобы увидеть основные ветки спроса и принять решение о страницах?
Если ответ да, дополнительные сто тысяч строк могут дать меньше пользы, чем качественная обработка уже собранных десяти тысяч.
У SEO вообще есть забавная особенность: инструменты очень легко измеряют объём выполненной механической работы.
Намного сложнее измерить качество решения.
Поэтому отчёт:
собрано 243 000 ключевых слов
выглядит солидно.
Но владельцу бизнеса полезнее другой:
обнаружены три категории спроса, которых на сайте не было, две существующие страницы нужно объединить, а ещё четыре темы действительно заслуживают отдельных материалов.
Первое — количество данных.
Второе — работа с ними.
Где Wordstat Collector особенно полезен
Я бы выделил три ситуации.
Первая — исследование новой ниши, когда исходных направлений уже десятки или сотни и их нужно систематически расширить.
Вторая — контент-план, особенно когда важны реальные пользовательские проблемы и вопросы, а не только темы, которые редактор придумал сам.
Третья — обновление большой семантики, когда вручную повторять однотипный цикл по старым seed уже просто нерационально.
И наоборот: если задача состоит в проверке пяти запросов, открывайте обычный Wordstat. Хороший инструмент не обязан использоваться там, где он не нужен.
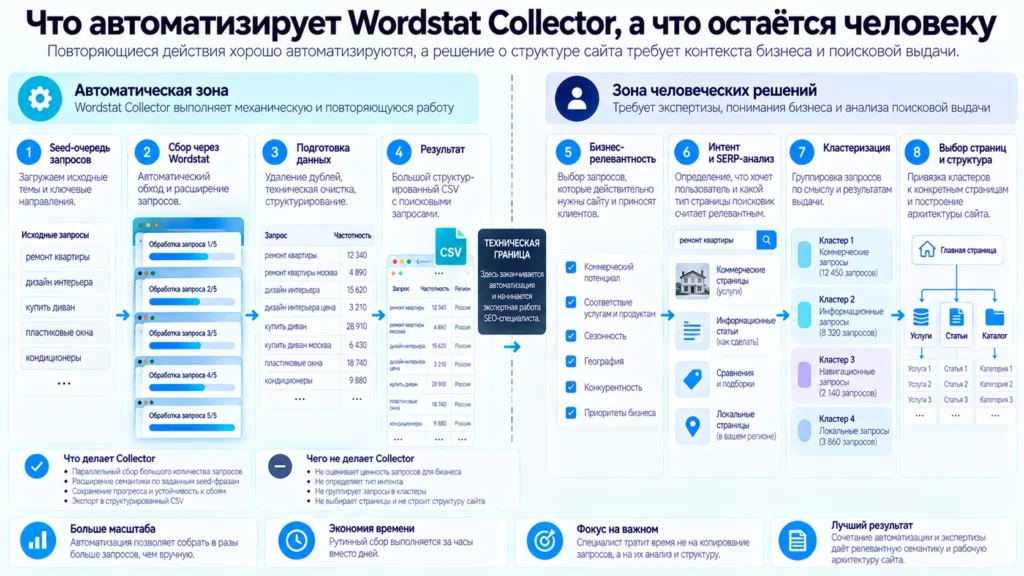
Что Wordstat Collector специально не делает
Мне кажется полезным закончить разбор именно ограничениями.
Collector не определяет автоматически:
- какую страницу создавать;
- какую страницу удалять;
- какой запрос коммерческий;
- какой интент правильный;
- что объединить;
- какой материал написать;
- сколько клиентов принесёт тема.
Он не знает ассортимент магазина, загрузку сотрудников, маржинальность услуги или планы бизнеса на следующий год.
Он делает значительно более скромную, но практичную работу:
берёт список исходных направлений и избавляет человека от необходимости вручную повторять одну и ту же операцию сбора.
Мне именно такой подход к автоматизации нравится больше всего.
Не пытаться написать программу, которая якобы «делает SEO».
А находить участки работы, где человеческое решение вообще не требуется, и отдавать машине именно их.
Итог
Wordstat Collector появился не потому, что стандартный Wordstat плох. Наоборот, источник данных остаётся тем же. Я просто не вижу большой профессиональной ценности в том, чтобы человек вручную сотни раз выполнял одинаковую последовательность действий, если её можно надёжно оформить в очередь.
Для нескольких запросов используйте обычный Wordstat.
Для десятков и сотен seed-фраз browser Collector экономит время и даёт понятный CSV для следующего этапа.
Для полностью автоматизированной серверной системы уже логичнее официальный Wordstat API.
А дальше начинается самое важное.
Собранные запросы нужно очистить, проверить по смыслу и региону, сопоставить с реальным бизнесом, кластеризовать и распределить по страницам.
Поэтому Wordstat Collector — не «SEO в один клик» и не генератор готового семантического ядра.
Это значительно более приземлённый инструмент.
Он автоматизирует работу, для которой человеку не нужно думать, чтобы у человека осталось больше времени на ту часть SEO, где думать как раз необходимо.
Установить инструмент можно здесь: Wordstat Semantic Collector — Vagizov в Chrome Web Store.
Практика
Как массово собрать запросы через Wordstat Collector
Подготовьте seed-фразы
Разделите бизнес или тему на понятные направления: товары, услуги, проблемы пользователей, характеристики и основные формулировки спроса.
Проверьте регион и формулировки
Убедитесь, что собираете данные для нужной территории и не отправляете слишком широкие или заведомо нерелевантные маски.
Загрузите очередь в Collector
Добавьте список исходных запросов и выберите разумное количество параллельных потоков.
Дайте инструменту собрать результаты
Collector последовательно обрабатывает очередь, раскрывает дополнительные результаты и сохраняет прогресс работы.
Экспортируйте CSV
После завершения выгрузите найденные запросы в таблицу для дальнейшей обработки.
Очистите и кластеризуйте результат
Удалите дубли и нерелевантные фразы, разберите пользовательские задачи, проверьте спорные группы по поисковой выдаче и распределите семантику по страницам.
FAQ
Как использовать Wordstat Collector для сбора семантики
Wordstat Collector автоматизирует массовый сбор запросов из Яндекс Wordstat. Расширение принимает очередь исходных seed-фраз, обрабатывает их в 1–4 параллельных потоках, автоматически раскрывает дополнительные результаты, позволяет поставить работу на паузу или пропустить проблемное задание, сохраняет прогресс и экспортирует результат в CSV.
Нет. Collector решает только задачу получения исходных поисковых формулировок. После выгрузки нужно удалить дубли и нерелевантные запросы, проверить регион и спрос, определить пользовательские задачи, кластеризовать семантику и сопоставить группы с существующими или будущими страницами сайта.
Collector работает непосредственно как браузерный инструмент поверх привычного Wordstat и удобен специалисту, которому нужно загрузить очередь запросов и получить CSV без разработки собственной системы. Официальный Wordstat API лучше подходит для серверной автоматизации, регулярных заданий, интеграции с базой данных и больших процессов, но требует программной реализации.
ChatGPT может помочь придумать исходные направления, очистить полученный список, классифицировать запросы и подготовить их к кластеризации, но не является источником статистики Яндекс Wordstat. Реальные данные о запросах, регионах и динамике должны поступать из Wordstat или официального API.
Нет. Большой CSV сам по себе не делает семантику качественной. Важно собрать достаточно данных, чтобы увидеть реальные направления спроса, а затем очистить их и связать с задачами бизнеса. Для небольшого сайта 100 000 строк часто означают не глубокий анализ рынка, а слишком широкий и плохо контролируемый сбор.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.