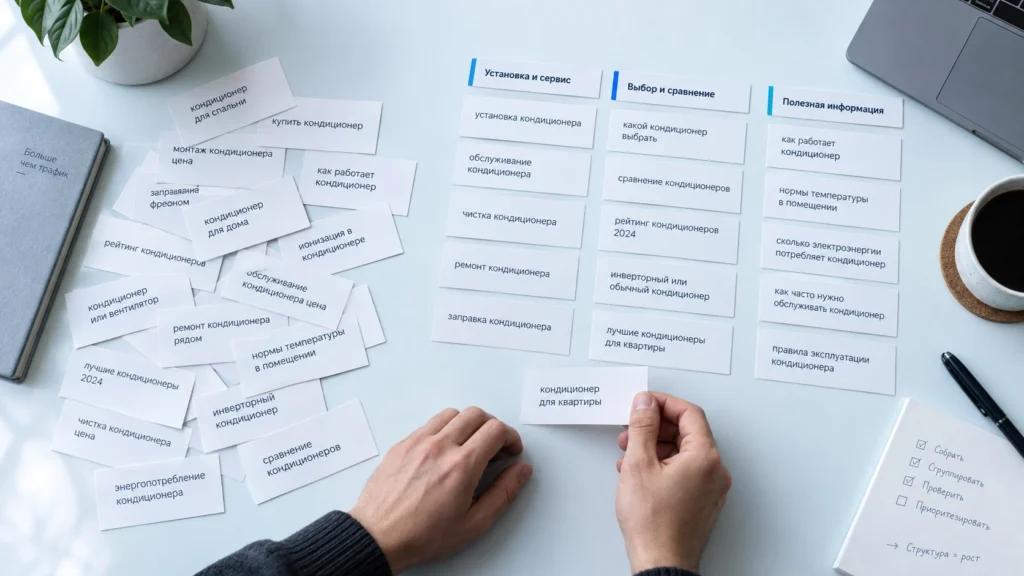
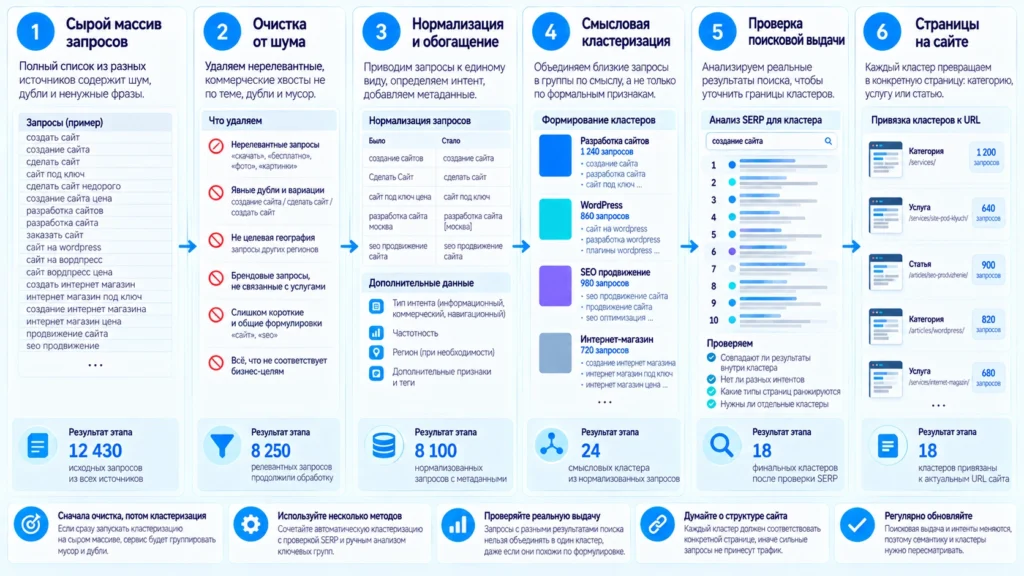
Представьте, что вы собираетесь продвигать обычный магазин холодильников. После Wordstat, поисковых подсказок, анализа конкурентов и данных собственного сайта в таблице оказалось 12 000 строк.
На первый взгляд всё прекрасно: спрос собран, работа почти сделана.
Потом вы открываете файл.
Там рядом лежат:
купить холодильник
холодильник цена
какой холодильник купить
почему холодильник не морозит
ремонт холодильника
ремонт холодильника своими руками
скачать инструкцию холодильник lg
вакансии мастер по ремонту холодильников
купить холодильник Москва
при том, что магазин работает только в Перми.
Это ещё не семантическое ядро. Это склад поисковых фраз, куда грузчики аккуратно свезли всё, что нашли.
Теперь нужно понять, какие запросы описывают одну и ту же задачу человека, какие требуют разных страниц, а какие вашему сайту вообще не нужны.
Для этого и существует кластеризация.
Но есть важная деталь: ни один кластеризатор не знает ваш бизнес лучше вас. Если загрузить в дорогой сервис 12 000 строк мусора, он не возмутится и не позвонит владельцу со словами: «Максим, вы серьёзно хотите продвигать вакансии мастеров в интернет-магазине?»
Он просто очень быстро и профессионально разложит мусор по группам.
Поэтому выбор инструмента начинается не с цены за тысячу запросов. Сначала нужно понять, что именно мы собираемся ему отдавать.
Что вообще должен сделать кластеризатор
В прикладном SEO задача довольно приземлённая:
определить, какие поисковые запросы разумно закрывать одной страницей, а какие лучше развести по разным URL.
Например:
ремонт холодильника
мастер по ремонту холодильников
ремонт холодильника на дому
очень похожи не только словами. Человек во всех трёх случаях, вероятнее всего, хочет найти исполнителя.
А:
как отремонтировать холодильник самому
говорит вроде бы о том же холодильнике, но пользователь уже достал не телефон для вызова мастера, а отвёртку.
На Vagizov.com уже отдельно разобрано, как работает кластеризация запросов и как из неё получается структура сайта. Там подробнее рассмотрены сам принцип группировки, интент и связь кластера с URL. В этой статье нас интересует следующий практический вопрос: чем именно всё это делать и сколько за это придётся платить.
Кластеризация начинается с мусорного ведра
Это не метафора ради красивой фразы.
Платить за SERP-кластеризацию запроса:
ремонт холодильников Москва
если компания физически работает только в Перми и никогда не собирается выходить в Москву, довольно странно.
Так же странно оплачивать анализ:
вакансии мастер холодильников
если сотрудники вам сейчас не нужны.
До кластеризации я бы удалил как минимум:
- точные дубли;
- случайно собранные чужие товары и услуги;
- города, в которых бизнес не работает;
- бренды, которых нет в ассортименте;
- вакансии, если они не являются целью сайта;
- запросы «скачать», «торрент», «бесплатно», если бизнес не решает такие задачи;
- омонимию и явно другую тематику;
- технический мусор после парсинга.
Причём слово «мусор» здесь относительно.
Запрос:
ремонт холодильника своими руками
является мусором для сайта мастера, который хочет получать только горячие заявки?
Не обязательно.
Из него может получиться хорошая статья, которая объяснит, какие неисправности человек способен устранить сам, а когда пора выключить холодильник и вызвать специалиста.
Для коммерческой страницы этот запрос действительно не нужен. Для информационного раздела он может быть очень полезен.
Поэтому очистка семантики — это не:
удалить всё без слова «купить».
Это проверка каждого большого сегмента относительно бизнес-задачи.
На Vagizov.com полный процесс от сбора до очистки уже разобран отдельно в материале о том, как собрать и подготовить семантическое ядро к кластеризации. Здесь не будем повторять весь цикл заново.
Очистка и нормализация — не одно и то же
Эти операции часто смешивают, хотя задачи у них разные.
При очистке мы решаем:
нужна ли эта фраза бизнесу вообще?
При нормализации:
как хранить нужные данные так, чтобы с ними было удобно работать?
Например, можно:
- убрать лишние пробелы;
- привести регистр;
- удалить точные дубли;
- сохранить частотность;
- добавить регион;
- сохранить источник;
- пометить предполагаемый интент;
- сохранить текущий URL, если сайт уже работает.
Но нельзя механически решить, что:
ремонт холодильника
и
ремонт холодильника недорого
— это один и тот же запрос и вторую строку можно выбросить.
Для будущей страницы они действительно могут попасть в один кластер. Но это не значит, что исходные данные нужно уничтожить до анализа.
Частотность, формулировка и дополнительные слова ещё пригодятся.
Четыре способа кластеризовать запросы
На практике есть четыре подхода, и ни один не обязан использоваться в чистом виде.
Ручная группировка
Человек читает список и сам собирает группы.
Для 50–200 фраз это может быть даже лучшим способом.
Ни одна автоматизация не даст огромного выигрыша, если вы можете спокойно прочитать всё ядро за вечер и хорошо знаете собственный бизнес.
Проблемы начинаются, когда строк становится 5 000, 20 000 или 100 000.
Тогда человеческий мозг после нескольких тысяч запросов начинает группировать уже не семантику, а собственную усталость.
Смысловая кластеризация
Запросы объединяются по значению.
Современные языковые модели вроде ChatGPT особенно сильны именно здесь.
Они хорошо понимают, что:
мастер холодильников
и
ремонт холодильника на дому
семантически связаны, даже если набор слов не совпадает полностью.
Кластеризация по SERP
Это классический SEO-подход.
Сервис отправляет каждый запрос в Яндекс или Google, получает, например, TOP-10 и сравнивает URL.
Если по двум запросам поисковая система часто показывает одни и те же страницы, появляется объективный аргумент в пользу того, что оба запроса можно закрывать одним документом.
Именно так устроена кластеризация у Topvisor и Rush Analytics: сервисы сравнивают пересечение URL в поисковой выдаче.
Гибридный вариант
В реальной работе мне кажется самым разумным именно он:
очистка → смысловая группировка → проверка интента → SERP для спорных случаев → ручное решение.
Почему не отдать всё поисковой выдаче автоматически?
Потому что SERP тоже не является божественным чертежом будущего сайта.
Выдача меняется, конкуренты могут иметь неидеальную архитектуру, а слишком строгие настройки способны разбить одну нормальную страницу на десяток искусственных кластеров.
Hard и Soft без диссертации по математике
Эти слова встречаются практически во всех профессиональных сервисах, поэтому понимать разницу полезно.
В Soft-кластеризации обычно достаточно, чтобы каждый новый запрос имел необходимое пересечение поисковой выдачи с главным, маркерным запросом группы.
Получаются более крупные кластеры.
В Hard требования жёстче: запросы внутри группы должны иметь общие URL между собой.
Поэтому группы обычно получаются меньше.
Topvisor описывает именно такую разницу и рекомендует в качестве стартового варианта протестировать Hard со степенью примерно 3–4, одновременно подчёркивая, что параметры зависят от тематики. Более того, в течение семи дней сервис позволяет дешёво изменить метод и степень, потому что одного универсального значения нет. (topvisor.com)
Представим снова холодильники.
Есть:
ремонт холодильника
ремонт холодильника на дому
ремонт морозильника
Soft может собрать их вместе, если каждый запрос достаточно похож выдачей на основной.
Hard способен разделить морозильники в отдельную группу, если пересечения недостаточно.
Кто прав?
Не алгоритм.
Открываем выдачу и смотрим, какие страницы реально преобладают, а затем учитываем бизнес.
Если компания ремонтирует холодильники и морозильные камеры одной бригадой, на одной странице полноценно описывает обе услуги и SERP это поддерживает — отдельный URL может быть не нужен.
Если по морозильникам выдача стабильнее показывает отдельные специализированные услуги — появляется аргумент для разделения.
Именно поэтому число кластеров не является показателем качества работы.
Если Hard превратил 5 000 запросов в 4 300 будущих страниц, не нужно немедленно нанимать сорок копирайтеров. Возможно, алгоритм просто настроен так строго, что боится поселить рядом даже близких родственников.
Регион и поисковая система тоже участвуют в решении
SERP-кластеризация всегда привязана к конкретной выдаче.
Topvisor позволяет выбирать поисковую систему, язык и регион именно поэтому. (topvisor.com)
Допустим, у вас сайт электрика в Перми.
Если кластеризацию выполнить по Яндексу для Москвы, сервис действительно что-то посчитает.
Только ваш бизнес к этой выдаче отношения почти не имеет.
По двум одинаковым фразам Яндекс и Google тоже могут показывать разный набор страниц.
Поэтому для российского проекта обычно логично анализировать ту поисковую систему и тот регион, откуда нужен основной трафик. Для федерального сайта можно сравнивать несколько срезов, но это уже увеличивает стоимость работы.
Если нужно понять, как анализировать поисковую выдачу перед объединением запросов, на сайте есть отдельный практический материал по SERP.
Topvisor
Topvisor — хороший пример понятной модели оплаты: подписка необязательна, а сама кластеризация оплачивается за запрос.
На 14 октября 2026 года:
| Тариф | Подписка | Кластеризация одного запроса |
|---|---|---|
| XS | 0 ₽ | 0,30 ₽ |
| S | 999 ₽/мес. | 0,27 ₽ |
| M | 2 990 ₽/мес. | 0,255 ₽ |
| L | 9 990 ₽/мес. | 0,24 ₽ |
| XL | 29 990 ₽/мес. | 0,21 ₽ |
Повторно изменить метод и степень в течение установленного периода значительно дешевле: базовая перегруппировка начинается с 0,001 ₽ на запрос.
Это удобно, потому что нормальная кластеризация редко получается по принципу:
нажал один раз и больше никогда не открыл результат.
Плюсы
Topvisor хорошо подходит, если нужна классическая SERP-кластеризация без обязательного дорогого входного тарифа. Можно выбрать Яндекс или Google, регион, Hard/Soft и степень группировки. Частотность используется для выбора главной фразы кластера.
Минусы
При больших объёмах операция уже стоит заметных денег.
10 000 запросов на XS:
около 3 000 ₽ только за первичную кластеризацию.
А если исходный массив на треть состоит из мусора, вы буквально заплатили тысячу рублей за аккуратную сортировку того, что можно было удалить до запуска.
Rush Analytics
Rush Analytics тоже строит кластеры по пересечению TOP-10 Яндекса или Google.
Здесь экономика устроена иначе: покупается тариф с внутренними лимитами.
На дату проверки:
| Тариф | Помесячно |
|---|---|
| Lite | 500 ₽ |
| Start | 999 ₽ |
| Pro | 3 499 ₽ |
| Team | 10 999 ₽ |
| Corp | 49 999 ₽ |
При годовой оплате часть тарифов дешевле. Кластеризация стоит 0,35 лимита на один запрос, а сам сервис поясняет, что лимит является внутренним эквивалентом рубля.
То есть операционно:
1 000 запросов ≈ 350 лимитов;
10 000 ≈ 3 500 лимитов.
Но реальная возможность загрузить такой объём зависит ещё и от ограничений конкретного тарифа на строки семантики.
Плюсы
Если Rush уже используется для Wordstat, подсказок, позиций и другой работы с семантикой, держать дополнительный сервис только для кластеризации нет большой необходимости.
Минусы
Для владельца бизнеса модель менее прозрачна: нужно понимать одновременно стоимость тарифа, количество лимитов и ограничения по объёму отчётов.
ARSENKIN TOOLS
ARSENKIN TOOLS интересен именно невысокой операционной стоимостью при регулярной работе.
Текущие тарифы:
- Базовый — 990 ₽/мес.;
- Стандарт — 2 490 ₽;
- Корпоративный — 7 990 ₽.
Стоимость одного внутреннего лимита составляет соответственно примерно 0,035 ₽, 0,029 ₽ и 0,023 ₽. Для большой кластеризации сервис списывает 1,5 лимита за запрос и позволяет в зависимости от тарифа обрабатывать до 10 000, 30 000 или 70 000 фраз.
В пересчёте сама операция получается примерно:
- 0,0525 ₽/запрос на базовом;
- 0,0435 ₽ на стандартном;
- 0,0345 ₽ на корпоративном,
плюс стоимость подписки.
Плюсы
На больших регулярных объёмах стоимость одной операции получается низкой. Есть большой набор дополнительных SEO-инструментов.
Минусы
Для разовой кластеризации из 500 запросов покупать месячный тариф только ради этой задачи уже не так интересно.
JustMagic
JustMagic использует ещё одну модель: тариф определяет стоимость каждой операции.
Кластеризатор сейчас стоит:
| Тариф | Цена за фразу |
|---|---|
| «Пацак» | 1,50 ₽ |
| «Чатланин» | 0,30 ₽ |
| «Эцилопп» | 0,25 ₽ |
| «Жёлтые штаны» | 0,20 ₽ |
| «Малиновые штаны» | 0,10 ₽ |
Подписки стоят от бесплатного уровня до 10 000 ₽ в месяц; один чатл или лимит соответствует одному рублю. Сам сервис приводит пример: 5 000 фраз на тарифе «Чатланин» обходятся в 1 500 лимитов/чатлов.
Кроме кластеризации в системе есть тематический классификатор, расширение семантики, маркеры и другие инструменты.
Плюсы
Можно построить довольно сложный workflow вокруг семантики, а на больших тарифах цена за фразу заметно снижается.
Минусы
Для человека, который впервые пришёл просто разбить 800 запросов, модель с чатлами, лимитами и названиями жителей Плюка потребует несколько минут привыкания. Хотя, возможно, это самая честная подготовка к миру SEO: если вы разобрались с тарифом «Малиновые штаны», Hard и Soft уже не испугают.
SearchLab
SearchLab интересен тем, что позволяет выбирать:
- Hard;
- Soft;
- маркерную кластеризацию;
- TOP-10 или TOP-30;
- дополнительные данные по интентам;
- тематике;
- коммерциализации;
- позициям домена.
Для простой кластеризации базовая стоимость составляет 1 лимит за один запрос. На базовом тарифе лимит стоит 1 ₽, с подписками цена снижается — примерно от 0,30 до 0,08 ₽ в зависимости от уровня. Дополнительные опции добавляют от 0,1 до 2 лимитов на запрос.
То есть стоимость 10 000 запросов может различаться в разы в зависимости от тарифа и того, нужен ли вам просто кластер или одновременно определение интента, тематики и релевантных страниц.
Плюсы
Гибкая аналитика и интересный маркерный режим для уже существующего сайта. Можно не только получить группы, но и дополнительно исследовать характер выдачи.
Минусы
Чем больше включено дополнительных данных, тем сложнее и дороже операция. Для простой задачи часть возможностей будет лишней.
Coolakov
Coolakov — противоположность большим SEO-комбайнам.
Здесь всё проще:
до 10 запросов — бесплатно;
дальше — 0,20 ₽ за запрос;
до 10 000 фраз за один запуск.
Повторная кластеризация того же ядра бесплатна. Подписки нет.
Это хороший вариант для ситуации:
У меня 700 запросов, мне нужно один раз нормально их разбить, а не покупать корпоративную аналитическую платформу и заводить отдел SEO.
700 запросов обойдутся примерно в 140 ₽.
10 000 — примерно в 2 000 ₽.
Плюсы
Простая экономика и минимум лишних сущностей.
Минусы
Меньше дополнительных инструментов и автоматизации вокруг большого постоянного процесса.
Key Collector
Key Collector отличается от большинства предыдущих решений уже самой моделью.
Это программа для компьютера, а не SaaS-кнопка «загрузить CSV — получить группы».
Первая бессрочная лицензия сейчас стоит:
2 200 ₽ для физического лица
или:
2 300 ₽ для организации.
Программа позволяет работать с большими семантическими массивами и использовать разные варианты группировки.
Главный плюс здесь не в том, что одна конкретная кластеризация стоит дешевле.
Вы покупаете рабочий инструмент для постоянной обработки семантики.
При этом общая себестоимость сложного парсинга может зависеть от выбранных источников данных, прокси, API и других компонентов вашей схемы.
Кому подходит
Специалисту или команде, которые регулярно собирают и перерабатывают большие ядра и хотят больше контроля над собственным процессом.
Для владельца сайта, который раз в год кластеризует 2 000 запросов, desktop-программа может оказаться сложнее, чем обычный онлайн-сервис.
Сравнение инструментов
Цены зафиксированы на 14 октября 2026 года.
| Инструмент | Основной подход | Минимальный вход | Стоимость операции | Что важно учитывать |
|---|---|---|---|---|
| Topvisor | SERP Hard/Soft | 0 ₽ | 0,21–0,30 ₽/запрос | подписка даёт скидку |
| Rush Analytics | SERP | от 500 ₽/мес. | 0,35 лимита/запрос | лимиты и ограничения тарифа |
| ARSENKIN | SERP | от 990 ₽/мес. | 1,5 лимита/запрос | очень низкая операция + подписка |
| JustMagic | SERP/семантика | есть free | 0,10–1,50 ₽/запрос | цена сильно зависит от тарифа |
| SearchLab | Hard/Soft/Marker | есть базовый | от 1 лимита/запрос | доп. аналитика увеличивает цену |
| Coolakov | SERP | 10 фраз бесплатно | 0,20 ₽/запрос | без подписки |
| Key Collector | разные методы | 2 200 ₽ разово | зависит от workflow | desktop-инструмент |
| ChatGPT | смысл/интент | есть бесплатный доступ | нет отдельной цены SERP за запрос | не является классическим SERP-кластеризатором |
ChatGPT доступен в бесплатной и платных версиях, умеет работать в том числе с загруженными таблицами, CSV и XLSX, но сама подписка не покупает вам независимый массовый TOP-10 Яндекса для каждой строки
Именно поэтому строку ChatGPT нельзя честно сравнить с:
0,20 ₽ за запрос.
Это разные типы вычисления.
Сколько стоит обработать 1 000 и 10 000 запросов
Чтобы почувствовать масштаб, возьмём только простые операции без дополнительных данных.
Topvisor XS
1 000 × 0,30 ₽ = 300 ₽.
10 000 × 0,30 ₽ = 3 000 ₽.
На XL операция дешевле — 0,21 ₽, но сама подписка стоит 29 990 ₽ в месяц, поэтому покупать её исключительно ради одного небольшого ядра очевидно бессмысленно.
Coolakov
1 000 × 0,20 ₽ = 200 ₽.
10 000 × 0,20 ₽ = 2 000 ₽.
Rush Analytics
Операционно 0,35 лимита за запрос:
1 000 = 350 лимитов;
10 000 = 3 500 лимитов.
Но нужно учитывать подписку и объём строк, разрешённый тарифом.
Почему на 100 000 запросов арифметика меняется
Можно умножить цену на сто тысяч и получить красивое число.
Но на таком объёме намного важнее становятся:
- максимальный размер задания;
- API;
- скорость;
- тариф;
- возможность перекластеризации;
- автоматическая обработка результата;
- время специалиста после получения групп.
Если алгоритм разложил 100 000 запросов за 20 000 ₽, а человек потом две недели исправляет получившиеся группы, стоимость самого кластеризатора была далеко не главным расходом.
Может ли ChatGPT кластеризовать запросы
Да.
И на небольших ядрах — иногда очень хорошо.
Вы можете загрузить таблицу и попросить:
разделить запросы по пользовательской задаче, не смешивать информационные и коммерческие формулировки, отдельно выделить бренды и географию.
ChatGPT способен быстро увидеть смысловые связи, которые плохо определяются простым совпадением слов.
Например:
мастер по холодильникам
сервис холодильников
починить холодильник на дому
легко объединяются как одна потребность.
В этом AI действительно силён.
Но дальше начинается самое интересное.
Почему смысловой близости недостаточно
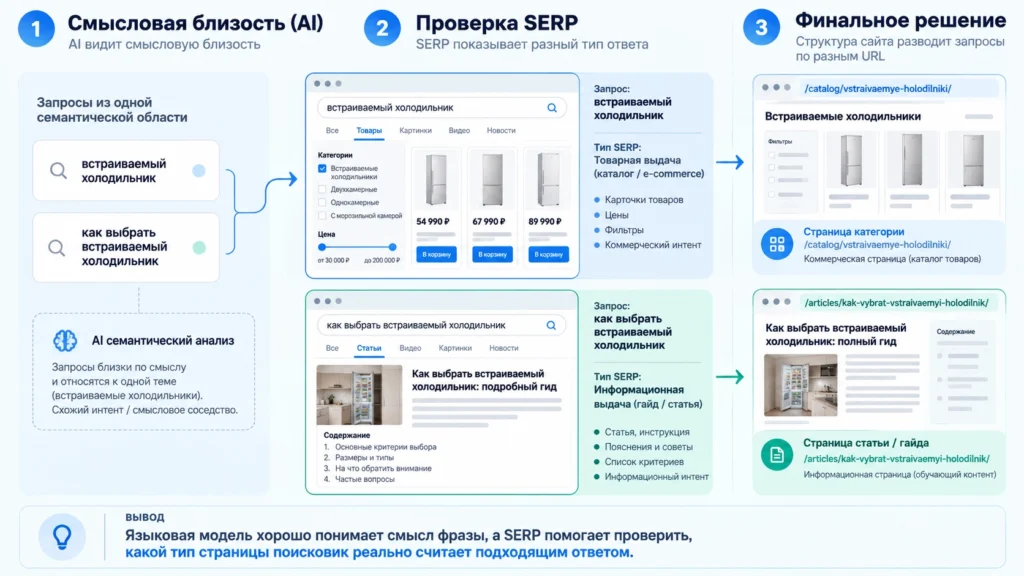
Возьмём:
купить холодильник
и:
какой холодильник купить.
Для языковой модели эти фразы почти родственники.
Объект один.
Покупка одна.
Слова похожи.
Но человек в первом случае уже ищет место, где можно выбрать товар и заплатить.
Во втором он пока решает:
- нужен ли No Frost;
- какой объём камеры;
- какой бренд;
- какой размер влезет на кухню.
Один уже достал банковскую карту.
Второй пока достал рулетку.
Поэтому первый запрос логично ожидать на странице категории магазина.
Второй — в хорошем руководстве по выбору.
Если SERP подтверждает это различие, объединять их на одну страницу только потому, что ChatGPT правильно понял тему, нельзя.
Что ChatGPT делает особенно хорошо
Самая интересная роль ChatGPT находится даже не в финальной кластеризации.
Это предварительная обработка.
Представим, что у нас есть 20 000 фраз для магазина холодильников.
AI может помочь отметить:
- чужие бренды;
- ненужные города;
- ремонтный спрос;
- вакансии;
- инструкции;
- информационные вопросы;
- товарные запросы;
- очевидные дубли;
- подозрительные строки для ручной проверки.
После этого вместо 20 000 запросов в платную SERP-кластеризацию уйдут, например, 12 500.
Мы не только сэкономили деньги.
Мы ещё и повысили качество исходного массива.
Это хороший пример применения нейросети: не заставлять её изображать поисковую систему, а дать задачу, которую она действительно умеет выполнять.
Можно ли очистить семантику через ChatGPT полностью автоматически
Я бы не стал.
Потому что один и тот же запрос имеет разную ценность для разных бизнесов.
Возьмём:
как заменить розетку самому.
Для сайта электрика это может быть хорошая информационная статья, которая в конце объясняет, когда самостоятельный ремонт опасен.
Для магазина электротоваров это инструкция, которая приводит потенциального покупателя инструментов и розеток.
Для лендинга:
Срочный вызов электрика
эта фраза вообще может не быть нужна в коммерческом ядре.
Ни одна языковая модель не угадает вашу бизнес-стратегию из двух колонок Excel, если вы ей её не объяснили.
AI очень хорошо масштабирует заданную логику.
Если логика плохая, он просто масштабирует плохое решение намного быстрее человека.
Лучший вариант — не ChatGPT против SERP, а ChatGPT вместе с SERP
Я бы строил процесс так.
Сначала человек определяет бизнес
Что продаём?
Где?
Кому?
Какие типы страниц уже существуют?
Затем ChatGPT помогает очистить массив
Убираем очевидно чужую тематику и предварительно размечаем:
- коммерческое;
- информационное;
- бренд;
- географию;
- товары;
- услуги.
Очевидные группы объединяются без дорогого SERP-анализа
Например:
ремонт холодильника на дому
мастер по ремонту холодильников
починить холодильник
можно предварительно держать рядом.
Спорные группы отправляются на SERP
Например:
ремонт холодильника
и
ремонт морозильника.
Или:
купить диван
и:
диваны цены.
Смотрим, насколько совпадают результаты и тип страниц.
После этого человек принимает архитектурное решение
Не:
сервис дал кластер №381, значит создаём URL.
А:
эта группа действительно представляет отдельную задачу пользователя, под неё нужна отдельная страница.
Вот это уже полноценная SEO-работа.
Сама по себе кластеризация ещё ничего не продвигает: можно идеально разложить 20 000 запросов по группам и оставить получившийся Excel лежать рядом с прошлогодним аудитом. Практическая ценность появляется только тогда, когда из кластеров формируется структура сайта, запросы распределяются по существующим и новым страницам, устраняется каннибализация, а изменения действительно внедряются и проверяются в поиске. Поэтому в рамках SEO-продвижения сайтов мы рассматриваем семантику и кластеризацию не как отдельный отчёт, а как один этап общего цикла: подтверждённый спрос → структура → посадочные страницы → техническое внедрение → контроль индексации, видимости и трафика.
Почему существующий сайт кластеризуют иначе, чем новый
На новом сайте можно проектировать структуру практически с нуля.
На работающем уже есть страницы, которые:
- получают позиции;
- имеют ссылки;
- накапливают историю;
- получают трафик.
Поэтому нельзя просто взять новое ядро, прогнать кластеризатор и создать новый URL под каждый полученный кластер.
Сначала нужно проверить существующие страницы.
Topvisor, например, отдельно поддерживает группировку по релевантным или целевым URL и рекомендует её именно для проектов с уже сформированной структурой.
Rush Analytics тоже умеет определять релевантный URL сайта после кластеризации.
Иначе можно получить очень странный результат:
у сайта уже есть сильная страница:
/remont-holodilnikov/
по которой идут показы и заявки.
Новый кластеризатор обнаруживает пять близких групп.
Команда создаёт ещё:
/remont-holodilnika/
/master-holodilnikov/
/pochinit-holodilnik/
/remont-na-domu/
Вместо развития одной страницы сайт получил маленький семейный конфликт из пяти URL.
Как плохая кластеризация создаёт каннибализацию
Каннибализация возникает не потому, что два текста случайно используют одинаковое слово.
Проблема начинается, когда несколько URL фактически претендуют на одну и ту же пользовательскую задачу.
Например:
замена розетки
поменять розетку
электрик замена розетки
разделили на три кластера.
Под каждый сделали страницу.
Теперь поисковику нужно выбирать между тремя почти одинаковыми услугами.
Это классический пример, когда автоматизация ускорила не SEO, а производство проблемы.
Подробно о том, как возникает каннибализация запросов и как проверить конфликт страниц по реальным данным, у нас есть отдельный материал.
Что лучше для сайта услуг
Для услуг я бы начинал с более осторожной кластеризации.
Почему?
Потому что количество реально нужных коммерческих страниц обычно ограничено.
Допустим, электрик делает:
- замену розеток;
- замену проводки;
- установку автоматов;
- подключение электроплиты.
Это действительно четыре разные услуги.
Но:
замена розетки
поменять розетку
замена розетки цена
электрик поменять розетку
не обязаны становиться четырьмя страницами.
Поэтому Hard или достаточно строгий порог часто удобен для первичного анализа, но результат всё равно проверяется вручную.
Что лучше интернет-магазину
В магазине семантики значительно больше.
Например:
диван
угловой диван
серый угловой диван
серый угловой диван 200 см
серый угловой диван раскладной
Если слишком строго разделить всё по SERP, можно получить тысячи категорий, где в каждой лежит по два товара.
Это уже не полезная архитектура, а каталог, переживший нервный срыв.
Для e-commerce мягкая или маркерная кластеризация может быть удобнее, особенно если уже известна структура категорий и фильтров.
SearchLab прямо рекомендует Soft для больших объёмов семантики интернет-магазинов, а маркерную кластеризацию — для распределения запросов вокруг заранее определённых групп и URL.
Что лучше информационному сайту
У статьи обычно есть возможность закрывать довольно широкий набор близких формулировок.
Например, один материал:
«Почему холодильник не морозит и что можно проверить самостоятельно»
может отвечать одновременно на:
почему холодильник не морозит
холодильник работает но не охлаждает
почему в холодильнике тепло
холодильник перестал холодить причины.
Создавать отдельную статью под каждую фразу не нужно.
Поэтому для информационного сайта слишком строгая кластеризация особенно опасна: она легко превращает тематический раздел в сотни тонких материалов.
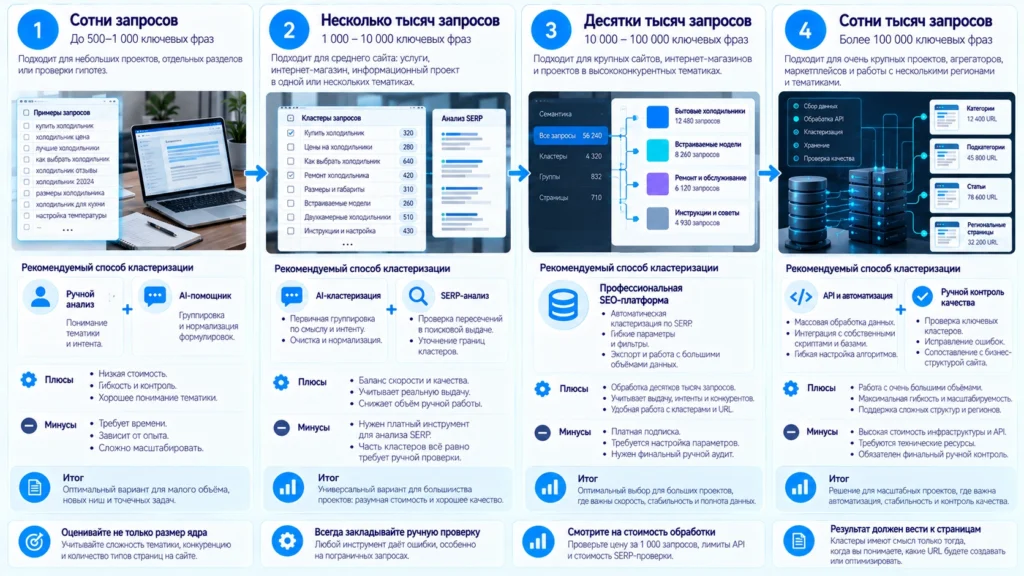
Какой инструмент выбрать по объёму ядра
До 300–500 запросов
Начал бы вообще не с покупки сервиса.
Нормально работают:
человек + ChatGPT + ручная SERP-проверка спорных групп.
При таком объёме вы ещё способны прочитать ядро целиком.
500–5 000 запросов
Оптимальный сценарий:
очистка через AI/таблицу → простой SERP-кластеризатор → ручная проверка.
Здесь подойдут Topvisor, Coolakov, SearchLab или другой удобный инструмент.
5 000–30 000
Уже важны:
- стоимость за операцию;
- лимиты;
- повторная кластеризация;
- работа с существующими URL;
- выгрузка;
- история.
Именно здесь сильнее проявляются Rush, Arsenkin, Topvisor, SearchLab, JustMagic.
30 000–100 000+
Это уже практически производственный процесс.
Нужны:
- API;
- автоматическая очистка;
- хранилище;
- пакетная обработка;
- собственные правила;
- контроль качества.
На таком объёме вопрос:
какой сервис дешевле на пять копеек?
уже менее важен, чем:
сколько часов человека понадобится после получения результата.
Можно ли просто выбрать самый дешёвый сервис
Можно, если задача простая.
Но цена одного запроса не рассказывает всей истории.
Например, сервис А стоит:
0,20 ₽.
Сервис Б:
0,30 ₽.
На 10 000 запросов разница:
1 000 ₽.
Если сервис Б позволяет за минуту бесплатно или почти бесплатно перегруппировать ядро, сохранить нужный регион, связать запросы с существующими URL и выгрузить удобный отчёт, тысяча рублей может легко окупиться одним часом специалиста.
С другой стороны, если вам нужно один раз разбить 600 запросов, нет смысла покупать профессиональную подписку за несколько тысяч рублей только потому, что внутри ещё есть двадцать функций, которыми никто не воспользуется.
Выбираем не самый дорогой и не самый дешёвый инструмент.
Выбираем тот, который соответствует процессу.
Как понять, что кластеризация получилась нормальной
Я бы не смотрел на красивое число:
Получено 742 кластера.
Это ничего не говорит о качестве.
Хороший результат можно проверить семью вопросами.
Понятна ли задача каждой группы
Вы должны за несколько секунд понять, что хочет пользователь.
Например:
замена розетки → заказать услугу.
как заменить розетку → получить инструкцию.
Соответствует ли группе один разумный тип страницы
Не должно получаться, что половина кластера хочет купить холодильник, а половина — узнать, почему старый холодильник шумит.
Не появились ли почти одинаковые кластеры
Если рядом лежат:
ремонт холодильника
и:
починить холодильник
с отдельными будущими URL — результат нужно перепроверить.
Не объединились ли очевидно разные задачи
купить диван
и:
как выбрать диван
тематически близки, но цель пользователя может различаться.
Проверены ли спорные группы по выдаче
Особенно коммерческие.
Учтены ли уже существующие страницы
Нельзя проектировать новый сайт поверх работающего сайта так, будто его URL не существуют.
Может ли нормальный человек понять структуру
Это прекрасный финальный тест.
Если SEO-специалист показывает владельцу структуру:
Ремонт холодильников → Ремонт холодильника → Мастер холодильников → Починить холодильник
и потом десять минут объясняет, почему это четыре разные страницы, возможно, проблема не в том, что владелец ничего не понимает в SEO.
Нужно ли перекластеризовать ядро каждый месяц
Нет.
Если бизнес и структура сайта не менялись, заново гонять десятки тысяч запросов каждый месяц обычно бессмысленно.
Но пересмотр полезен, когда:
- появилась новая услуга;
- расширился ассортимент;
- изменился регион;
- появился новый заметный спрос;
- сайт сильно перестроили;
- выдача изменилась;
- появились данные о новых реальных запросах.
Большую семантику также полезно периодически расширять и перепроверять, потому что поисковый спрос меняется.
При этом совершенно не обязательно каждый раз уничтожать старую структуру и строить новую.
Чаще добавляются новые группы и пересматриваются спорные зоны.
Что в итоге выбрать
Если семантика небольшая, платить за промышленную автоматизацию не нужно. Нормальный человек, таблица, ChatGPT и ручная проверка SERP вполне способны решить задачу.
На нескольких тысячах запросов уже выгоднее использовать готовый SERP-кластеризатор. Topvisor и Coolakov дают понятную оплату за запрос; Rush, Arsenkin, SearchLab и JustMagic становятся интереснее, если кластеризация является частью постоянной SEO-работы и нужны другие инструменты вокруг неё.
Key Collector имеет смысл, когда семантика — регулярный рабочий процесс, а не разовая операция.
ChatGPT я бы вообще не ставил в один ряд с SERP-кластеризаторами как прямого конкурента.
Его сильная сторона другая.
Он прекрасно помогает:
- чистить массив;
- понимать смысл;
- определять предварительный интент;
- находить странные строки;
- называть группы;
- проверять готовую структуру.
Но поисковая выдача отвечает на отдельный вопрос:
какие страницы поисковик реально считает подходящими по этим запросам сейчас?
Поэтому наиболее устойчивый рабочий процесс выглядит так:
человек понимает бизнес → AI очищает и предварительно группирует → SERP проверяет спорные решения → человек утверждает структуру.
Кластеризатор в этой цепочке не является архитектором сайта.
Скорее это очень быстрый инженер-геодезист: он приносит измерения и показывает, какие участки похожи друг на друга.
Если после этого построить по отдельному дому на каждой отметке, виноват уже не геодезист.
Практика
Как кластеризовать семантику без лишних страниц и расходов
Очистите исходные запросы
Удалите дубли, ненужную географию, чужие товары и бренды, случайные подсказки и запросы, которые не соответствуют бизнесу.
Разделите семантику по крупным задачам
Отдельно соберите товары, услуги, информационные вопросы, бренды и другие крупные направления, чтобы кластеризатор не сравнивал между собой очевидно разные задачи.
Предварительно сгруппируйте смысл
Очевидные синонимы и близкие формулировки можно объединить вручную или с помощью ChatGPT, не оплачивая для каждого простого случая отдельный анализ поисковой выдачи.
Проверьте спорные группы по SERP
Для запросов, где непонятно, нужна одна страница или несколько, сравните результаты Яндекса или Google в нужном регионе.
Сопоставьте кластеры со страницами
Для каждой группы определите существующий или будущий URL и тип страницы: услуга, категория, карточка товара или статья.
Проверьте результат вручную
Убедитесь, что автоматическая кластеризация не создала десятки почти одинаковых страниц и не объединила коммерческий и информационный спрос только из-за похожих слов.
FAQ
Как выбрать инструмент для кластеризации запросов
Универсального лучшего сервиса нет. Если нужно разово обработать небольшое ядро, достаточно простого сервиса с оплатой за запрос. Для регулярной SEO-работы удобнее платформы, где вместе с кластеризацией доступны частотность, позиции и анализ SERP. На больших объёмах значение имеют API, стоимость операции, лимиты и возможность повторной кластеризации.
Частично. ChatGPT хорошо понимает смысл запросов, помогает чистить семантику, определять предполагаемый интент и собирать предварительные группы. Но смысловая близость не гарантирует, что поисковая система показывает по двум запросам одинаковые типы страниц. Для спорных коммерческих групп полезно дополнительно сравнивать реальную SERP.
Hard требует более жёсткого совпадения выдачи и обычно создаёт больше небольших групп. Soft допускает более свободные связи и формирует крупные кластеры. Для услуг строгая группировка часто удобнее как стартовая точка, а для большого интернет-магазина чрезмерно строгий Hard способен создать тысячи почти одинаковых групп. Финальное решение всё равно нужно проверять по смыслу и SERP.
Нет. Сначала нужно удалить нерелевантные запросы и разделить семантику на рабочие сегменты. Если из 20 000 собранных фраз бизнесу реально относятся 12 000, нет смысла оплачивать SERP-анализ оставшихся 8 000 только для того, чтобы получить красивые папки с мусором.
Простые онлайн-сервисы обычно считают стоимость за каждый запрос или внутренний лимит. Например, у Topvisor базовая операция стоит 0,30 ₽ за запрос, у Coolakov — 0,20 ₽. В других системах цена зависит от подписки и внутренней стоимости лимита, поэтому для больших объёмов нужно считать не только цену одной операции, но и обязательный тариф.
Рейтинг статьи
Материал был полезен?
Оценка помогает понимать, какие материалы стоит обновлять и расширять.